Repository navigation

Replies: 6 comments 4 replies

|
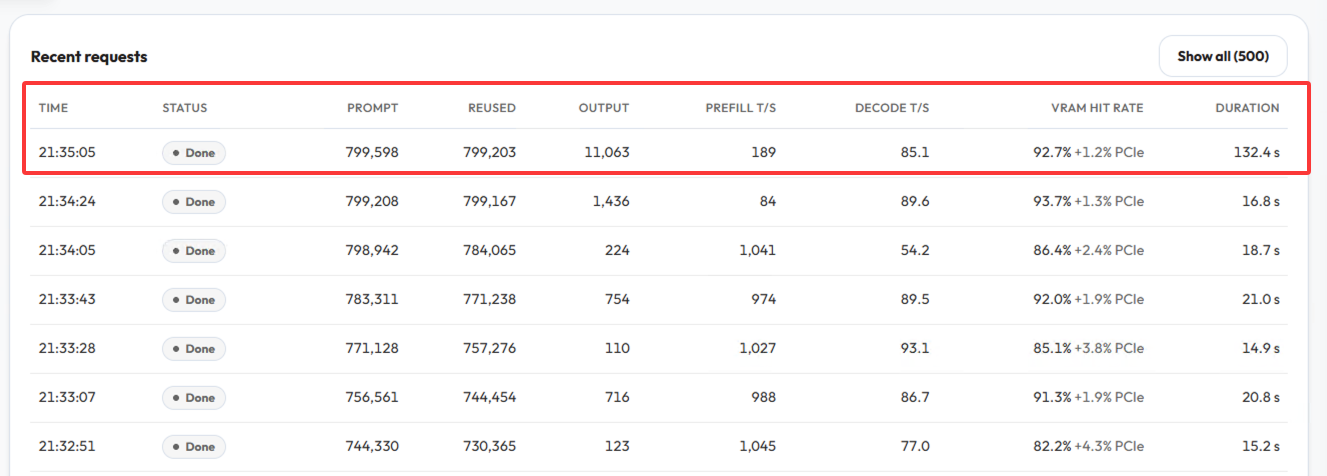
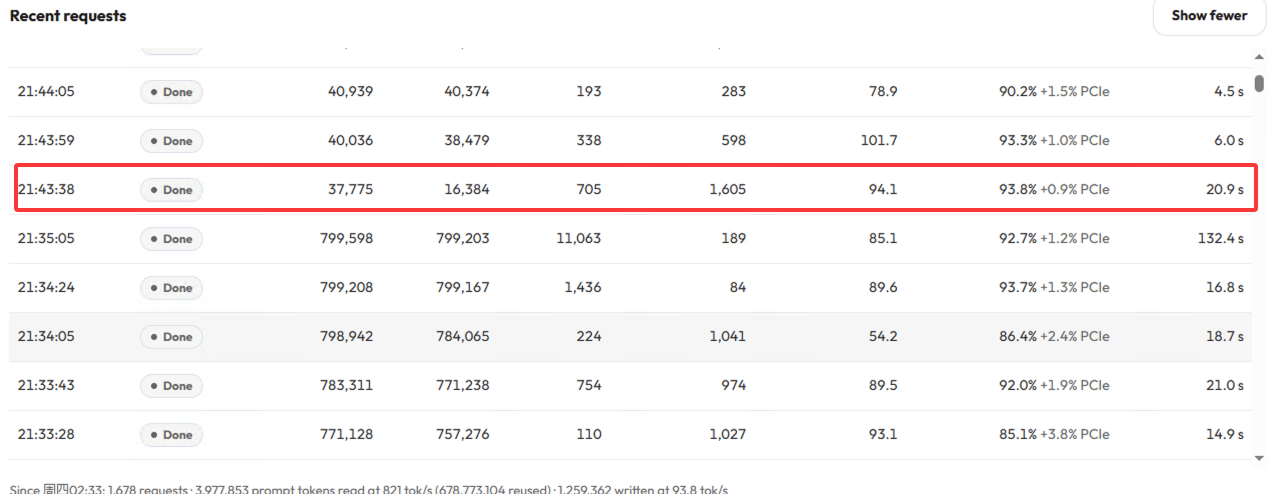
上面反映的是在这种超大上下文的压缩中,自动压缩死循环的概率很高。刚刚又遇到了一次。死循环一个小时还没有恢复过来。大模型一直预填充,持续的解码压缩。 现在要补充的是。自动压缩单次的成本和手动压缩的成本完全不一致。 下图是一个手动压缩的成本,一次性到位。 从使用体感上来讲。手动压缩对于上下文是灾难性的毁灭。(不确定是否是每次都这样)。但是速度很快。模型一次性处理完。 |
|
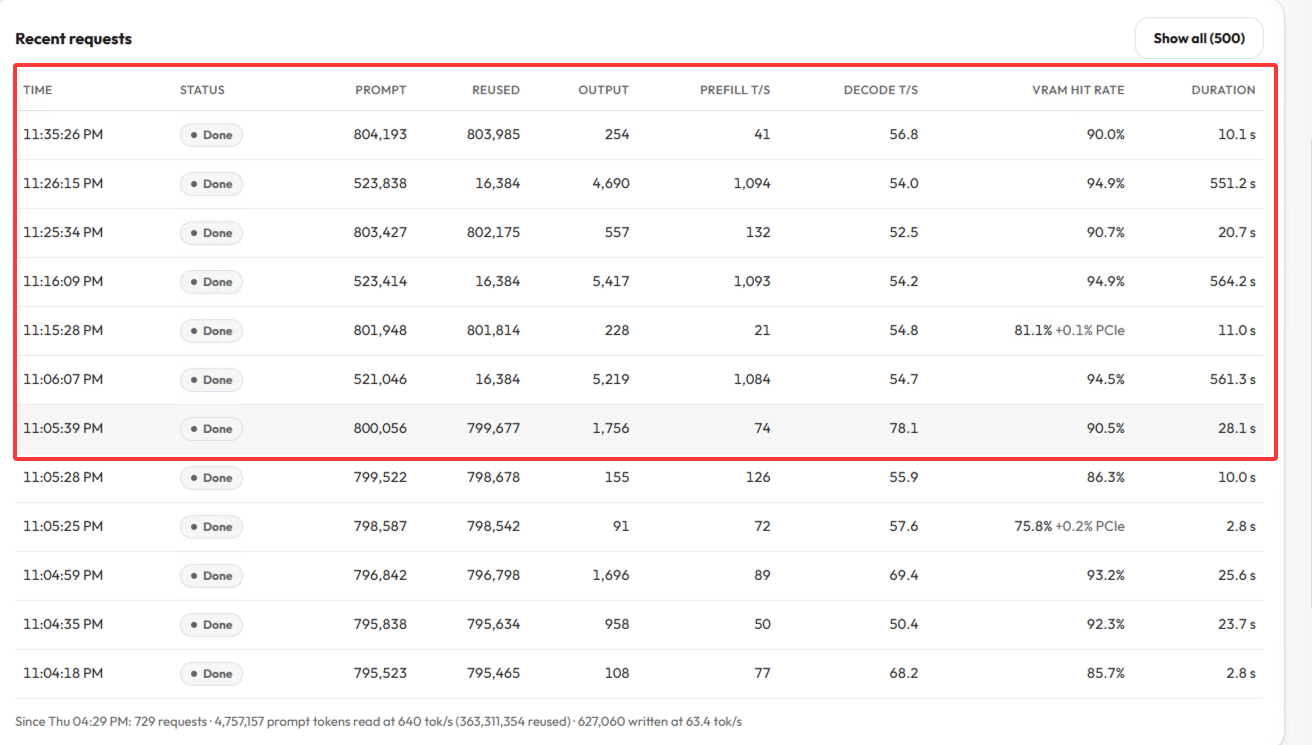
死循环的出现几乎不可避免。 |

|
之前我遇到过死循环遍历文件17个小时。。。还是dsh 自己的文件 |

|
如果人不干预的话,那就会一直死循环下去。比如说我们睡觉了,那他可能一晚上都在那死循环。我现在看到这里,只不过是因为刚好我在。 |
|
我们自建服务器还好。如果说是调用云端api 的话。嗯,第2天看到账单就哭了。一直死循环全量跑冷启动的预填充。没有命中缓存,贼贵。 |
一次成功的自动压缩会有多次重读的Bug。但是他为什么会有两次全量重读? |
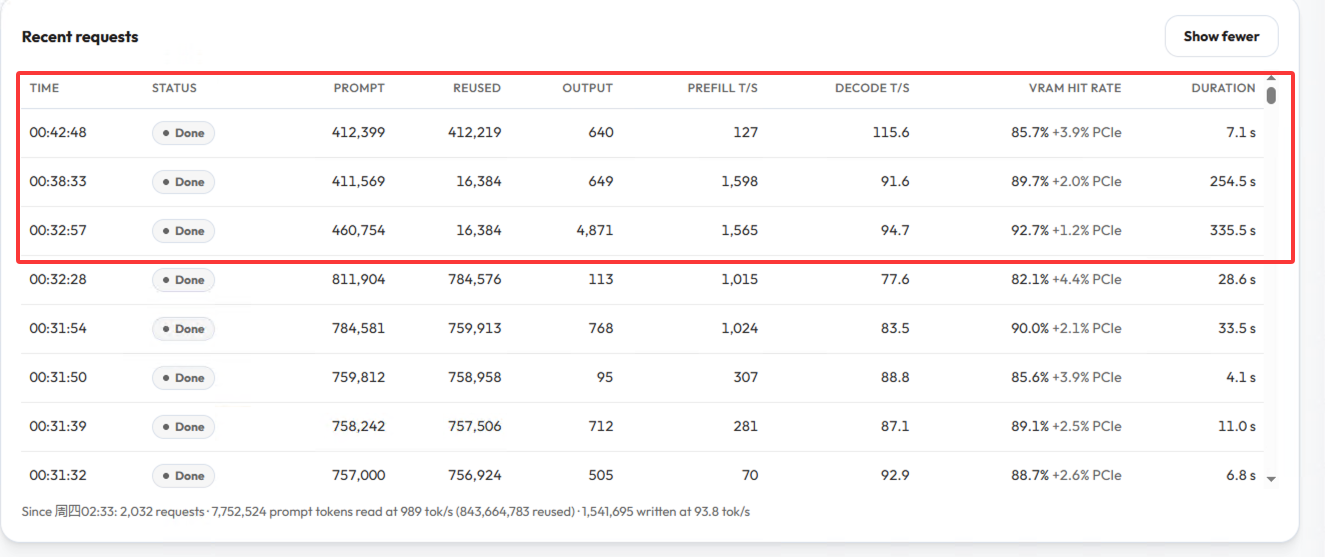
实测超长上下文剪枝操作净亏损对于另外一个问题。在这种超长上下文当中。对工具输出的剪枝操作,可以确定的是净亏损。之前可以观察到在压缩前会有剪枝动作。总共去除掉十几二十K的上下文。但触发一次全量重读。即便是512K上下文,重读一次也是三分钟起步。到了100万上下文,重读一次,基本上就是5分钟起步。在这种量级的软件开发场景下没有存在的意义。 当然可能是因为我个人部署的服务器。预填充速度平均在1500tS。云端API处理速度足够快。时间感受可能没有那么明显。但是一次全量重读的API费用也不低。 建议官方评估它的实际价值和意义。或者给出关闭的方法。 |

|
那两条 509K 的请求是压缩摘要请求,"只复用 16K"是因为摘要之前修剪器先改写了历史。 先把形状对上
// :344-349
// Once pressure qualifies, land the model-free pass before choosing a
// summary range, then remeasure through the singleton replay fold.
if (prune !== undefined) {
  prune.pruneSession(agent.session)
  measurement = meter.measure(agent.session, header)
}
也就是:先对 tool result 做一次无模型修剪,再选要摘要的区间,再把这段重放给模型。你日志里那条 509K / reused=16,384 的请求就是后面这一步——16K 大致就是系统提示 + 工具定义那部分前缀,剩下的全要重读。 为什么 KV 缓存没了 同一文件
但修剪动作发生在它之前,重放的历史已经和 provider 缓存里的那份不同——从第一个被改写的 tool result 起,后面全部作废。注释里的意图被前面的修剪抵消了。(这和 #10573 那位报的是同一处。) "水位不下降"是另一回事 压缩后会保留一个尾部( 你可以自证的两条
修法形状:修剪只作用于保留的尾部,被摘要的区间保持逐字节不变;或者把修剪挪到摘要之后。前者是 #10573 那位的补丁思路。 只读了 master |
|
你不要开玩笑哟。我发的服务器的日志是连续的。两条日志中间隔了几分钟的原因,就是因为这一次全量读入就要花那么长的时间。怎么可能是正常的对话涨上去的。 |
初步怀疑是在框架压缩的时候Agent又发了一条正常请求覆盖了压缩数据怀疑第2次请求是在压缩之前就已经准备好数据了。 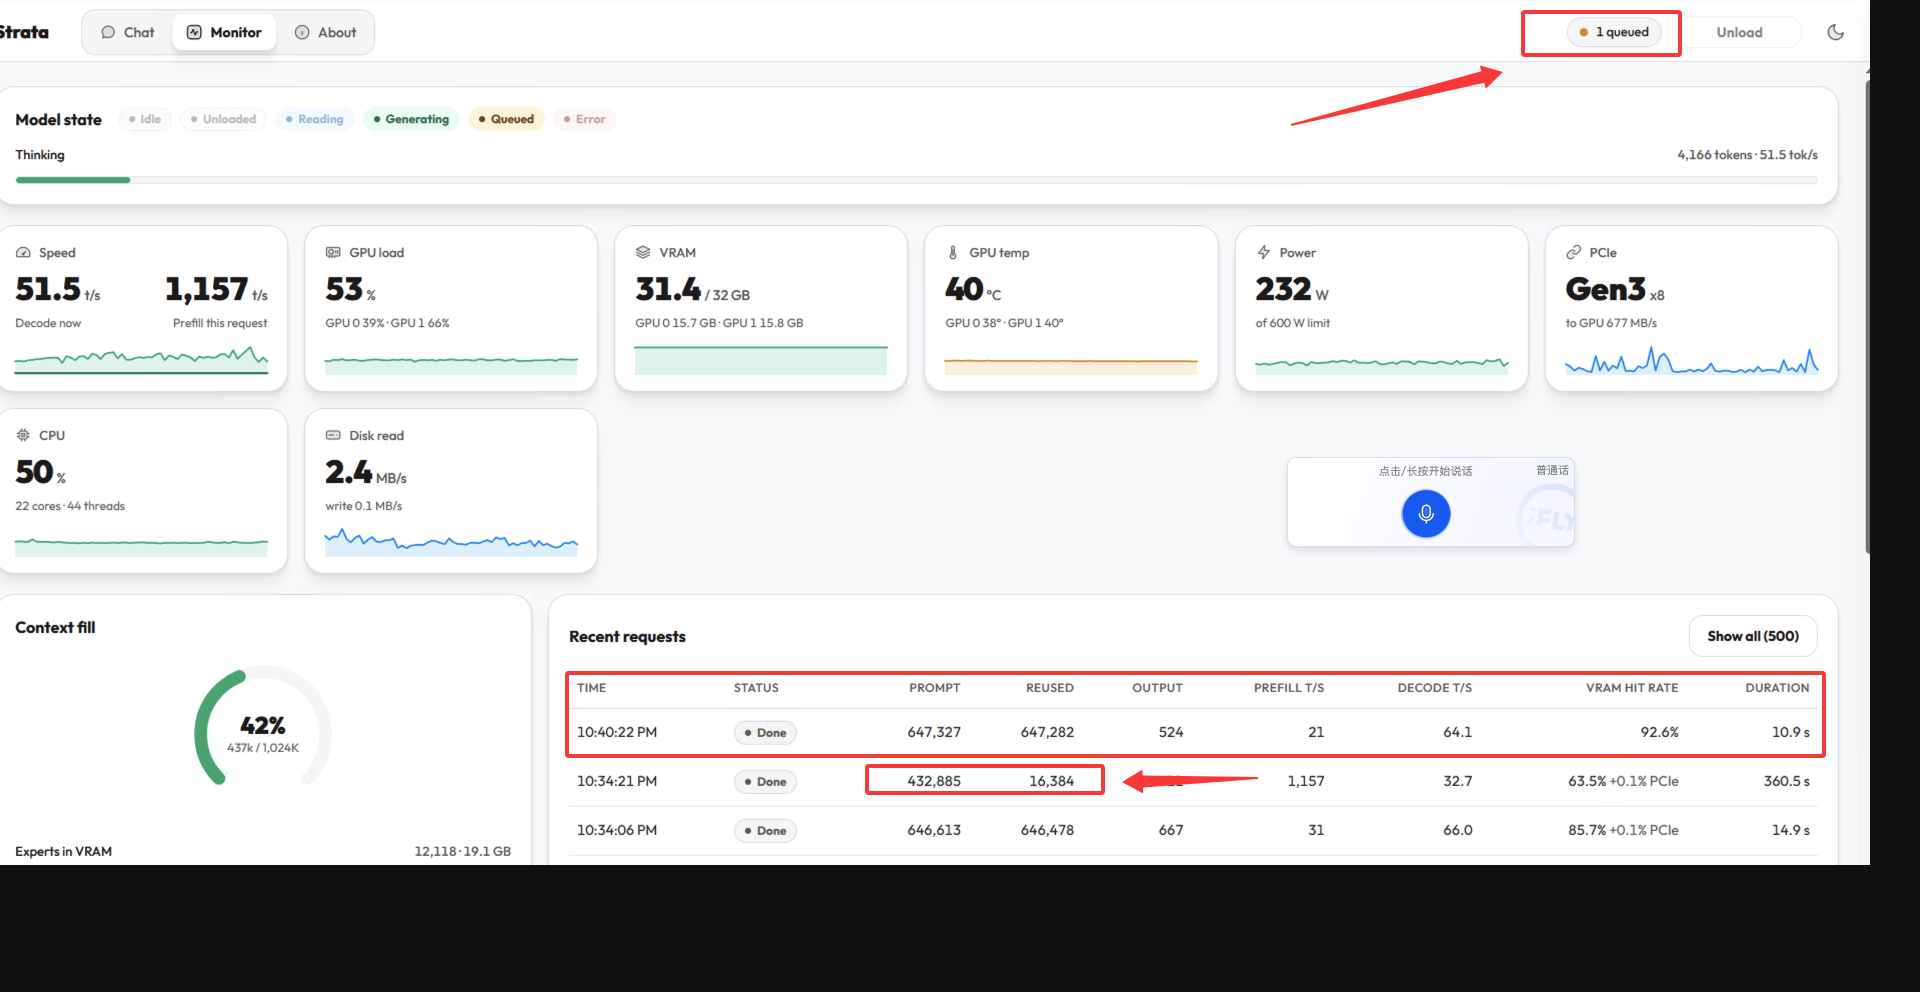
512K上下文也会出现死循环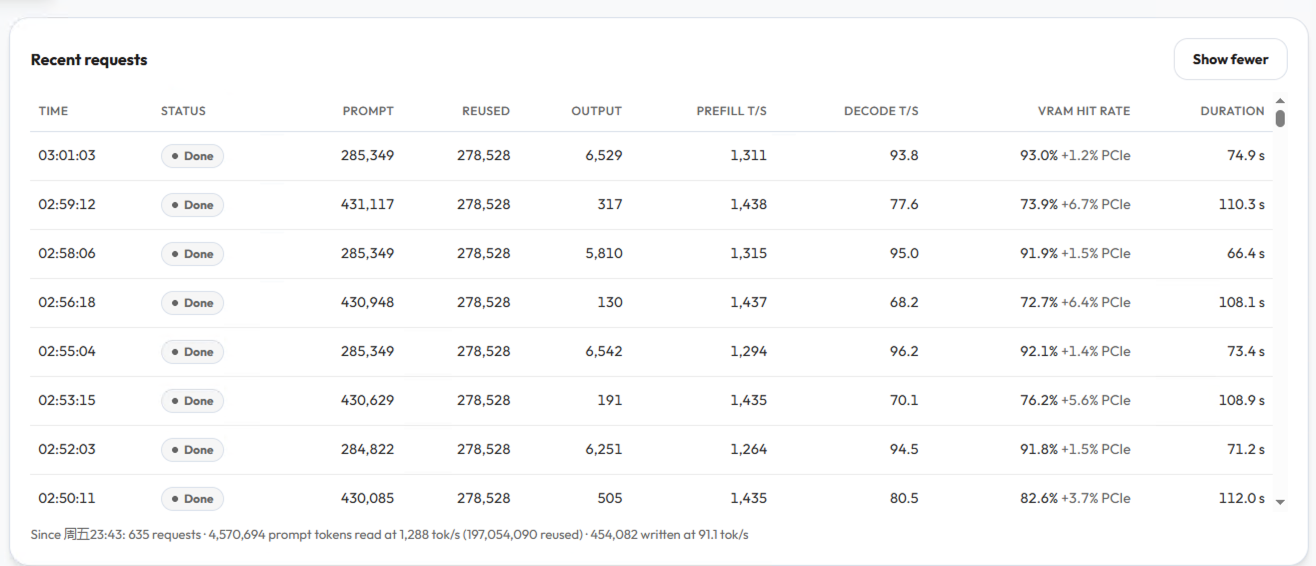
|


Uh oh!
There was an error while loading. Please reload this page.
Uh oh!
There was an error while loading. Please reload this page.
环境
qwen3.8-flash-next-iq3_xxs,contextWindow: 1048576context: 1048576、kv: k8v4、kv_resident: 20480、version: 0.1.56)status = Done,全部正常输出(459–6,586 token),decode 57.9–92.4 t/s,无 503、无空回复、无超时、无卡死。现象
Monitor → Recent requests(时间 21:32–21:44,约 12 分钟内的 6 条):我们的观察(只描述数据形状,不判根因)
reused出现的值是 16,384 / 507,904 / 800,577,都是 16,384 的整数倍 —— 引擎的 prompt 缓存 checkpoint 粒度就是 16,384 token(--prompt-cache-every默认值),说明这些请求的前缀与已缓存的历史对不齐,只命中一个 checkpoint;contextWindow × 0.8(1,048,576 → 838,912),那么 800K 水位不应触发压缩;数据里压缩类请求确实在 800K 水位下反复发生。期望官方排查的方向(不替官方下结论)
请检查客户端上下文管理这条链路的:① 压缩触发条件与水位判定;② 压缩产物是否被采纳进后续 prompt;③ 是否对同一份素材反复发起压缩;④ 压缩请求的 prompt 组装方式(是否导致服务端缓存无法复用,从而每次数十万 token 全量重读)。
附注
Monitor → Recent requests(Show all (500)面板);VRAM free长期在几十 MiB 量级,KV streaming命中率 88–92%,PCIe流送 1.4–4.0%(这是速度背景,不是本 issue 的诉求)。All reactions