Repository navigation
求助怎么配置MinerU3.4.5版本,能够ocr识别专利文件的时候,过滤掉行号 #5725

Replies: 2 comments 1 reply

|
3.4.5 的公开 CLI 参数里没有“过滤专利行号”的专用开关,不能靠一个配置项直接解决。该版本 Hybrid 后处理会把 针对你描述的版面,建议采用下面的定制处理,而不是在最终 Markdown 中直接删除数字:
附件链接这边未能读取,所以还不能确认你的样本属于哪一种。可以补充当前解析命令,以及一个包含行号的 To reply, just mention @dosu. Docs are dead. Just use Dosu.
|



|
高導電性·高強度銅合金_JP1983021014B2_middle.json |

|
这份 JSON 确认属于“行号已经混入正文”的情况,不能按独立数字框过滤。例如第 1 页 建议把处理前移到识别之前:
不建议对 Markdown 全局删除 另外,这份产物末尾记录的是 To reply, just mention @dosu. Share context across your team and agents. Try Dosu.
|


Uh oh!
There was an error while loading. Please reload this page.
专利文件会有行号的标识,如果ocr不进行过滤直接识别,会产生大量的脏数据,求助怎么配置能够避免?
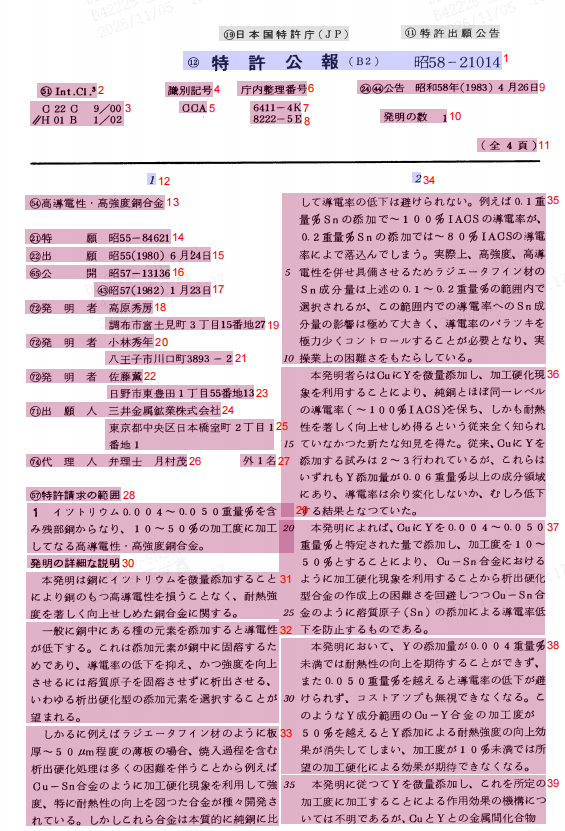
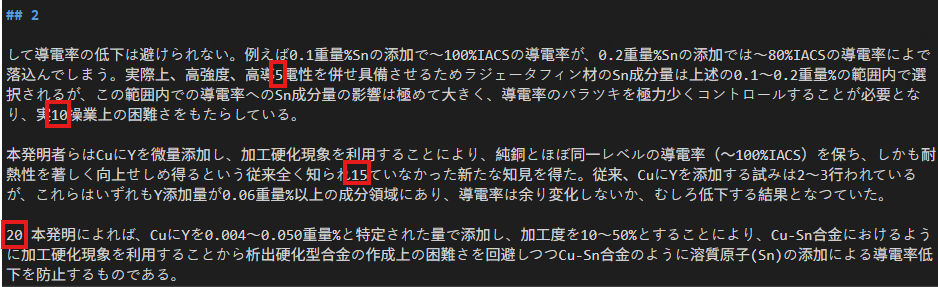
下面是MinerU3.4.5版本的版面分析结果,35、36、37、38、39块左侧的数字如:5、10、15、20、25、30、35是行号
识别的结果md文件如下所示
下面这个是原始文件
高導電性·高強度銅合金_JP1983021014B2_layout.pdf
All reactions