Repository navigation
03 Tester
Chaque niveau de test répond à une question différente.
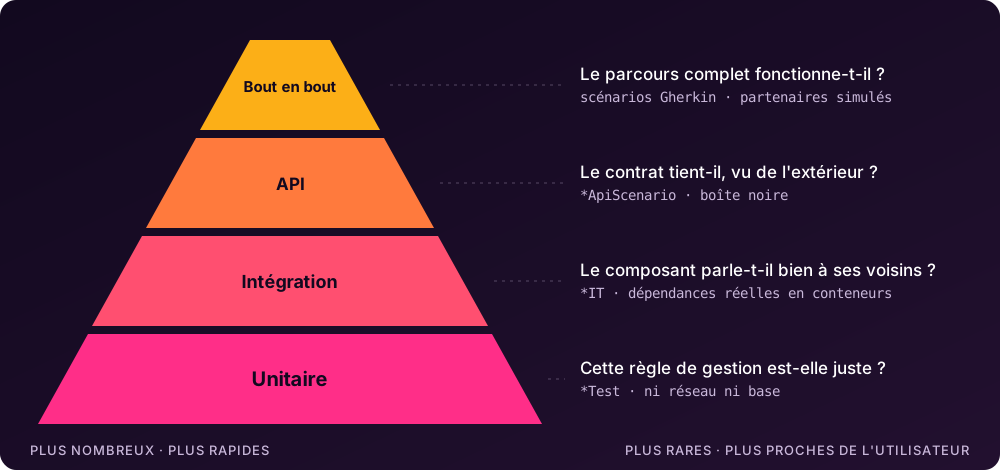
On écrit des tests pour pouvoir changer le code sans peur. Tout le reste est secondaire. Un test qui casse à chaque refactoring alors que rien n'a changé pour l'utilisateur produit l'effet inverse : il rend le changement pénible, et l'équipe finit par le désactiver.
La pyramide n'est pas une esthétique. C'est une question de coût. Un test unitaire s'exécute en quelques millisecondes et pointe la ligne fautive. Un test de bout en bout prend des minutes, dépend de plusieurs systèmes, et quand il échoue, il faut une demi-heure pour comprendre pourquoi. On veut beaucoup des premiers et peu des seconds.
La bonne question n'est pas « qu'est-ce que je teste ? » mais « qu'est-ce que je veux prouver ? ».
| Je veux prouver que... | Niveau |
|---|---|
| le calcul des frais respecte la grille tarifaire | unitaire |
| la requête SQL renvoie les bonnes lignes sur une vraie base | intégration |
| un message mal formé reçu de la file est rejeté proprement | intégration |
| l'endpoint de création renvoie 201 et la ressource se relit | API |
| le contrat JSON n'a pas changé pour l'application mobile | API |
| un client peut s'inscrire, commander et recevoir sa confirmation | bout en bout |
Quand on hésite entre deux niveaux, on prend le plus bas qui suffit à prouver la chose.
Les conventions *Test, *IT et *ApiScenario ne sont pas décoratives. Elles permettent à l'outil de construction de lancer chaque famille au bon moment : les unitaires à chaque compilation, l'intégration et l'API dans une phase dédiée, avec leurs dépendances démarrées.
Un piège que j'ai vu coûter cher : dans l'écosystème Maven, le plugin qui lance les tests unitaires ignore par défaut les classes nommées *IT. Si personne n'a configuré le plugin chargé des tests d'intégration, ces tests compilent, apparaissent dans l'IDE, passent quand on les lance à la main... et ne s'exécutent jamais en CI. Pendant des mois, une équipe peut croire disposer d'un filet qui n'existe pas. La vérification est simple : compter les tests exécutés dans le rapport de CI, et comparer avec ce qu'on croit avoir.
Un test d'API se comporte comme un client. Il n'importe aucune classe interne, ne lit pas la base pour vérifier son résultat, ne déclenche pas une méthode privée par réflexion. Il appelle l'API, lit la réponse, rappelle l'API pour vérifier l'état.
Scénario: Création d'une carte virtuelle
  Étant donné un client inscrit par l'API d'inscription
  Quand il demande une carte virtuelle
  Alors la réponse est 201
  Et la carte apparaît dans la liste de ses cartes avec le statut "active"
La récompense est considérable : on peut réécrire tout l'intérieur du service, changer de base de données, changer de framework, et ces tests restent valables. C'est exactement ce dont on a besoin pour migrer.
Un test crée ce dont il a besoin par les mêmes chemins qu'un vrai client : il inscrit son utilisateur, crée sa commande, puis vérifie. Pas de script SQL qui remplit la base avant la suite de tests.
Pourquoi tant d'insistance ? Parce qu'un jeu de données partagé couple des tests qui devraient s'ignorer. Le jour où quelqu'un modifie une ligne pour son test, trois autres cassent, dans un autre module, sans rapport apparent. Et parce que ce jeu de données finit toujours par décrire un état que le système réel ne peut plus produire.
Quand la création par l'API est trop lente ou impossible (un partenaire externe, par exemple), on simule le partenaire, pas les données.
Le test reçoit son environnement par configuration : URL, identifiants, adresse du simulateur. Il ne contient aucun if (environnement == recette). La même suite tourne sur le poste du développeur, en CI et contre l'environnement de recette. Si elle ne passe qu'à un seul endroit, c'est le test qui est faux, ou l'environnement, et dans les deux cas on veut le savoir.
La couverture indique les zones que rien ne touche. Elle ne dit pas si ce qui est touché est bien vérifié : un test sans assertion fait monter la couverture. Je l'utilise pour trouver les angles morts, et je ne fixe jamais d'objectif chiffré, parce qu'un objectif chiffré produit des tests écrits pour le chiffre.
- La CI met plus de vingt minutes, et l'équipe relance les tests « pour voir s'ils passent cette fois ».
- Des tests sont marqués
@Disableddepuis des mois. - Un refactoring sans changement fonctionnel casse des dizaines de tests.
- Personne ne sait dire combien de tests d'intégration tournent réellement en CI.
- Les tests de bout en bout sont plus nombreux que les tests d'API.
« Sans TDD, on finit toujours par écrire les tests après coup, ou jamais. » Le risque est réel. Ma réponse n'est pas d'imposer l'ordre, c'est d'imposer le résultat : pas de fusion sans tests au bon niveau, et pas de correctif sans le test qui aurait attrapé le bug. Certains écrivent le test d'abord, d'autres ensuite. Je juge ce qui arrive en revue.
« Les tests en boîte noire sont plus lents que les tests unitaires. » Oui, c'est pourquoi il y en a moins. Ils ne remplacent pas les tests unitaires, ils prouvent autre chose : que le contrat tient.
« Créer toutes les données par l'API, c'est trop long à écrire. » Les premières fois. Ensuite, on factorise des étapes réutilisables (« un client inscrit », « une commande payée ») et les nouveaux tests s'écrivent en quelques lignes.
- Mike Cohn, Succeeding with Agile, Addison-Wesley, 2009 (origine de la pyramide).
- Michael Feathers, Working Effectively with Legacy Code, Prentice Hall, 2004.
- Martin Fowler, « The Practical Test Pyramid » (Ham Vocke), sur martinfowler.com.
- Google, Software Engineering at Google, chapitres 11 à 14, O'Reilly, 2020.