Repository navigation
Home
Welcome to the tony_cat wiki!
It is a cpp server framework.
build with asio, protobuf, tinyxml2, glog.
and include a excel to xml/cpp code tool.
一个服务器框架主要基于c++20,使用各种新特性。
C++代码的依赖库目前有:
asio网络库
protobuf协议库
fmt字符串格式化库
rocksdb/mysql 其中之一服务数据持久化,若使用如mysql需要启用外部服务。
glog日志库
tinyxml2解析xml配置库。
使用python3的脚本进行配置文件代码生成,需要安装openpyxl模块使用。
这里以游戏业务为示例。早期的游戏设计思路是玩家是一个类,它有加经验,完成任务,成就以及一系列逻辑方法,这是一个很经典的传统对象"Is A"的设计思路。但是在游戏业务中各个业务有极强的相互逻辑依赖,容易造成逻辑代码混在一起,并且难以整理和分离。
现代软件工程演变,组合>继承。基类的概念设计不应该过多,在业务复杂多变的情况下,继承层次过深、继承关系过于复杂时会影响到代码的可读性和可维护性。代码的封装性并不一定需要通过继承来体现,反而继承设计容易在后续维护中,造成状态变量依赖不明显,或类的变量与其他不相干的类耦合获取/修改。在很多业务在多变的情况下,导致新类在不断继承父类后,出现了一个四不像的类,难以理解,并且在数据状态逻辑大量关联情况下难以层次化调用关系。在稳定的非业务性接口上可以考虑些继承设计。
在类的设计过程中,要注意到概念的抽象和复用性。抽象层次多了,虽然看上去耦合性很低,但会导致类之间的关系复杂,架构学习成本高。抽象层次少了,容易造成逻辑重复,代码冗余。两者都会引起开发效率降低。设计的类概念相当于整个软件项目产生知识的广度,每个系统包含的组合成员和依赖相当于相当于整个软件项目中单个系统概念知识的深度,我们要做的是如何使两者的乘机最小,达到软件最低复杂度。
我们希望在类的设计时,尽可能保证各个类单向依赖,这样使得UML图简洁直观,逻辑上也清晰易懂。
一个类处理的事情量适当。这里指的是逻辑量,一个类做的事情太少会造成类过多;太多会导致长时间下去业务很难做到低耦合,代码维护困难。
一个类的抽象定义能是有利于人理解的概念。这样会便于更简单的学习和使用,在维护和扩展时,不会过分思考和纠结我我需要在哪个类扩展接口,我需要依赖哪些类需要在哪里找。
代码组织上贴合KISS(Keep It Simple, Stupid 即简单且愚蠢)原则 。多用组合的方式来组织逻辑,在后续开发维护过程中避免深层次的继承来防止概念复杂化。每一个对外业务载体都是一个实体,每个实体又由一个或多个组件构成,每个组件仅仅包含代表其特性的数据,在组件中没有任何方法,组件承载单类业务组织的数据状态,方法是在系统里实现和调用。这样比较贴合程序开发思维,代码里造成相互引用和调用比较少,易于理清类之间的依存关系,方便管理。尤其在业务复杂的情况下,大部分数据相互耦合,方法和数据不分离开来容易造成多个类之间的相互依赖和复杂的调用链,复杂的类之间的复合相互调用使会得类关系不清晰。这有些像ECS系统模型,Entity-Component-System(实体-组件-系统)。这样可以清晰化数据控制和依赖,类和系统更多按照对产品的需求划分而减少对计算机底层机理概念去贴合设计,是整个项目易于管控和学习上手。在游戏服务器中,实体类型比较少,一般也就RoleEntity,BattleRoomEntity,DungeonEntity, SceneEntity,这几类。比如RoleEntity,里面放着MissionAsset,BasePropertyAsset,AchievementAsset。实施逻辑类和状态分离,逻辑系统去与需求打交道(包括外部功能需求和内部逻辑抽象),数据类去与语言特性打交道。
lambda/协程简化异步逻辑开发,异步 查询逻辑提供相应的接口,做到低耦合,逻辑不被割裂。lambda好处,不需要对函数调用返回做侵入。协程好处,设计得当,不用考虑闭包指针的生命周期,for循环异步好写(当然lambda也可以封装个SingalAwait类)。
玩家单人逻辑同时只有一个线程处理,串行化处理,多玩家之间共享数据放在第三类服务器中完成。微服务虽然可以做的更好的故障隔离,但对于单用户业务线复杂的逻辑做跨节点的事务性编写复杂,影响开发效率。对于多人交互性的跨节点服务,可以采用分布式事务如TTC解决方案。
核心问题的考虑:
CS架构中,客户端和服务器的状态同步问题,实时性,一致性。战斗中全局时钟,状态一致性。影子系统处理客户端延时下的表现和体验问题。
优化问题排查流程,如何方便的查找线上问题。
限流,服务器负荷满造成奇怪的现象或集群雪崩。
消息队列,透明化处理单元,增加消息服务器产生的运维成本。
社交逻辑,分布式事务一致性问题,幻读如何解决,服务器之间的消息,重试+幂等。
故障处理,产生节点崩溃或网络分区如何故障恢复,服务器之间的一致性和可用性取舍。
服务治理,集群监控方案,方便的部署流程。
在这里我们用module(这里参考的nginx的module)管理各个子系统。把不同的业务放在不同的module去处理。注意要严格划分module的依赖关系和层级,一级module有log module,net module,二级module有 rpc module, db module 等等,三级module以上为业务逻辑层次的module。低层次module不能依赖高层次module,严格管理各个子系统的依赖关系,避免出现整个程序变成网状依赖关系,避免调用关系混乱难以理解和维护。
XXXModule继承于ModuleBase,ModuleBase提供虚方法,这些模块和虚方法由ModuleManager管理和调用。
设计为 BeforeXXX ,OnXXX,AfterXXX 是为了解决不同模块间的初始化顺序依赖问题。
virtual void BeforeInit() {};
virtual void OnInit() {};
virtual void AfterInit() {};

virtual void BeforeStop() {};
virtual void OnStop() {};
virtual void AfterStop() {};

virtual void BeforeUpdate() {};
virtual void OnUpdate() {};

virtual void OnLoadConfig() {};
virtual void AfterLoadConfig() {};
使用自己的Module时需要在ServerApp类内去注册到ModuleManager内。由ModuleManager调用。在初始化时,首先通过REGISTER_MODULE去注册各个模块,注意各个模块的注册顺序,注册的顺序决定的模块被调用的顺序。被依赖的模块在前面注册,如公用的LogModule最先注册,NetPbModule依赖NetModule, 所以先注册NetModule,再注册NetPbModule。RpcModule又依赖于NetPbModule中的protobuf协议解析,所以RpcModule放在NetPbModule之后注册。
在初始化时会以BeforeInit,OnInit,AfterInit顺序进行调用,主要是用来进行模块自身初始化,如网络连接,rocksdb/mysql,redis初始化,注册玩家事件监听函数等等。
然后会调用OnLoadConfig 和 AfterLoadConfig,可以进行读取配置并转换为模块自身逻辑形式,配置的逻辑安全检测。在热更新配置时(使用USR1信号或通过gm服务去做热更新配置)也会调用OnLoadConfig 和 AfterLoadConfig。
在进程接下来运行时,会以帧的形式定期执行BeforeUpdate和OnUpdate,目前写死20帧每50毫秒一次,后面可以改成读配置修改。这个帧Update主要是做服务器自身做缓存优化和一些逻辑处理需要,如减少系统调用,AI行为驱动,玩家数据修改的持久化做批量提交。
通用配置放在XmlConfigModule,网络处理放在NetModule,日志放在LogModule处理,网络协议处理放在 NetPbModule / NetHttpModule,rpc请求放在RpcModule处理,数据库访问有RedisModule/MysqlModule/RocksDBModule。注意,除特殊的LogModule提供日志接口比较特殊,其他的模块均没有使用单例,方便多实例扩展。
服务器正常shutdown时会以注册顺序的反序,调用BeforeStop,OnStop,AfterStop。需要处理如日志的持久化,DB modify的同步,网络包的发送和断开连接,以及各个资源的释放。
在业务逻辑方面,如玩家登陆登出心跳重连放在 RoleControlModule,玩家等级名字等基础信息放在 RolePropertyModule处理,任务放在RoleMissionModule处理。不同的业务模块之间用RoleEventModule进行脱耦。业务模块间进行通信和触发其他业务模块的动作,如升级触发任务和解锁,任务模块和解锁模块在自己的模块初始化注册监听玩家升级事件,当然一般会有一个ConditionModule处理达成条件,如玩家等级达到,关卡达成之类的。
类的定义内,使用 XXXModule* m_pXXXModule = nullptr; 定义,头文件使用前置声明解决头文件相互依赖问题和优化编译效率。
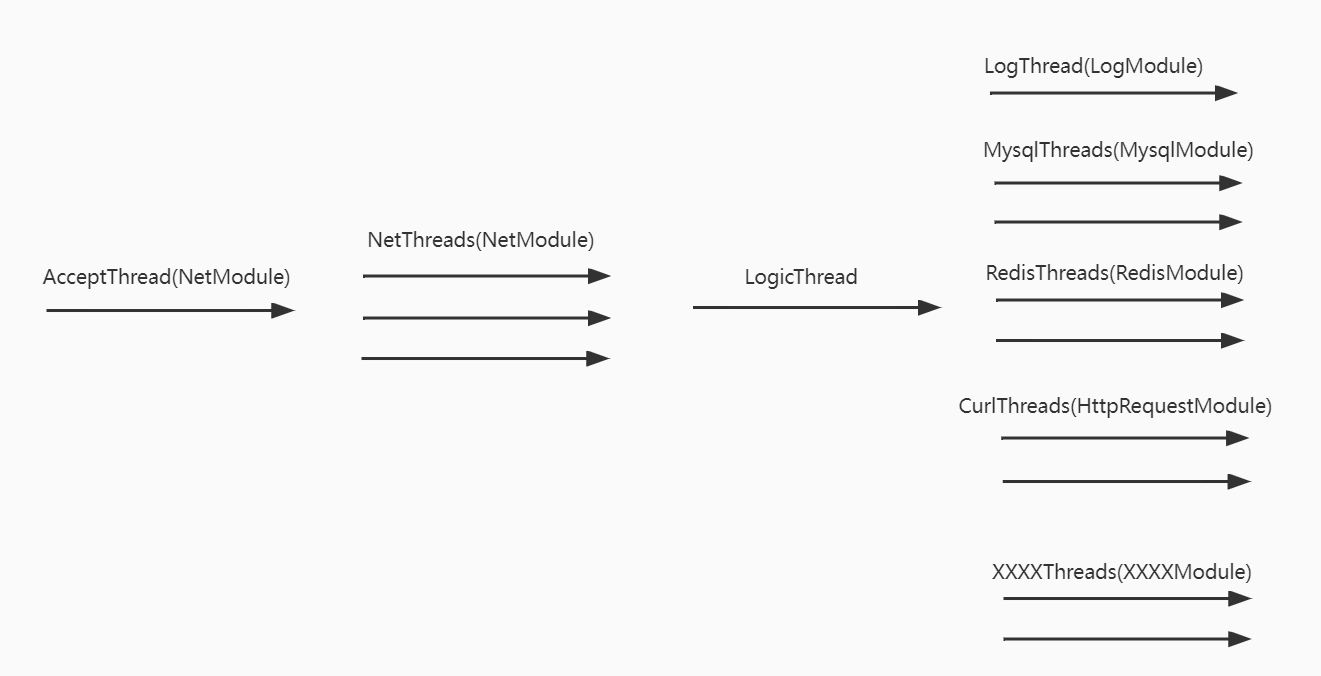
根据经验,一般服务器的场景,控制逻辑一般业务复杂,但执行时间不长,很多业务比如压缩,网络收发,其他io操作耗时长,并且业务顺序依赖关系简单,可以交由子线程去处理。
简单耗时任务放在io线程+sharding,分布式一致性算法保证数据同一时刻只能在一个服务上操作。服务器能够方便的水平扩展。水平扩展后的瓶颈:不同服务交互,节点一致性名字信息同步的性能损耗会超出增加节点带来的收益。
业务逻辑:业务处理使用单线程模型,所有通过其他线程异步查询和访问逻辑的回调都会在主线程执行,在OnMessageHandle中的代码无需考虑线程安全问题,简化了逻辑代码编写。实际上主线程可以使用多线程+ThreadLocal进行逻辑编程,玩家单人线请求处理串行化,任务线程按用户id固定分配,解决时序问题。战斗服会考虑业务造成的cpu压力使用多线程业务编程。
网络处理:accept放在NetModule一个线程中处理,网络包的收发放在NetModule的线程池中处理。
数据库:RedisModule和DBModule内通过线程池处理数据库查询,使用ThreadLocal放置非线程安全数据库句柄。提供的回调查询/协程接口供业务方调用,在子线程查询完会返回到主线程给业务调用方。
线程池由各个Module管理,不需要某个服务不去注册这个Module,就不会分配相关的线程。
各个服务根据处理的业务分配线程数量。像GateServer面向客户端连接,主要瓶颈在网络处理,一般需要4-16个网络线程,LogicServer瓶颈在CPU,一般需要2-4个网络线程就够了。DBServer需要多个客户端线程阻塞的来处理数据库读写,或者使用异步接口,等等。具体数值可以进行压测调优。
基础模块
LogModule
日志模块,提供日志输出接口,被其他所有模块调用。使用libfmt进行格式化处理,可以不用关心格式化参数的数据类型,使用比较方便也不容易出错,性能也比c format的格式化好不少。此库也已加入到c++20 stl 标准。
注意 LOG_FATAL 会让服务器宕机。一些服务器启动必要性的逻辑可以用这个日志。
LOG_DEBUG();
LOG_INFO();
LOG_WARN();
LOG_ERROR();
LOG_FATAL();

// for example:
std::string str;
int32_t n = 0;
uint64_t ln = 0;
std::vector<int> v = {1, 2, 3};
LOG_INFO("test log string:{}, int:{}, big int:{}, vector:{}", str, n, ln, v);
NetModule
基础网络模块,提供端口监听,网络连接管理和收发网络包的逻辑。可提供给PbNetModule,HttpNetModule,UdpNetModule使用。
NetModule使用单独一个线程去进行监听端口和accept,内部维护一个线程池,将新建立的连接与一个线程绑定起来,数据的读写,Pb协议的序列化都在这个session绑定的线程处理,这样减少了逻辑线程的CPU处理工作量。
XmlConfigModule
基础配置模块,存放其他基础模块需要的配置信息。
在tools/Excel下存放gen.sh和gen.py脚本,可通过excel生成C++解析配置代码和对应的xml文件。以ServerList为例,在ConfigModule头文件添加
DEFINE_CONFIG_DATA(ServerListConfigData, "../../config/xml/ServerList.xml");和源文件中添加代码
if (false == LoadServerListConfigData()) {
    LOG_ERROR("LoadServerListConfigData false.");
    return;
}
即可使用此配置,无需手动写配置解析代码。
excel文件定义示例:
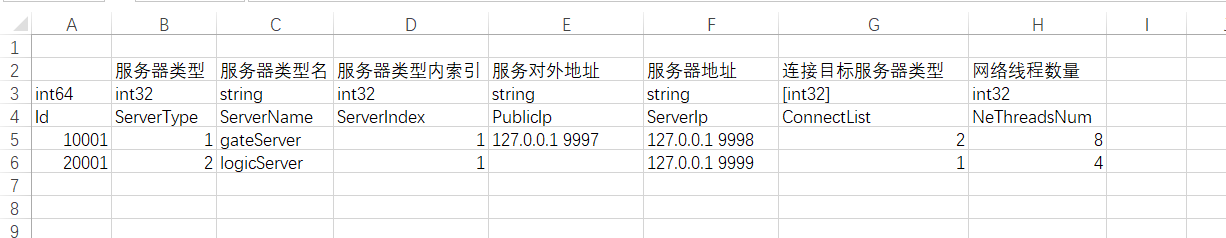
对于列而言,第一列统一名字为 Id ,并且不可重复。
第一行为空,后续可用来标识此服务器和客户端是否使用该字段。
第二行用作字段注释,对程序而言无异议。
第三行标识字段类型,目前支持的类型有:
'int32'
'int64'
'string'
'date'
'[int32]'
'[int64]'
'[string]'
'[date]'
'[{int32,int32}]'
'[{int32,int64}]'
'[{int32,string}]'
'[{int64,int32}]'
'[{int64,int64}]'
'[{int64,string}]'
'[{string,int32}]'
'[{string,int64}]'
'[{string,string}]'
基础类型有int32,int64,string,date,其中date格式为 2020-12-12 15.00.00 这样。
复合类型 [] 包裹为数组,分隔符为英文冒号 ':' ,例如 32:74:954 。
复合类型[{}]包裹为字典,元素分割符号 '|' ,key-value分隔符为 ':' ,例如a:1001|b:1002|c:1003|d:1004 。
NetPbModule
处理protobuf网络包的读写。内部主要依赖NetModule,对NetModule进行一定的封装,提供protobuf协议的封装,接收和发送。
使用Update函数去做批量提交协议包。一般业务做消息驱动时,会出现一个Request过来,服务器不仅会返回respond,还会附加一些通知消息,如抽奖可能会产生:钻石减少通知,物品变更通知,成就达成通知,如果按帧Update来处理,在Update内去处理玩家请求包,然后在发送SendPacket时加到消息发送队列中,在其他模块Update时,去一次性发送多个包,只调用一次write系统调用,优化网络性能。根据我之前的项目来看,就这一项优化可以让pps提升1.5倍+。
NetPbModule的具体protobuf协议定义见网络协议部分。
使用:
// 注册网络事件
    m_pNetPbModule->RegisterHandle(this, &ServiceGovernmentModule::OnHandleSSHeartbeatReq);

// 回包
    Pb::SSHeartbeatRsp msgHeartbeatRsp;
    m_pNetPbModule->SendPacket(sessionId, head, msgHeartbeatRsp);

// 函数原型
    // 普通回调函数
    void OnHandleSSHeartbeatReq(Session::session_id_t sessionId, Pb::ServerHead& head, Pb::SSHeartbeatReq& heartbeat);
    // 协程回调函数,注意传入参数不带引用是为了考虑传入参数生命周期问题
    CoroutineTask<void> OnHandleSSHeartbeatReq(Session::session_id_t sessionId, Pb::ServerHead head, Pb::SSHeartbeatReq heartbeat);
注意在业务逻辑代码编写的过程中,OnHandleXXX 注册事件函数内必须要看的到SendPacket返回给客户端,包含异步流程可以用匿名函数或协程,不能让逻辑散开,否则导致代码混乱并且难以维护。
SSHead 中的 trans_id,便于一个业务涉及多服务节点调用下的问题排查。
ServiceGovmentModule
此模块提供对服务器集群管理逻辑,包括一致性的命名服务,对其他服务节点的可见性,以及服务节点之间连接,重连处理。提供了查找其他服务节点的连接sessionId,来对其他服务器进行通信和请求消息。
现在先采用静态hash,后面会改成redis/zookeeper定位服务。
RpcModule
对服务器提供Rpc请求接口,可使用匿名函数/协程来访问其他节点的接口,使得逻辑处理在一个函数体内,逻辑连续清晰。使用示例:
异步接口:
    Pb::ServerHead head;
    Pb::SSHeartbeatReq heartbeat;
    heartbeat.set_req_time(time(nullptr));
    m_pRpcModule->RpcRequest(nSessionId, head, heartbeat,
      [](Session::session_id_t sessionId, Pb::ServerHead& head, Pb::SSHeartbeatRsp& heartbeat) {
        // dosomething here
        LOG_INFO("server heartbeat request success on session:{}", sessionId);
    });
协程接口:
    auto nSessionId = stServerInstanceInfo.nSessionId;
    Pb::ServerHead head;
    Pb::SSHeartbeatReq heartbeat;

    auto [nSessionIdRsp, headRsp, msgRsp] = co_await RpcModule::AwaitableRpcFetch(Pb::CSPlayerLoginRsp, nSessionId, head, req);
这里使用了C++17的结构体绑定。
服务节点模块
LogicXmlConfigModule
逻辑服务器的配置文件,实现类似于XmlConfigModule。同理还有 BattleXmlConfigModule 等等。
配置定义为excel文件,使用gen.sh和gen.py脚本生成代码和配置。
PlayerControlModule
在逻辑服务器上,处理玩家登录,重登,踢人,断线等控制逻辑。
PlayerDataModulede
包含所有获取玩家数据的接口,使用MutableXXX接口可修改数据,并且在 PlayerDataModule内会隐式做脏标记,并在Update时将更改状态通知给客户端,还有脏数据同步给DBServer,让DBServer定时存储。还有接口GetXXX只读数据。注意在业务中对其他模块的数据读取,在其他模块提供接口去调用,而不是PlayerDataModulede去调用。例如我需要获取玩家的任务完成情况,要调用m_pPlayerMissionModule->GetMissionStatus(PlayerData, missionId)获取,而不是直接访问PlayerDataModule去拿任务表里的信息。这样做的好处是,如果任务系统有改动(例如任务数据容器类型改变,链式任务只记录当前的任务),或者有隐含的其他判定逻辑(例如包含每日任务的刷新,或者限时任务的失效),不会使业务侵入到调用方。
MutableXXX如需要分级的脏标记,可返回一个代理类。
PlayerEventModule
对于不同逻辑模块相互调用,调用者不关心返回值,使用PlayerEventModule发送信号,让需要关心这个信号的模块调用m_pPlayerEventModule注册监听接口,减少模块之间的耦合。例如PlayerBasePropertyModule处理加经验和升级,如果升级,有如下代码:
EventPlayerLevelUp stEventPlayerLevelUp;
stEventPlayerLevelUp.before_level = nOldLevel;
stEventPlayerLevelUp.current_level = nNewLevel;
m_pPlayerEventModule->SendEvent(playerData, stEventPlayerLevelUp);
PlayerConditionModule
逻辑服逻辑判定模块,让各个业务逻辑脱离耦合性,减少相互调用。业务可能逻辑非常多,而且变化频繁,一般会有一个PlayerEventModule和PlayerConditionModule去处理判定逻辑,可提供给引导系统,任务系统,成就系统,活动系统,剧情系统,邮件系统,场景事件系统使用。
条件系统一般由策划去配置达成条件放在引导系统,任务系统,成就系统,活动系统等等中,这些系统可以调用条件系统的接口去解析字符串条件,然后注册条件监听回调函数,条件达成时回调函数去改变状态,向客户端发通知去同步状态。条件一般配置为:
"PlayerLevel>=5 & E RoleMood > 6"      // 玩家5级以上,并且存在角色心情值大于6
"(PlayerLevel>=10 & TaskIdFinish=100343) | (AchievementIdFinish=104534)" // 玩家10级并且100343任务完成 或者 成就104534达成
"(DungeonIdFinish=12341 | DungeonIdFinish=12342) & DungeonEvaluate >5 & Times >=3"   //玩家刷图ID 12341或 12342  评价超过5 的次数大于等于3次
有符号 !(非) , E (存在) ,A (任意) 三个修饰条件。
各个业务模块会去注册自己相关逻辑的映射数值函数,条件模块会通过条件关键字类型会去查找需要监听哪些触发事件,关系符号 = ,>,>=,< ,<= 和比较值会去查早或生成相应关系运算容器(unordered_map,map)并放入其中,在事件触发时条件模块判定达成会触发回调。
通过这个模块做到大大简化代码设计,还可以做到逻辑条件热更新。会发现在开发的中后期,大部分需求只用改配表配置的条件就能实现了。
使用的通讯协议为protobuf3,便于扩展和兼容升级。
文件放在protocol路径下。pb_gen_code.bat/pb_gen_code.sh脚本可生成协议代码。
protobuf协议的组装
网络协议按照报文包的形式进行组装,大端网络传输,转化为小端系统(服务器和桌面x86,苹果安卓arm均是小端)需要SwapUint32翻转字节。含义具体如下图:
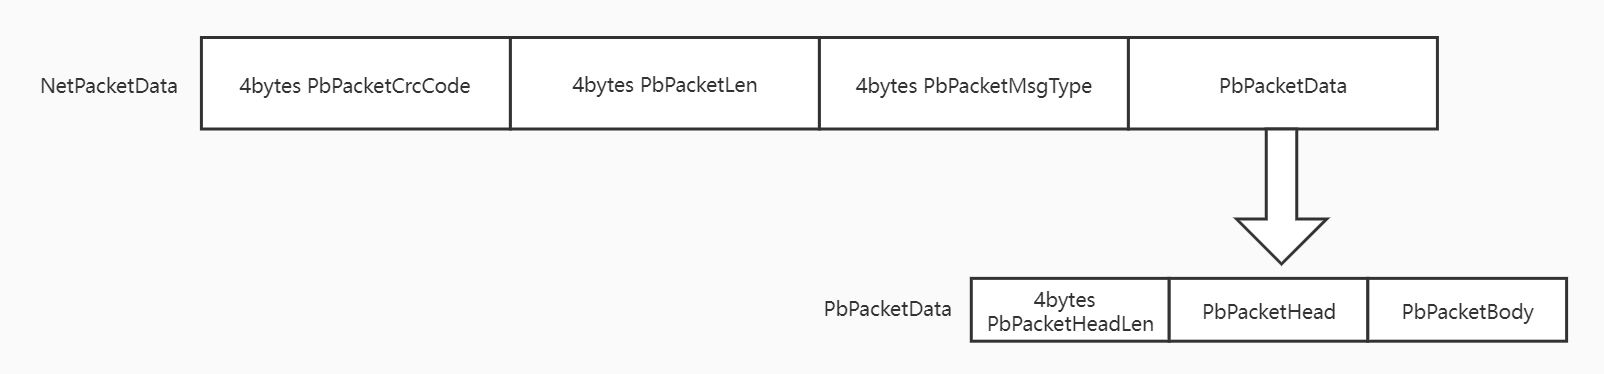
NetPacketData前面固定12字节大小。
第一个是4字节无符号代表PbPacketData的数据长度PbPacketLen。
第二个是4字节无符号代表对PbPacketData的数据CRC检验PbPacketCrcCode。
第三个是4字节无符号代表包类型ID,其中客户端协议号小于0x40000000,服务器之间的消息ID从0x40000000开始。
第四个是PbPacketData,里面按顺序划分为PbPacketHeadLen,PbPacketHead,PbPacketBody。
PbPacketHeadLen是PbPacketHead的长度,PbPacketBody的长度等于
PbPacketLen-PbPacketHeadLen。
服务器与客户端协议PbHead为Pb::ClientHead的序列化,包体定义msgid表示自身协议号。
服务器与服务器之间的PbHead为Pb::ServerHead的序列化,包体定义msgid表示自身协议号。
注意msgid的定义,请求包号1为基数,返回包号为偶数,通知消息包号为偶数。这样可以后面方便做弱网络下的客户端重连优化。
这里将通用性的部分放在PbHead里面,把逻辑相关部分放在PbBody内。
-
可以减少协议中冗余数据的重复定义。
-
对于某些服务,如GateServer,RouterServer的功能,绝大部分的网络包的PbBody是不需要解析的,可以做到对通用的包只进行有效性检查和转发,减少代码维护量。这里可以参考ClientPbModule的功能。
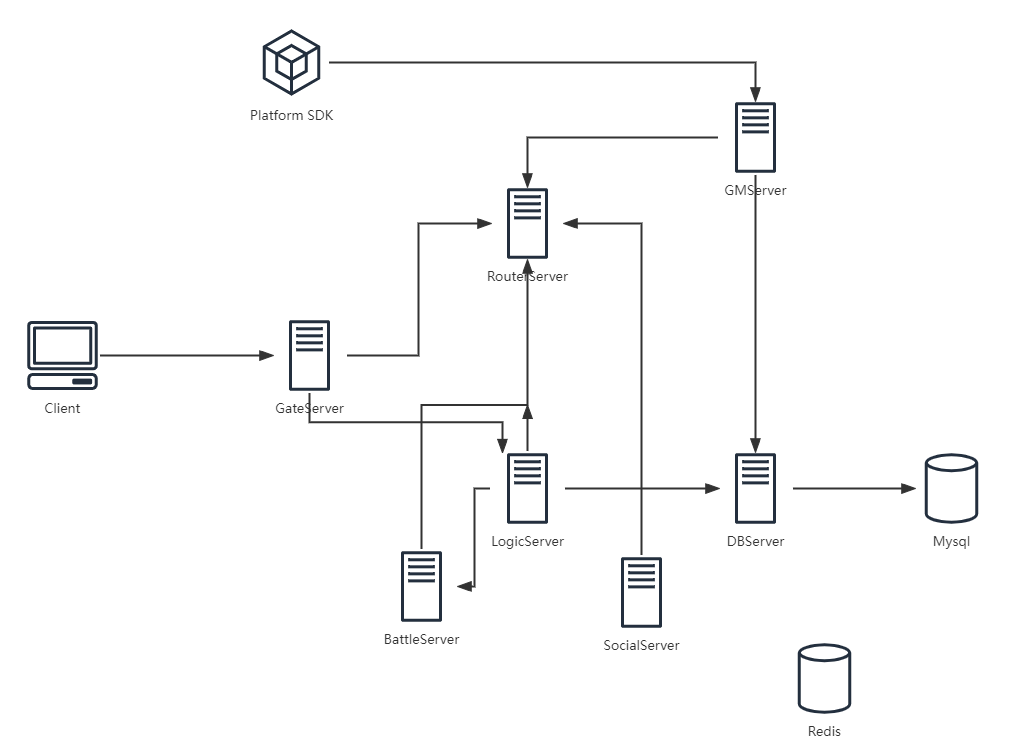
如下图,其中Redis被大部分服务所访问,连接线省略掉。
GateServer
处理客户端连接,判定消息类型有效性,转发消息到逻辑服务器,处理玩家登陆验证,踢人等少量控制逻辑。
服务器故障时导致玩家断线重连。
LogicServer
维护玩家单人线逻辑,缓存玩家数据,玩家需要持久化的数据用protobuf定义和访问。登录后LogicServer从DBServer拉去玩家数据后缓存到逻辑服,此后玩家数据和状态以逻辑服务器为准。如果出现非本逻辑服的故障,以此逻辑服务器数据为准并尽可能对用户提供服务,做数据最终一致性保证。
服务器故障时,最多会丢失一帧(大约几十毫秒)的数据。与客户端做了协议窗口的逻辑,低活跃玩家无故障感知。
DBServer
做DB服务的代理,并且做玩家数据定时存储的逻辑。
在玩家请求消息时,会在LogicServer Update时去处理和改变内存状态,然后按帧去提交脏数据到DBServer,DBSever缓存维护脏数据状态,并且定期去将数据事务性的写DB。此时按帧Update时提交的好处是保证玩家操作的完整性,以及减少网络包传输数量。
比如一个玩家去充值,会去标志玩家一笔充值的数据状态,增加钻石或礼包,还可能会完成一个充值成就(如首次充值,或者充值金额达到xx)。LogicServer代码会在一个消息处理函数去修改内存状态,包括充值信息,背包,成就三个不同的状态,在这个消息处理完成后,Update时会把这个玩家变更数据以一个消息包发送到DBServer去,DBServer会去定期存储(对于玩家充值这种重要资产变更,要去做sync立即存到DB中),此事务保证在有网络崩溃或服务不可用的时候,要么玩家充值状态,背包和成就数据会写入数据库,要么这几个状态都没写进数据库。这样保证玩家的数据的逻辑一致性,在玩家充值资产确保写入数据库后会返回给外部平台中心,若此时宕机充值会重新发过来,由于充值完ID会记录到玩家状态上,此时之前没成功持久化会从新开始充值资产变更和触发逻辑,若持久化成功则不会重复充值,这样保证了充值消息的幂等。同理还有玩家任务1和成就2都是打一种怪,出现两个系统计数不一致的奇怪现象。等等。
这边使用用protobuf做schema,直接定义数据库结构,DBServer利用protobuf反射出类型和名字作为字段信息,然后存储。
db_data定义数据库存储内容,主message定义的int,string作为公共的主键,主message下面包含的message,repeated 变量名作为table名称。这些 message,repeated 的message 可以定义自己后缀主键(主message下面的int,string 会与这些后缀主键成为这个table的主键),这个主键由message定义前的注释,形成格式格式: "// user_data key=(key_name1,key_name2,...)" 按照顺序形成主键。DBExecModule接口:LoadMessage,UpdateMessage,DeleteMessage 可以传入自定义好的protobuf::Message,函数会利用反射做增删改查。注意,数据内容不要 全部整数为0,字符串空 作为数据存入数据库中,这是由于protobuf3的empty判别机制导致此时逻辑判断为空造成略过数据。
RouterServer
做全局命名服务,保证单个服务节点对整个服务集群的一致性。可使用etcd/zookeeper保证一致性,或者简单一点用静态哈希但可用性会差点。
对外接口:让其他服务节点注册服务,以及根据其他节点发来的key转发消息包。
注意其他的Server在发现和RouterServer断开连接时需要停止对外服务,防止脑裂。如果是像LogicServer这种有状态服务,还需要立即让自己的数据其持久化。
在RouterServer达到一半数量故障后,停止对外服务。
BattleServer
处理副本,战斗,房间的逻辑。消息通过LogicServer转发。需要网络优化,考虑战斗同步消息不通过LogicServer,与客户端udp传输,或考虑KCP,QUIC等解决方案。
战斗场景产生性能瓶颈,使用线程池拆分低状态耦合的业务。
故障后,副本和战斗丢失,玩家被踢出战斗,需重新新建副本。房间逻辑做了可用性保证,状态全部缓存在了redis,可由RouterServer重新定位一个服务器继续后续服务。
实体和组件之间在设计时需要做到单向包含的关系。如果产生相互引用和依赖,会造成类之间的关系耦合,逻辑复杂。
SocialServer
处理社团,好友以及多人交互逻辑。定期全服性结算会选中一台SocialServer处理。
故障后,可由RouterServer重新定位一个服务器继续提供服务。
GMServer
处理平台SDK充值,GM管理和全局GM事件。
故障后,可由RouterServer重新定位一个服务器继续提供服务。
业务尽量以key-value这种nosql的形式使用数据库。由于互联网云数据库分布式的原因,这样的使用方式不会导致不同平台隐式的性能差异,各类操作性能更可控,也方便迁移到mongoDB或其他类型数据库。
例如游戏业务逻辑复杂,一次操作涉及到多个不同类型的状态变化,数据库读写压力大。需要访问磁盘,产生io,读-缓存,写-合并提交。
按照逻辑进行划分业务表,使用ORM,不需要手动维护SQL。LogicServer中的Player数据在使用非const接口去修改时(调用 MutableXXX 函数),自动做脏标记,在每帧Update时发送脏数据给DBServer, 由DBServer做定时存储。
不要使用自增键,可以代码里自己用雪花算法生成唯一int64或string 值。
遍历数据库where key>last_max_key limit 1000,控制拉取数量,一次太多造成client fetch产生隐式网络通信。
数据库设计范式,高阶范式field数据独立性高,但是一个业务逻辑会造成多张表的读写。对于改变不频繁的数据,可以在数据库表里做冗余,方便业务需要。
减少关系型数据库逻辑操作,尽量设计成kv,便于向分布式数据库兼容。
单表字段数量控制,row size不要超过存储引擎的页大小(innodb_page_size)。
字段设置not null default。
写数据库使用on duplicate key update,保证数据库短暂下线后,数据最终一致性。
key的左前缀匹配原则。
CS架构下,服务器只负责持久化数据,资产相关逻辑检验,解决多玩家间同步问题。前端显示相关业务不要放在后端处理,造成前后端耦合,代码读起来也造成迷惑。
宁愿漏发事后补偿,不能给用户多发,杜绝可能出现刷奖励的可能。
业务开发,隐形逻辑,用户可否在前端界面感知,用户误报bug。
需求分析。策划体功能需求来完成他的目的,有些复杂的需求,可以直接问实现目的,寻找其他实现目的的方法。
不断思考总结,站在更高的高纬度看问题,通过对业务的熟悉,养成更好的抽象化能力。
类的成员构造初始化和数据库的初始化值,不要图方便放业务相关逻辑。一般整数初始0,布尔初始化false,字符串初始化为空字符,枚举初始化为invalid(此枚举设定的值为0)。
基于Module的这种设计,数据方法分离。减少调用层次链,明确各个模块的功能的职责。优化了函数调用层次和引用关系。递归调用要谨慎使用。
don't repeat yourself。对于一目了然的代码,过分注释造成冗余,双份文本维护。
核心代码,难懂的代码(少量代码会为了性能需要代码比较晦涩难懂)注释,用优秀的变量名和函数名来注释代码吧。命名不要模糊,要具体不能太泛化。注意代码排版,形成自文档化。
没有走到正常流程的退出需要加日志,便于线上问题的排查。
涉及核心资产需要加特殊日志,便于事后校验。
通用模块接口透明,逻辑稳定,不要和业务耦合。写接口,把调用方程序员当成用户,优化用户体验。用户使用,要么没有用错接口的可能,要么用起来很奇怪才会用错,减少调用方的心智负担。
函数功能独立性,不要包含副作用。
一段代码做到上下文无关,不要前后逻辑强关联。
clang-format格式刷。cpplint插件风格检查。
修改python的excel脚本增加ServerErrorCode转ErrorString代码,可以使用tag dispath做编译期转换,或直接使用magic_enum.h接口。或使用如下实现,绑定不同名的字符串值。
enum ErrorType {
    eErrorTypeServerNotStart = 1,
    eErrorTypeServerInterError = 2,
};

template <ErrorType eType>
struct GetErrorTypeStructHelper {
};

#define DEFINE_ERROR_TYPE_STRING(_Error_TYPE, _TYPE_STRING)                       \
    inline const char* GetErrorTypeHelper(GetErrorTypeStructHelper<_Error_TYPE>) \
    {                                                                               \
        const char* pErrorName = _TYPE_STRING;                                     \
        return pErrorName;                                                         \
    }

DEFINE_ERROR_TYPE_STRING(eErrorTypeServerNotStart, "Server Is Initial Now")
DEFINE_ERROR_TYPE_STRING(eErrorTypeServerInterError, "Server Unknow Error")

template <ErrorType eType>
const char* GetErrorType()
{
    return GetErrorTypeHelper(GetErrorTypeStructHelper<eType>());
}

// use example:
// GetErrorType<ErrorType::eErrorTypeServerInterError>()  --> return const char* name
业务逻辑大体分为两种:
if(check1()) {
    LOG ...
    return;
}

if(check2()) {
    LOG ...
    return;
}

if(check3()) {
    LOG ...
    return;
}

DoSomething();if(condition1()) {
DoSomething1();
} else if(condition2()) {
DoSomething2();
} else if(condition3()) {
DoSomething3();
} else {
DoSomething3();
}两种主要逻辑形式,代码形式尽量向这两种形式靠拢。这两种可以组合起来使用,例如后者的DoSomething1()可以替换为 上面的代码。统一风格起来降低阅读成本,增加维护效率。
变量命名不要用单字符命名。变量名称要能够阐明它自身的含义,相同代码区块内不要有相似名称的变量名,以免混淆。函数名要简述自身做了什么,而不是阐述它是给谁调的。命名要尽量做到望名思意,让读代码的人理解代码时涉及尽量少的上下文逻辑,便于维护。
一段逻辑代码的设计尽量保持上下文无关。前后调用逻辑关联越紧密,越难维护。涉及到的逻辑状态在符合要求的情况下,作用空间域尽量短,能够作为栈变量定义实现的就不要放在作用域更大的类成员或全局静态中。大的作用域范围维护起来更容易使人迷惑,更小的作用域能更清晰表明这个变量状态的作用影响范围,后续理解起来更加清晰明了。
新类的建立和设计要经过深思熟虑。添加新类往往意味着代码复杂度上升,项目增熵,新添加设计模式要能够优化开发效率,或者能定义一个良好的通用逻辑模型让代码逻辑形式保持统一性。对于一个中大型的项目,把控整体的复杂度是十分重要的。模块的划分能做到概念的脱耦,不同模块之间交互保持简单,对开发人员而言概念尽量简单易懂,并且模块之间可以起到开发隔离的作用。
项目在整体上形式统一,局部保留一定的自由发挥空间。整个软件功能设计之初要考虑好局部隔离性。
项目中新特性的应用保持保守态度。项目代码编写不是写应试作文,把自己知道的知识和语法特性应用进来就能得高分,这是很多初入开发常犯的误区。如果只是在一个模块内部可以有一定的自主发挥,但是对于通用的接口,引入新特性要能给不同模块交互和调用带来显著优点,否则项目内各种风格特性太多导致项目难以管理,尤其是c++语法复杂多样,难以做到软件工程整体复杂度的控制,让开发人员在开发任务中疲于学习各种对项目开发效率没什么帮助的特性会拖累开发进度。
注意调用方和被调用方逻辑划分。谁是控制主体,谁负责解决主要问题,谁处理子问题,以及谁调用谁的接口,子问题如何划分,这些要在设计之初时考虑,后续写的代码思路和解决问题的划分容易变得更加清晰。功能职责要简单明了,层次清晰,避免互相调用避免类之间逻辑纠缠在一起导致类之间的强依赖。
接口设计的对偶和依赖关系要明确。如: set/get, create/destory, on_login/on_logout, set_data_index/remove_data_index 接口成对,相关联的逻辑放在对偶的接口函数中实现更不容易出错。 父子层次或顺序依赖函数如: set_network(network_option)/set_network_cache(network_option_cache), on_create()/on_start() 让调用方能够通过命名,编译错误, 手脚架检查等方式 避免调用者歧义调用。
和优化程序运行效率优化热点函数类似,代码开发工作也能够去抽到出热点逻辑,通过抽象接口,制作代码生成器,或其他辅助工具等方式简化工作以及减少工作量。
例如一般的游戏服务器,约20%+代码是存数据库,大量的数据库读取并反序列化到内存对象,内存持久化到数据库中,配置文件解析和转换到内存结构中占10%+代码,与客户端状态同步占用15%+代码,条件判断代码量占30%+,很多++count>=dest_cnt,以及==,<,>,考虑如何抽象,如何设计接口和工具优化开发。
在项目迭代中,随着业务发展和演变,增加和删除抽象概念和类。如何去减熵。模型抽象过多,概念合并或二次抽象。
DBCache 的的实现。
PlayerConditionModulede 的实现。
TimeModule的实现,可以修改服务器集群时间,方便测试,缓存结果,减少系统调用。
有些只提供了异步接口,还要给出协程接口。
python的excel脚本生成的配置接口可以包含查找键。
服务注册发现实现raft,或者使用zookeeper,brpc成熟的方案。用如kakfa消息队列库,抽离出处理对象之间的交互。
状态迁移的处理。处理玩家个人线和战斗副本等状态的服务器做随时热更和容灾,会涉及到数据迁移的中间状态。