Repository navigation
Data Explanation
- 설명에 앞서 HGNR에서는 Round 13의 dataset을 이용하지만 이는 이용하지 못함.
- 다른 Round의 데이터 셋을 제공
- 즉, Yelp data를 가지고 완벽하게 논문에서 나온 hit, NDCG를 도출하지 못함
Yelp는 User가 장소를 방문했을 때, 그 장소에 대해 평점과 Review를 남긴다. 다른 User들은 이 Review를 참고하여 그 장소를 갈 수도, 안 갈 수도 있다. 이 Site에서 Review가 마음에 든 사람과 또는 친구들을 팔로우 할 수 있다.
-
business_id : 장소만의 Id
-
name : 장소 이름
-
address : 주소
-
city : 장소가 위치해 있는 도시
-
state : 나라의 코드 e.x)한국 - KR
-
postal code : 장소의 우편번호
-
latitude : 위도
-
longitude : 경도
-
starts : 그 장소의 평균 평점(0.5로 끊어짐)
-
reivew_counts : 장소에 대해 Review 개수
-
is_open : 현재 그 가게 또는 장소가 열려 있나
-
attributes : 그 장소의 특징들
-
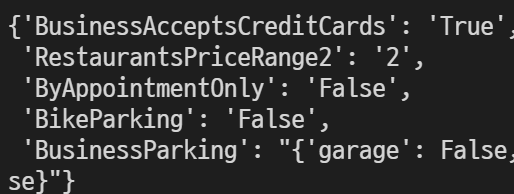
Attribute가 각각 장소마다 다름
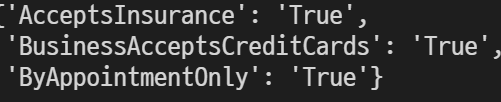
- 예시-
-
다른 장소의 Attribute
-
추가 Idea : Attribute를 기준으로 Item link를 하려고 했지만 Attribute의 column의 variance가 너무 큼. 어떤 것은 3개 밖에 없지만, 또 다른 것은 20개 넘게 존재
-
categories : 장소의 category로 어떤 범주에 속하는지의 정보
- Unique Category의 수 : 2487
- 예시 ) Airport Lounges, Auto Glass Services, Team Building Activities
-
hours : 그 장소가 여는 시간
- 예시 ) "Monday": "10:00-21:00",
장소의 수 : 138,876
user가 business에 대해 review한 정보
- review_id : 각 review를 구별하는 id
- user_id : review를 남긴 유저
- business_id : 장소 id
- stars : 남긴 평점(rating)
- date : review를 남긴 시점
- 형식 : "2016-03-09"
- text : 남긴 Review
- useful : 다른 user가 review가 유용하다고 vote한 수
- funny : 다른 user가 review가 웃기다고 vote한 수
- cool : 다른 user가 review보고 cool하다고 vote한 수
review의 수 : 8,635,403
-
user_id : 각 user를 구분하는 id
-
name : user의 이름(first name)
-
review_count : user가 review 남긴 총 수
-
yelping_since : user가 가입한 날짜
- 형식 : YYYY-MM-DD
-
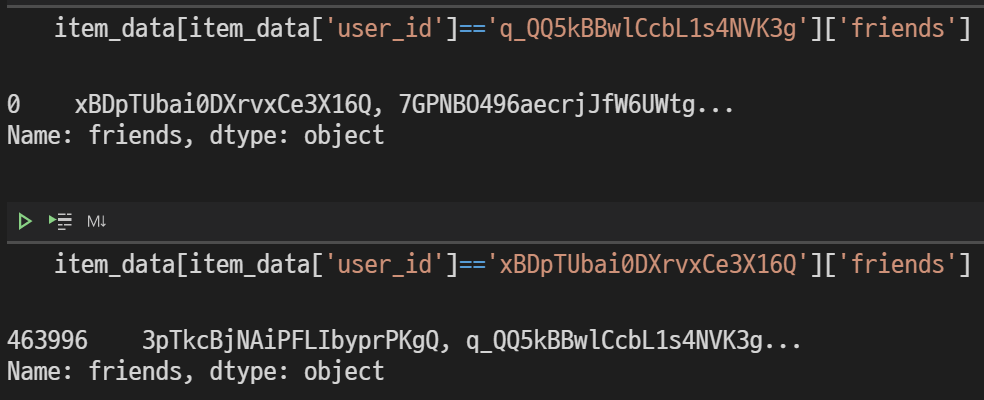
friends : 유저와 친구인지 - Undirected 개념이라고 생각
- 형식 : array로 user_id가 담겨 있음
- Undirected
-
userful : 다른 유저가 이 유저가 맘에 들거나 유용하다고 생각하여 vote한 수
-
funny : 다른 유저가 이 유저가 웃기다고 생각하여 vote한 수
-
fans : 다른 User의 해당 유저를 Follow한 수
- Directed의 개념
-
elite : user가 어느 연도에 elite였는지
- elite의 개념 : passionate한 user는 그 년도에 elite라는 칭호를 받음
- elite의 개념 : passionate한 user는 그 년도에 elite라는 칭호를 받음
-
average_stars : user가 남긴 review 평점의 평균
user의 수 : 2,189,457
business(장소)를 checkin한 날짜를 모아둔 것인데 정확하게 무엇인지 파악 불가
- business_id : checkin한 business id
- data : checkin한 날짜
review보다 짧은 글이지만 장소에 대해 남긴 글
- text : 장소에 남긴 글
- date : 언제 tip의 글을 남겼는지
- compliment_count : 다른 유저가 이 tip을 칭찬한 개수
- business_id : 어느 장소에 tip을 남겼는지
- user_id : tip을 남긴 유저의 id
tip의 수 : 1,162,119
## business 정보
data = []
with open('.\\데이터\\Yelp\\item.json', 'r', encoding='UTF-8') as f:
    for line in f:
        data.append(json.loads(line))
item = pd.DataFrame(data)

## user 정보
data = []
with open('.\\데이터\\Yelp\\user.json', 'r', encoding='UTF-8') as f:
    for line in f:
        data.append(json.loads(line))
user = pd.DataFrame(data)Epinion은 e-commerce로 온라인 시장에서 User가 상품을 구매하고, 평점과 리뷰를 남긴다.
Json 데이터를 불러오는데 price 부분에서 쌍따옴표와 작은 따옴표의 문제가 생겨 price부분은 삭제하고 불러왔다. 일반적인 방법으로 불러오지 않아 다른 방법으로 불러왔다.
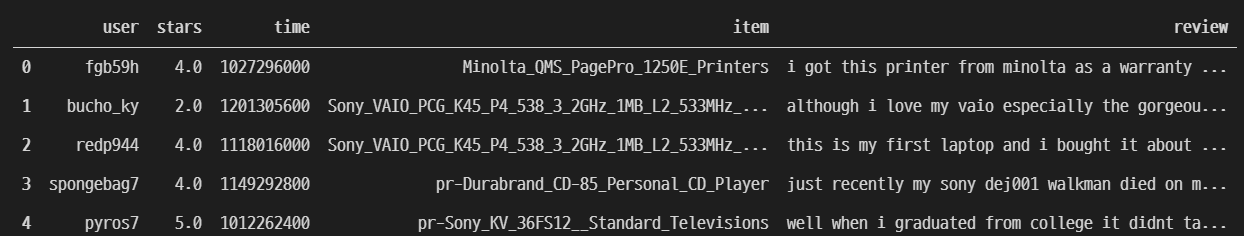
- users : User를 구분한 Id
- Unique user의 수 : 116260
- stars : 구매한 item의 평점
- time : Review를 남긴 시간
- item : 구매한 Item의 Id
- Unique item의 수 : 41269
- review : 구매한 item에 대한 review
- 총 observation
188478
network_trustedby.txt와는 방향만 다른 것으로 하나의 데이터만 이용해도 된다. 즉, 한 사람이 다른 user를 follow를 했을 때, trust가 된다. 이는 directed를 의미한다.
-
edge의 수
691895 -
다운로드
Epinion Dataset
- 데이터 형태
data = []
## epinion_2는 price column을 지운 데이터
with open('.\\데이터\\Epinion\\epinions_2.json', 'r', encoding='UTF-8') as f:
    for line in f:
        line = json.dumps(line)
        data.append(json.loads(line))
item = pd.DataFrame(data)

temp = []
for index,value in item.iterrows():
    temp.append(json.loads(value[0].replace("'","\"")))
df = pd.DataFrame(temp)
## edges.txt 열기
trust = pd.read_table('.\\데이터\\Epinion\\network_trust.txt', sep = '\t', header=None,names=['믿는 자', 'trust', '믿음을 당하는자'])

## pickle로 열 경우
import pickle
with open('.\\데이터\\Epinion\\epinions_2.pickle', 'wb') as f:
pickle.dump(df, f)User가 책을 보고 평점과 Review를 남긴다.
- work : 어떤 책을 평가했는지(book id)
- stars : 책 보고 rating
- time : 책 review를 남긴 시점
- comment : 책에 대한 Review
- user : 어떤 user가 평가를 했는지
- 문제 : comment는 있지만 user id가 없는 경우가 존재(91개) - 이런 데이터 셋은 제외시킴
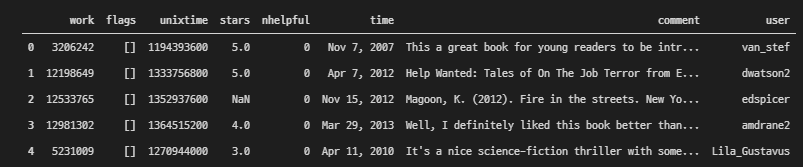
총 observation 수 : 1706979
- Undirected로 서로 친구를 의미함
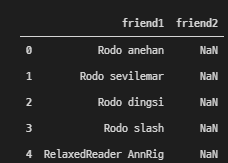
총 edge 수 : 219790
전처리한 Librarything 데이터 - pickle 형태로 저장
- Library에서 json여는 문제 발생
json의 형태인 경우 {}안에 작은 따옴표(')가 아니라 큰 따옴표(")로 string을 처리해야되는데review.json은 작은 따옴표로 되어있는 문제
모든 string에서 replace를 통해 작은 따옴표를 큰 따옴표로 바꾸면 comment key의 value에 해당하는 부분의 작은 따옴표도 같이 큰 따옴표로 바뀌는 문제
e.x) 'comment': "he's angry" => "comment": "he"s angry"(X)
## review.json 열기
data = []
with open('.\\데이터\\Library\\reviews.json', 'r', encoding='UTF-8') as f:
   for line in f:
        line = json.dumps(line)
        data.append(json.loads(line))
item = pd.DataFrame(data)

temp = []
exception = []
for index,value in item.iterrows():
    first = value[0].find("'comment'")
    second = value[0].find("'user'")
    content = value[0][first+12:second-3].replace("\"","'")
    content = content.replace("\\",'')
    review = "\""+content+"\""
    change = value[0].replace("'","\"")
    word = change[:first+11]+review+change[second-2:]
    try:
        temp.append(json.loads(word))
    except:
        exception.append([index, word])
dataframe = pd.DataFrame(temp)