第六章课后习题学习笔记与解答 #908
Unanswered
lizhuofan-curry
asked this question in
💬 Exercises & Q&A
第六章课后习题学习笔记与解答
#908

Replies: 1 comment 1 reply

|
1 reply

|
好像是的,我之前发的都看不到了 |
Sign up for free
to join this conversation on GitHub.
Already have an account?
Sign in to comment


Uh oh!
There was an error while loading. Please reload this page.
第六章课后习题
习题1
本章介绍了四个各具特色的智能体框架:
AutoGen、AgentScope、CAMEL和LangGraph。请分析:AutoGen 与 LangGraph 深入对比
这两个框架最能体现教材中“涌现式协作”和“显示控制”的区别
例如之前运行的 AutoGen 软件开发团队:
表面上看也像一个流程,但每个智能体输出的内容主要由模型自己决定。而LangGraph 会把它写成明确的图,这里“通过之后去哪,不通过后去哪”是程序明确规定的。
如何理解“涌现式协作”
涌现式协作是指:
例如在 CAMEL 中:
开发者没有提前写死:
而是让两个智能体根据上下文自主决定下一轮讨论什么,它的优点是:
缺点是:
如何理解“显示控制”
显示控制是指:
例如 LangGraph 的搜索助手:
如果加入反思则变成:
它的优点是:
缺点是:
这两种思想并不冲突
真实系统通常会结合两者:
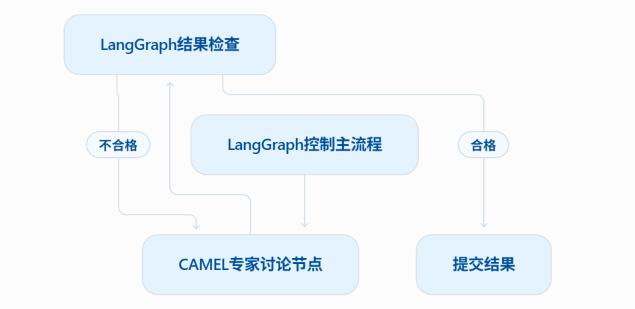
LangGraph 负责保证流程稳定,CAMEL 或 AutoGen 负责在某个节点内部展开开放讨论
习题2
在6.2节的
AutoGen案例中,我们构建了一个"软件开发团队"。请基于此案例进行扩展思考:RoundRobinGroupChat(轮询群聊)模式,智能体按固定顺序发言。如果需求变更,工程师的代码需要返回给产品经理重新审核,应该如何修改协作流程?请设计一个支持"动态回退"的机制。System Message为每个智能体定义了角色和职责。请尝试为这个团队添加一个新角色"测试工程师"(Quality Assurance),并设计其系统消息,使其能够在代码审查后执行自动化测试。AutoGen的对话式协作存在可能的不稳定性,可能导致对话偏离主题或陷入循环。请思考:如何设计一套"对话质量监控"机制,在检测到异常时及时干预?设计支持“动态回退”的机制
原来的 RoundRobinGroupChat 是固定轮询:
它的问题是:无论代码出了什么问题,都只能按照固定顺序继续发言,但是代码审查可能产生不同结果:
所以要从“固定轮询”改成“根据状态动态选择下一名智能体”
第一步:让审查员输出结构化结果
不能让审查员只输出一段自然语言,例如:
因为这样程序很难判断下一步去哪
可以定义:
审查结果示例:
第二步:根据结果路由
这样就实现了:
第三步:限制回退次数
如果没有限制,可能出现:
因此需要增加:
每次退回:
也就是:自动修复最多尝试3次,仍然无法解决就交给人类
添加测试工程师 Quality Assurance
测试工程师应放在代码审查之后。它的职责不是重新写代码,而是:
可以这样定义:
这里有一个非常重要的设计:
也就是把“语言推理”和“真实执行”分开,否则大模型可能只是文字上说“测试通过”,实际上根本没有运行代码
设计“对话质量监控”机制
可以增加一个 ConverationMonitor ,它不参与软件开发,而是监控整个团队,主要检测一下问题:
可以维护一个状态:
监控逻辑:
最可靠的方案是三级监控:
不能只让另一个大模型负责监控,否则“监控模型”本身也可能判断错误
习题3
在6.3节的
AgentScope案例中,我们实现了一个"三国狼人杀"游戏。请深入分析:MsgHub(消息中心)来管理智能体间的通信。请解释消息驱动架构相比传统函数调用的优势是什么?在什么场景下这种架构特别有价值?DiscussionModelCN、WitchActionModelCN)来约束智能体行为。请设计一个新的游戏角色"猎人",并定义其对应的结构化输出模型,包括字段定义和验证规则。AgentScope支持分布式部署,这意味着不同的智能体可以运行在不同的服务器上。请思考:在"三国狼人杀"这样的实时游戏场景中,分布式部署会带来哪些技术挑战?如何保证消息的顺序性和一致性?消息驱动架构的优势
传统函数调用的是:
这意味着:
消息驱动方式是:
这样发送者只负责发送信息,不需要知道所有接收者
主要优势
降低耦合
刘备只需要把消息发给消息中心,不必直接调用:
新增观察员时,也不需要修改刘备的代码
支持一对多广播
狼人杀中,一位玩家公开发言后,其他所有玩家都应该收到。
消息中心可以一次广播:
支持异步执行
多个智能体可以在不同线程,进程甚至服务器运行,不必全部同步阻塞
方便记录和回放
消息中心可以保存:
因此可以复盘整局游戏
方便分布式部署
玩家智能体即使运行在不同服务器,也能通过消息系统通信
特别适用的场景:
设计“猎人”的结构化输出模型
假设规则是:
定义结构化模型:
合法输出:
{
  "action": "开枪",
  "target": "曹操",
  "reason": "曹操连续两轮发言矛盾,狼人嫌疑最高",
  "confidence": 0.82
}
不开枪时:
{
  "action": "不开枪",
  "target": null,
  "reason": "当前信息不足,盲目开枪可能误伤好人",
  "confidence": 0.55
}
Pydantic模型还不够
Pydantic只能检查:
但是下面这些规则必须由游戏引擎检查:
因此:结构化输出负责约束数据格式,游戏引擎负责验证真实业务规则
分布式部署带来的挑战
挑战一:网络延迟
某个玩家可能因为网络问题迟迟没有回答,解决方法:
挑战二:消息乱序
例如:
网络传输后可能先收到102,再收到101
解决方法:每条消息增加序列信息:
{
  "game_id": "game-001",
  "phase_id": 5,
  "sequence_no": 102,
  "message_id": "msg-abc123"
}
接收端根据
sequence_no排序挑战三:重复消息
如果网络超时重试,同一次投票可能提交两遍
解决方法:
message_id这叫幂等性
挑战四:不同服务器状态不一致
可能出现:
解决方法:
玩家只能提交行动意图:
裁判验证后才产生正式事件:
挑战五:服务器故障
如果裁判进程崩溃,不能丢失整局游戏,可以使用:
恢复时:
不需要保证整个系统全部消息的全局顺序,只需要保证:同一局游戏,同一阶段内部的消息顺序
习题4
在6.4节的
CAMEL案例中,我们让心理学家和作家协作创作电子书。<CAMEL_TASK_DONE>标志时强制终止。但如果两个智能体意见分歧(一位认为可以终止,一位认为不应该终止),无法达成一致怎么办?请设计一个"冲突解决"的兼容机制。CAMEL最初设计用于双智能体协作,但现在已经扩展支持多智能体。请查阅CAMEL的最新文档,了解其多智能体协作模块workforce,并结合架构图说明其与AutoGen的群聊模式有何不同。两个智能体意见不一致时怎么办
原案例检测到:
就结束任务,但是问题在于:一个智能体可能认为写完了,另一个认为还需要修改,因此不能把
<CAMEL_TASK_DONE>当成最终终止命令,而应该把它改成:也就是“提出完成申请”
具体状态:
终止规则
任务必须同时满足:
才能结束:
不同意时必须说明原因
不能只说:
应该输出:
{
  "decision": "reject",
  "missing_items": [
    "第三章缺少拖延症形成机制的科学解释",
    "第五章的建议缺少实际案例"
  ],
  "revision_plan": [
    "补充执行功能与情绪调节部分",
    "增加一名大学生拖延案例"
  ]
}
连续无法达成一致
如果两轮或者三轮后仍然无法达成一致,那就加入第三个角色:
裁判根据提前规定的标准决定:
涉及科学准确性,版权或医疗建议时,应由人类最终确认
CAMEL Workforce 与 AutoGen 群聊的区别
根据 CAMEL 最新官方文档,
workforce是一个多智能体协作编排器,能够完成任务分解,分配,执行,结果依赖管理和失败恢复;Worker既可以时单智能体,也可以是内部包含两个角色的 RoleplayingWorker。CAMEL Workforce 整体结构可以理解为:
官方文档描述的生命周期是:
与 AutoGen群聊对比
可以把它们类比为:
所以Workforce不是简单地“把更多智能体拉进群聊”,而是增加了任务管理和调度层
习题5
在6.5节的
LangGraph案例中,我们构建了一个"三步问答助手"。请分析:LangGraph将智能体流程建模为状态机和有向图。请画出案例中"理解-搜索-回答"流程的图结构,标注节点、边和状态转换条件。LangGraph的优势在于对循环的原生支持。请设计一个更复杂的应用场景,充分利用这一特性:例如"代码生成-测试-修复"循环、"论文写作-审阅-修改"循环等。要求画出完整的图结构并说明关键节点的功能。画出“理解-搜索-回答”流程
核心状态可以写成:
每个节点修改什么状态
understand节点
输入:
输出:
{
    "user_query": "...",
    "search_query": "...",
    "step": "understood"
}
search 节点
搜索成功:
{
    "search_results": "...",
    "step": "searched"
}
搜索失败:
{
    "search_results": "搜索失败信息",
    "step": "search_failed"
}
answer节点
它检查:
如果搜索成功,就使用搜索资料回答;如果搜索失败就采用备用方案。
最后输出:
{
    "final_answer": response.content,
    "step": "completed"
}
添加“反思”节点
扩展状态
反思节点
条件边函数
添加条件边:
注意不能只使用“回答字数”判断质量,因为一句话的准确回答,可能比500字的空话质量更高。应该综合判断:
同时必须限制重试次数,否则“反思-重写”本身也可能陷入死循环
设计“代码生成-测试-修复”循环
关键节点
分析需求
将用户需求转换成:
生成代码
产生:
运行测试
必须由真实代码执行器执行,保存:
{
    "exit_code": 1,
    "stdout": "...",
    "stderr": "...",
    "failed_tests": [...]
}
不能让LLM自己声称“测试通过”
诊断错误
区分:
修复代码
只根据诊断结果修改,并记录:
人工介入
以下情况应暂停自动循环:
习题6
框架选型是智能体产品开发过程中的关键决策之一。假设你是一家
AI公司的技术架构师,公司计划开发以下三个智能体产品应用,请为每个应用选择最合适的框架(AutoGen、AgentScope、CAMEL、LangGraph或不借助框架从零开发),并详细说明理由:应用A:智能客服系统,需要处理大量并发用户请求(每秒1000+),要求响应时间低于2秒,系统需要7×24小时稳定运行,并支持水平扩展。
应用B:科研论文辅助写作平台,需要一个"研究员智能体"和一个"写作智能体"深度协作,共同完成文献综述、实验设计、数据分析和论文撰写。要求智能体能够进行多轮深度讨论,自主推进任务。
应用C:金融风控审批系统,需要按照严格的流程处理贷款申请:资料审核 → 风险评估 → 额度计算 → 合规检查 → 人工复核 → 最终决策。每个环节都有明确的判断标准和分支逻辑,要求流程可追溯、可审计。
应用A:高并发智能客服
选择 AgentScope + 常规分布式服务基础设施
原因:
题目最重要的要求不是“多个智能体自由讨论”,而是:
而 AgentScope 更强调 工程化,消息通信,并发,分布式部署,多智能体应用生命周期管理,因此它比CAMEL和AutoGen更符合这个场景。但需要注意:使用 AgentScope 不代表系统自认就能达到 1000 QPS,生产系统还需要:
AutoGen 或 CAMEL 的多轮对话会增加延迟,不适合每个客服请求都进行长时间讨论;LangGraph可以控制客服流程,但它不能单独解决高并发和服务拓展问题
应用B : 科研论文辅助写作平台
选择 CAMEL
原因
该任务正好有两个核心角色:
与 CAMEL的双智能体角色扮演非常匹配。
研究人员负责:
写作智能体负责:
任务需要多轮深入探讨和自主推进,而不是严格固定的审批流程,因此 CAMEL 比LangGraph更自然
如果后续增加:
就可以使用CAMEL Workforce对任务进行分解和分配
不过仍然需要:
应用C : 金融风控审批系统:
选择 LangGraph
原因
这个系统有非常严格的流程:
而且存在明确分支
LangGraph适合的原因:
但金融系统还要注意:
确定性规则应由:
来负责,LLM更适合:
总结
All reactions