Repository navigation
Optimization 12h 2026 11 14
作業開始:2026-11-13 23:58:47 JST。期限:2026-11-14 11:58:47 JST。最終集計:2026-11-14 09:50:38 JST。
固定比較元はmainのd937f28ad00e755a1aefd7c0c01dd967464a630a。公開用コミットは94aa1ab3cb7e8263e5b4f9422c38e535a8016528。
PR #104:設定更新と波形生成の重複処理を削減。両OS・3条件で全41ケースの平均が300ns未満となり、固定mainに対して全ケースが有意に短縮した。
標準41ケースを固定し、変更前後をブロック内で無作為順に比較した。基準条件48 kHz・256 samples/blockは30ブロック、追加条件は各10ブロック。測定値はIntel Core i9-14900KのCPU 0で得た。WindowsはMSVC生成コードをWine 11で実行した値。
| 環境 | Hz / buffer | ブロック数 | main 最大平均 ns | 最終 最大平均 ns | 最終の最大ブロック値 ns | 有意短縮 / 悪化 |
|---|---|---|---|---|---|---|
| linux | 48,000 / 256 | 30 | 458.449 | 290.052 | 293.935 | 41 / 0 |
| windows | 48,000 / 256 | 30 | 515.486 | 286.828 | 328.033 | 41 / 0 |
| linux | 44,100 / 64 | 10 | 433.998 | 271.272 | 271.886 | 41 / 0 |
| windows | 44,100 / 64 | 10 | 491.824 | 269.726 | 281.516 | 41 / 0 |
| linux | 96,000 / 512 | 10 | 449.557 | 280.657 | 283.542 | 41 / 0 |
| windows | 96,000 / 512 | 10 | 516.162 | 286.183 | 286.872 | 41 / 0 |
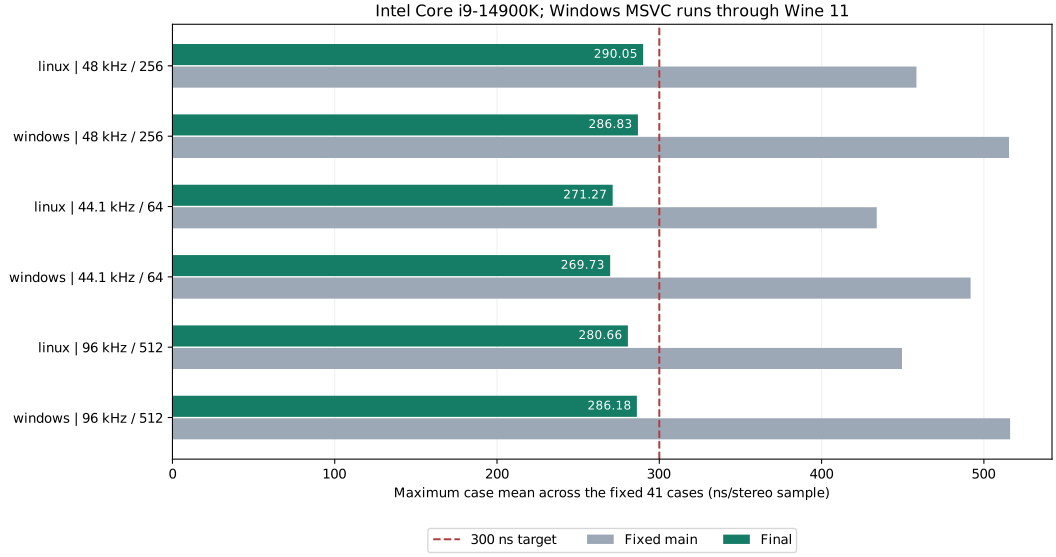
ns/sampleは生成区間の経過時間をステレオサンプル数で割った値であり、個々のサンプル処理の最悪実行時間を表すものではない。全ブロック・各ケースの平均、SD、対応差、信頼区間、t値、p値は表のリンク先に記録した。外れ値の除外は行わない。Windows 48kHzでは1,230回の変更後測定中、Chorus Padの1回が328.03nsとなった。この値も平均・分散に含めた。
実VST3経路の6条件比較でも、Program/Pitch/Note Onとオートメーションを実際のABIで与えた結果を記録した。
同時刻・同チャンネルの出力をそのまま比較し、時間・位相・音量を合わせ直さない。振幅1を0 dBFSとし、各条件・各チャンネルの絶対誤差RMSが1e−4以下(−80 dBFS以下)を主判定とする。ピーク差も独立に記録する。評価基準の解釈訂正に経緯を残した。
| 環境 / 条件群 | 条件数 | 合格数 | f64 最大RMS | f32 最大RMS | f32 最大peak差 |
|---|---|---|---|---|---|
| linux / standard | 123 | 123 | 6.4274e-17 | 0 | 0 |
| linux / stress | 348 | 348 | 6.94189e-14 | 0 | 0 |
| linux / effects | 270 | 270 | 9.74259e-17 | 0 | 0 |
| linux / coherent | 90 | 90 | 9.33504e-12 | 0 | 0 |
| windows / standard | 123 | 123 | 2.1005e-17 | 0 | 0 |
| windows / stress | 348 | 348 | 6.96245e-14 | 0 | 0 |
| windows / effects | 270 | 270 | 0 | 0 | 0 |
| windows / coherent | 90 | 90 | 9.3363e-12 | 0 | 0 |
標準演奏・急速なパラメータ変更・フィルタ/波形・全スロットのエフェクト・大振幅の計1,662条件。乱数は初期seedのみを共通化した。最終音声の条件と全数値へ記録した。
Masterの丸め境界試験は10,720設定×48,000frame×6波形×両OSで、設定別RMSの最大はLinux−125.08/Windows−107.02 dBFS。f32ピーク差の最大はそれぞれ−78.27/−60.21 dBFS。独立レビューでも集計と判定を照合した。
- パラメーター変更位置をSSE2でまとめて判定し、各コンポーネントへ共有する。変更した実値と保存値だけを更新する。
- 3台の発振器の呼出しを固定し、単一発振器の処理を短縮する。作業配列を共用し、通常ユニゾン波形の2読出しをSSE2で処理する。
- 位相変調が無効な間のADAA表参照を省き、必要な時点で初期化する。原始関数セルの境界確認をまとめる。
- フィルタ係数キャッシュを縮小し、Windowsでは同時刻のVoice間で同じcutoff倍率計算を共有する。
- エフェクトの単独パラメーター更新、短ブロックの補償遅延、Limiter系列処理を短縮する。Masterの指数換算はプラットフォームごとに選ぶ。
- VST3のPitchのみの区間を専用処理し、音色設定の複製を区間単位にまとめる。
数式を変える候補は大振幅と後段処理も検査した。Envelope・SVF・Compressorの一部置換は後段CompressorでRMS上限を超えるため採用せず、EQ近似は速度の悪化により採用しなかった。個々の候補の結果を合算せず、最終版を固定mainと比較している。
ローカル検証と変更量:Linux/Windows向けstable・MSRVの各178試験、Clippy、doc、カバレッジ、依存監査、Miri、VST ABIの記録。製品ソースは純増577行、依存関係の追加は0。
各ケースのburn-inは最低10msかつ演奏1周、準備音声2秒・測定音声4秒、ブロック間は5秒。ケース×変更前後を無作為に実行し、重い処理と排他的に測定した。両側の対応t検定と41ケース内のHolm補正(5%)を使用し、休止だけで独立性を保証したとは扱わない。有意な悪化を他ケースの改善で相殺しない。
| 実験 | 改善すべき課題 | 評価 |
|---|---|---|
| A1-effects-shortcut:エフェクトだけの変更でVoice判定を省く | エフェクト設定だけの変更でもVoice関連グループを走査する。 | 不採用 |
| A10-chorus-inline:Chorus換算関数だけをinline化 | Chorusの線形換算にslot位置の動的参照と関数呼出しが残る。 | 棄却 |
| A11-master-exp2:Master音量を2の指数で換算 | Master Volumeの変更ごとに10の汎用powfを計算する。 | 両OS共通での採用は見送り |
| A12-synth-typed:Synthの固定パラメーター換算を特殊化 | 種別がコンパイル時に既知の設定も汎用のindex検索を経由する。 | 不採用 |
| A13-amount-typed:Cutoff Amountの換算だけを特殊化 | 固定indexの全置換ではAmountが短縮する一方でModが悪化した。 | 採用根拠なし |
| A14-gain-proxy:Master Gainの指数換算を両OSで比較 | 音量automationで繰り返すdBの指数換算を短縮する。 | Linuxはpow10 6.84→exp2 2.10/exp 2.64 ns |
| A15-master-exp-linux:Master Gainの自然指数換算をLinux全体で比較 | 両OSで速いexp式を実際のSynthへ適用したとき、係数換算の短縮が残るか。 | 1短縮・39差未検出・1悪化 |
| A15-master-exp-windows:Master Gainの自然指数換算をWindows全体で比較 | Windowsの重いpow10換算をexpへ置き換え、実際のVolume automationを短縮できるか。 | 2短縮・39差未検出・0悪化 |
| A16-master-platform-exp:Master音量の指数換算をOSごとに選択 | Windowsのexp2はCRTで高コストとなる一方、Linuxの共通exp案はSineの小幅悪化を生じた。 | RMS精度条件に合格し統合候補とする |
| A2-eq-cache:変更していないEQ設定の実値を再利用する | EQの1項目の変更で、他の周波数やQも指数換算し直している。 | 統合候補 |
| A3-group-fold:パラメーター群の比較をSIMD化 | 未変更のf64配列を要素ごとに分岐して比較している。 | 単独採用しない |
| A4-inline:正規化換算のインライン展開 | 定数のパラメーター番号でも換算関数への呼出しが残る。 | 棄却 |
| A5-chunks:配列比較を32値で区切る | 長いパラメーター群で前方の値だけが変わる場合にも全値を比較する。 | 候補として継続 |
| A6-entry:入口の全値比較にもchunkを使う | setter入口の134値比較がscalarのまま残る。 | 候補として継続 |
| A7-pitch:Pitchの単位往復を省く | Pitchのcent換算後に再び1200で除算している。 | 棄却 |
| A8-canonical:型が既知の設定換算を固定indexで行う | slot番号により換算関数のindexが変わり、同じ型の選択が繰り返される。 | 有望 |
| A9-typed:型が既知の実単位換算を展開 | 種別が定数でもcontrol_kindの関数呼出しが残る。 | 全41で3短縮・38差未検出 |
| B10-shared-cutoff-inline:共用倍率の生成経路を明示的に展開 | 共有cache追加後、従来generate_sampleへ展開されていた8.5 KiBの本体がoutline化し、入口callとOption判定が増えた。 | 採用しない |
| B10-shared-cutoff-windows:Voice間cutoff倍率共有をWindowsで比較 | Windows CRTでは指数計算の費用が高く、複数Voiceの同じcent値の再計算が律速候補となる。 | 統合検証候補 |
| B11-copy-proxy:パラメーターsnapshot保存の単体比較 | 数値変更が1個でも全1,072 byteを保存している。 | Dual/Signは不採用 |
| B12-cutoff-amount:Cutoff AmountだけをVoiceへ配送 | Amountだけの変更でも全VoiceへAHDSR設定を複製し、Envelope入力の同値比較を繰り返す。 | 採用候補 |
| B14-windows-cutoff-cache:Windowsの複数Voiceだけでcutoff倍率を共有 | Windowsでは同一cutoff量の指数計算の共有が大きく効くが、単音とLinuxの追加費用を避けたい。 | 統合検証候補 |
| B14-windows-cutoff-cache-linux:Windows限定cacheのLinux側を比較 | Windowsへの共有cache追加がLinuxのコード生成や性能へ影響しないかを確認する。 | 全41ケースで差未検出、全410音声ペアbit一致 |
| B15-windows-cutoff-local:Voice間のcutoff cacheをサンプル内の局所変数へ移す | 同一サンプル内のVoice間で共有すれば、SynthStateの16 B追加と配置変更を避けられるか。 | 4短縮・35差未検出・2悪化 |
| B16-windows-cutoff-block:Windowsの定常区間でもVoice間のcutoff倍率を共有 | 固定設定の多音PADでは、単sample入口を使わず各Voiceが同じcutoff倍率を重複計算している。 | 有望候補 |
| B17-windows-cutoff-inline:共有cutoffを使う単sample入口だけをinline化 | Windowsの複数Voice合成でcached入口の呼出しと引数・レジスタの退避が残る。 | 10短縮・29差未検出・2悪化 |
| B18-windows-cutoff-isolated:共有cutoffの大きい本体を通常経路から隔離 | cached入口の展開で、多音側の大きい本体が通常単sample経路へ入り、Pitch/Delay automationが悪化した。 | 9短縮・32差未検出・0悪化 |
| B19-cutoff-final-linux:Windowsのcutoff共有のLinux中立性 | 複数Voiceで同一のカットオフAHDSRを計算すると、Windowsでは同じcentからHz倍率へのpowが各Voiceで繰り返される。 | C23比で41差未検出・0短縮・0悪化、全410音声ペアbit一致 |
| B19-cutoff-final-misses:cutoff共有の発音時刻・Velocity差がある条件 | 複数Voiceで同一のカットオフAHDSRを計算すると、Windowsでは同じcentからHz倍率へのpowが各Voiceで繰り返される。 | 追加5条件すべて有意短縮・全50音声ペアbit一致 |
| B19-windows-cutoff-final:Windowsのcutoff共有を単sampleと固定区間へ統合 | 複数Voiceで同一のカットオフAHDSRを計算すると、Windowsでは同じcentからHz倍率へのpowが各Voiceで繰り返される。 | C23比で18短縮・22差未検出・1悪化 |
| B2-mask:設定変更マスクを共有 | 同じ134値の変更位置をSynthとEffectsで繰り返し判定している。 | 9ケースで短縮、Cutoffが1.33 ns悪化 |
| B2-multi:共有maskの複数設定同時変更 | 単項目の変更に偏らず、複数群が同時に変わる場合を確認する。 | 複数変更4ケースで短縮、未変更setterは差未検出 |
| B20-cutoff-series-common-linux:共有あり/なしのVoice系列処理を一つに集約 | 通常系列とcutoff共有系列に同じ停止/準備/PM判定と生成ループが重複する。 | LinuxのB16文脈で全41差未検出、全410音声ペアbit一致 |
| B20-cutoff-series-common-windows:Voice系列共通化のWindows比較 | 通常系列とcutoff共有系列に同じ停止/準備/PM判定と生成ループが重複する。 | B19比で0短縮・37差未検出・4悪化、全410音声ペアbit一致 |
| B21-cutoff-active-only:無発音経路からcutoff共有の判定を移動 | 共有block処理を加えた最終形でidle-padが約0.3 ns遅くなったため、無発音時の追加判定を疑った。 | B19比で全41差未検出、全410音声ペアbit一致 |
| B22-cutoff-block-outline:共有cutoff系列のstackとレジスタ退避を隔離 | 無発音や通常の系列経路でも、Windows generate_samplesのプロローグに共有cache用のstackとXMM退避が残っていた。 | B19比で1短縮・39差未検出・1悪化、全410音声ペアbit一致 |
| B23-cutoff-sharing-linux:Windowsのcutoff共有をLinuxにも共通化 | Windowsで有効なVoice間のcutoff倍率共有をLinuxにも適用すると、OS別の分岐を減らし8音条件の計算を共有できる可能性がある。 | C31比で3短縮・24差未検出・14悪化、全410音声ペアbit一致 |
| B3-mask16:16値ずつ設定変更を集約 | 8値packでは上半分を使わずmovemaskと結合が繰り返される。 | 12ケースで短縮、29ケースは差未検出 |
| B3-multi:16値maskの同時変更と無変更 | 変更のないsetterでmask固定費が増えないか確認する。 | 複数変更4ケースで短縮 |
| B4-prepared-route:Synthから準備済み生成経路を選ぶ | Voiceの準備済み判定をSynth全体でまとめられるか調べる。 | 棄却 |
| B4-slot-gate:未変更slotを先に判定 | 各slotの7群を判定してから全体が未変更と分かる。 | 採用しない |
| B5-postmix:Voiceに影響しない更新の配送を省く | 全体エフェクトのみの変更でもVoice各群の判定を続けている。 | 採用候補 |
| B6-avx-proxy:AVX2によるパラメーター差分maskの比較 | 134個のf64比較と位置maskへの圧縮が、連続パラメーター更新ごとに必要となる。 | 14条件×3案は全て短縮 |
| B7-mask-tail:末尾6値の比較結果をSSE2で直接圧縮 | 134値のうち最後6値のscalar比較は、生成コードでbit抽出と再組立てを繰り返している。 | 棄却 |
| B8-mask-avx2:AVX2差分maskを本体へ組み込む | 差分maskの単体試験で得た約2.4 nsの短縮が、DSP全体でも有効か確認する。 | 不採用 |
| B9-shared-cutoff:Voice間でカットオフ変調倍率を共用 | 同じ時刻・同じ変調量の複数Voiceが、同じpowfによる倍率を個別に計算している可能性がある。 | この構成は採用しない |
| B9-shared-cutoff-misses:カットオフ倍率共有を非同時・別velocityの和音で比較 | 同時刻・同velocityの標準和音だけでは、共有cacheのmissが多い通常の演奏を評価できない。 | 全5ケースで悪化 |
| C01-dispatch:パラメーター更新の統合比較 | 重いオートメーション処理の共通オーバーヘッドを減らす。 | 13ケースで有意な短縮、28ケースは差未検出、有意な悪化は0ケース |
| C02-envelope-effects:EnvelopeとEffectsの統合比較 | Voiceの線形Envelopeと全体エフェクトの設定更新に繰り返し処理が残る。 | 30ケースで有意に短縮、11ケースは差未検出、有意な悪化は0ケース |
| C03-Windows:Windows機械語で統合版を比較 | Linux以外の機械語でも変更による速度差を確認する。 | 30短縮、11差未検出、悪化0 |
| C03-conversions:変更項目だけの換算を統合 | slot設定変更で同じ種類・Delay設定・型選択を繰り返し換算する。 | 37ケースで有意に短縮、4ケースは差未検出、有意な悪化は0ケース |
| C04-core:定位・波形出力・プリワープ・maskの統合 | 重い連続操作を300 ns以下へ近づけ、軽い音色への影響も確認する。 | 33短縮、4悪化、4差未検出 |
| C05-no-direct-output:発振器配列変更の副作用を切り分ける | C04で軽い音色と位相変調が悪化した。 | 全41で38短縮・3差未検出・悪化0 |
| C06-unison-sse2:ユニゾン並列化を統合する | 残る高負荷の通常波形生成を短縮する。 | 全41で40短縮・1差未検出・悪化0 |
| C07-output-buffer:発振器作業配列の共用を統合 | 発振器の出力コピーを通常波形・Modともに省く。 | 全41で39短縮・2差未検出・悪化0 |
| C09-exact-prewarp:係数式を維持して換算処理を削減 | 近似プリワープの大振幅f32丸め差を避けながら速度を改善する。 | 全41で40短縮・1差未検出・悪化0 |
| C10-exact-envelope:エンベロープも元の計算順を維持 | 大振幅を含むf32出力の差を抑えつつ処理時間を短縮する。 | 全41で37短縮・4差未検出・悪化0 |
| C11-Windows:Windows版で完全一致する統合候補を比較 | Windowsの機械コードでも300 nsの目標へ近づける。 | 36短縮・5差未検出・悪化0 |
| C11-align32:関数の32 byte境界配置を比較 | コード配置だけで発生する処理時間の変動と、配置指定の実益を確認する。 | 3短縮・1悪化・37差未検出 |
| C11-postmix-dispatch:合成後の設定変更でVoice更新を省略 | エフェクトだけの操作時に各Voiceを検査する費用を減らす。 | 全41で36短縮・4差未検出・1悪化 |
| C14-filter-cache-niche:設定更新とキャッシュ縮小を統合 | 軽い音色の悪化を解消し、残る300 ns超のオートメーションを短縮する。 | 全41ケースで有意に短縮し、音声fingerprintは全一致 |
| C15-three-oscillator-dispatch:固定3発振器の呼出しを統合 | 毎サンプルの動的な発振器番号と定位選択を減らす。 | 全41ケースが有意に短縮し、全410ペアの音声fingerprint一致 |
| C16-Windows:単一発振器経路までをWindows機械語で比較 | Linuxの300 ns達成がWindows用コードにも当てはまるか確認する。 | 全41ケースが有意に短縮し、全410音声ペアが一致 |
| C17-chorus-depth:Chorus Depthの直接更新までを統合 | Chorus Depthの連続操作を300 nsの境界からさらに短縮する。 | 固定mainとの全41比較で全ケースが有意に短縮し、全410音声ペアが一致 |
| C21-padding-block:設定更新と系列遅延の削減を統合 | 残る300 ns近辺の処理を短縮し、軽い通常音色も改善する。 | 固定mainとの全41比較で全ケースが有意に短縮、全410音声ペアが一致 |
| C23-Windows:設定更新の削減をWindows向け統合版で比較 | Windows用コードで残る300 ns超の条件を最新の統合版で確認する。 | 全41ケースで有意に短縮 |
| C24-distortion-fade:通常Distortionの不要な乗算省略を統合 | 元の数値を維持しながら全41ケースを300 nsの目標より短くする。 | 固定mainとの比較で全41ケースが有意に短縮、全410音声ペアが一致 |
| C28-effects-state-review:C28エフェクト系の状態遷移レビュー | 設定換算・呼出し・固定遅延の省略によって履歴や初期化の意味が変わらないか確認する。 | Linuxの44.1/48/96kHz・748509frameはmainとf64 bit一致 |
| C31-effects-state-review:C31エフェクト系統合差分とWindows状態遷移の確認 | 最適化を統合したエフェクト系列が、設定変更・初期化・短ブロック・バイパス時の意味を維持するか確認する。 | 修正所見なし |
| C31-windows-integration:Windowsのカットオフ共有を統合して全41条件を比較 | Windowsの複数Voiceで同一のカットオフ指数計算が繰り返される。精度反例のあるCompressor換算も除く必要がある。 | 全41の平均は300ns未満 |
| C32-core-state-review:C32パラメーター・Voice・発振器の独立レビュー | 最適化した配送と発振経路が、更新・準備・初期化・SIMDの安全条件を保つか確認する。 | 修正所見なし |
| C32-main-linux:統合した読み出し・設定配送を固定mainと比較(linux) | 個別改善を統合した際にも標準41ケースの300ns目標を満たすか確かめる。 | 全41ケースで有意に短縮し、全41平均と全測定ブロックが300ns未満 |
| C32-main-windows:統合した読み出し・設定配送を固定mainと比較(windows) | 個別改善を統合した際にも標準41ケースの300ns目標を満たすか確かめる。 | 全41ケースで有意に短縮し、全41平均と全測定ブロックが300ns未満 |
| D2-eq-sample:単サンプル生成時のEQ Off呼出しを省く | EQ Offでも単サンプルごとにEQ関数を呼び出している。 | 採用保留 |
| E00-baseline:基準実装の所要時間とA/A対照 | 現行41ケースの目標との差を明確にし、実装が同じ場合の測定変動を確認する。 | 全41ケースで有意差を検出せず、出力fingerprintも一致した |
| E1-conversions:エフェクトの係数換算を項目別に省く | Mixだけの変更でもDecayやDampingなどの係数を換算している。 | 棄却 |
| E10-eq-stereo:EQの左右処理をまとめる | 左右の独立処理をまとめて命令数を減らせるか調べる。 | 3短縮、Sineが0.91 ns悪化 |
| E12-reverb-conversion:Reverbの未変更設定換算を省く | Mix変更だけでもDecayとDampingの実単位換算がある。 | 棄却 |
| E12b-reverb-outline:Reverbの設定換算を別関数へ分ける | Reverbの改善が他の設定経路を悪化させる。 | 棄却 |
| E13-reverb-fill:Reverbの履歴充填数を共有 | 8本の遅延線で充填待ち回数を個別に持っている。 | 棄却 |
| E18-reverb-mix:Reverb Mixを直接更新する | Mix変更のために他のReverb値を換算・比較している。 | Reverbは約20 ns短縮 |
| E1b-conversions:Clipperの換算条件を修正 | 他の項目の変更にもClipper換算が実行される。 | 保留 |
| E2-reverb-compressor:Reverbのループ分離とCompressor逆数 | FDN内の処理依存とCompressorの除算を減らす。 | 棄却 |
| E20-chorus-cast:Chorusの整数変換を範囲に合わせる | 遅延位置のusize↔f64変換に大きい整数用の処理がある。 | C05基準の8ケースで3短縮・5差未検出、全fingerprint一致 |
| E21-eq-output:EQの固定混合係数を省く | 帯域ごとの係数が常に1や0である演算が残る。 | 採用しない |
| E25-delay-cast:Delayの遅延位置をu32で換算 | Delayの分数位置から整数添字を得る処理にusize用の広い飽和変換が残る。 | 小さい採用候補 |
| E26-compressor-time-cache:Compressorの未変更時間換算を省く | Threshold等の変更でもAttack/Releaseの正規化値からの対数換算を繰り返す。 | 採用しない |
| E27-eq-bypass:EQのOff判定を小さい入口へ分離 | scalar生成ではEQがOffでも大きいprocess_sampleへの呼出しが残る。 | 小さい採用候補 |
| E28-chorus-equality:Chorus設定の重複同値判定を省く | Effectsが変更を確認した後、Chorus入口でも6field全体を比較し、さらに更新対象ごとの比較を行う。 | 採用保留 |
| E29-compressor-threshold:CompressorのThreshold単独更新を直接適用 | Thresholdのみを動かす場合もAttack/Release等の実値換算と全体設定構築を繰り返す。 | 採用候補 |
| E30-reverb-ready:Reverbの充填完了後の読出しを分離 | 8本の遅延線が充填済みでも、各線のwarmup判定を毎sample行い、読出しとLPF/gain演算が混在する。 | 採用を見合わせる |
| E32-reverb-cells:Reverbの読書き位置の参照を再利用 | 各遅延線の同じbuffer添字をread/writeで繰り返し検査し、アドレスを計算する。 | 採用しない |
| E33-phaser-center:Phaser Centerだけの変更を直接反映する | Centerオートメーションで他4設定を換算し直し、Parametersを配送してRate変更を検査している。 | 統合比較候補 |
| E35-slot-tail:無関係なDistortionとスロット状態の更新を省く | 他FXだけの操作でも、slot末尾でDistortion設定のコピーとkind/reset判定を繰り返す。 | 採用候補として保留 |
| E36-chorus-lfo:Chorusの左右LFO更新を独立loopへ分離 | 遅延read/feedback/mixとLFO更新が同じloopにあり、左右の独立したLFOをscalar命令で更新する。 | 採用しない |
| E37-chorus-finite-min:Chorusの有限範囲でNaN選択処理を省く | Time/Depthと準備済みレートが検証されていても、可変同士のf64::minがNaN処理用の論理命令を生成する。 | 採用しない |
| E38-reverb-bounds:Reverbの遅延線境界検査を準備状態の検証へまとめる | Reverbの8本の遅延線は同一サンプルで同じ位置へ読書きするが、読み出し8回と書込み8回の境界検査が残る。 | 採用しない |
| E39-chorus-tuple:Chorusの内部ステレオ呼出しをレジスタで渡す | 非inlineのChorus処理では配列引数・戻り値にメモリを介し、入出力のロードとストアを必要とする。 | 統合比較候補 |
| E4-outline:エフェクト設定関数の展開を抑える | 設定更新の機械語を小さくできる可能性がある。 | 棄却 |
| E41-chorus-depth:Chorus Depthだけの変更を直接反映する | Depthオートメーションで他5設定の換算と構造体の配送、Timeからのcenter再計算、Rate更新判定まで毎sample繰り返す。 | 統合比較候補 |
| E42-reverb-tuple:Reverbの内部ステレオ受渡しをレジスタへ移す | 非inlineの配列引数・戻り値ではステレオ値をメモリ経由で受け渡す。 | 採用しない |
| E43-compressor-ratio:CompressorのRatio係数を変更時に保持する | 圧縮域では1−1/Ratioの同じ値をサンプルごとに除算している。 | 採用しない |
| E44-reverb-ring:Reverbの遅延線を共通カーソルのリングへまとめる | 8本の遅延線ごとにcursorとwarmupを更新し、同一frameで8回の書込み・cursor更新・周回判定を行う。 | 採用判断を保留 |
| E45-padding-block:エフェクト末尾の固定遅延を系列でまとめて処理する | 固定設定の音声系列でも、エフェクト末尾の補償遅延を各sampleで最大3回swapしている。 | 統合比較候補 |
| E46-distortion-mix:Distortion Mix変更時に固定Gainの換算を省く | MixだけのオートメーションでもClipperとGainを再構築し、固定のGainに対する10.powfを各sampleで再計算している。 | 統合比較候補 |
| E47-padding-rotate:固定遅延をrotateと履歴交換で簡潔に記述する | block単位の固定遅延を、末尾保存・copy_within・先頭差込みより少ない手順で表せるか検討する。 | 採用しない |
| E48-reverb-ring-soa:共通Reverbリングの各線を連続区間へ配置する | 8値を1frameへまとめるAoSリングは各遅延線のreadが64B strideとなる。線ごとの連続区間なら8B strideを維持できる。 | 採用しない |
| E49-delay-feedback:Delay Feedback変更時の設定再構築を省く | Feedbackだけのオートメーションでも音価・Stereoを換算し直し、全設定の比較と配送、Time更新の判定を繰り返す。 | 統合比較候補 |
| E5-limiter-off:Limiter無効時のgain計算を省く | Limiter Offでも出力に使わないgainを求めている。 | 採用を保留 |
| E51-reverb-pair-simd:Reverbの2本ずつのLPFをSSE2で計算 | 8本のdampingと帰還倍率がscalar演算で生成される。安全な2本ループE50はLPFがscalarのまま333→357命令に増加した。 | 不採用 |
| E52-compressor-tuple:Compressorのステレオ戻り値をレジスタで渡す | 非inlineの配列APIは入力と返却のためメモリを経由する。 | 不採用 |
| E53-delay-split:Delayの整数位置と小数部を時間変更時に分割 | 一定のDelay Timeでも毎sampleでfloat→u32、u32→float、小数部の差引きを繰り返す。 | 保留 |
| E55-drive-exp2:Distortion Gainをexp2で換算 | Gainの連続変更では10の累乗による振幅換算が毎sample発生する。 | 性能の採用保留 |
| E56-distortion-fade:Distortionの通常時のfade乗算を省く | 単一sample経路ではClipper切替中でなくてもWet×Mixへfade=1を掛ける。 | 統合比較候補 |
| E57-compressor-math:エフェクトの指数・対数を両OSで比較 | 圧縮ゲインや検出音量の数学関数が毎サンプルの固定費となる。 | Windowsのgainはexpが約24.47 ns短縮、Linuxの同変更は悪化 |
| E58-drive-exp-audio:E58: Distortion Gain換算と後段EQの丸め誤差 | 計算式の変更が音声へ与える誤差を確認する。 | 測定した全条件でabsolute RMS条件を通過 |
| E59-delay-bounded-cast:Delay読出し位置の限定範囲キャスト | 有限かつ2^22以下の遅延位置でも、毎sampleのfloat→u32変換に飽和処理が残る。 | 不採用 |
| E6-slots-borrow:slot定義配列のコピーを省く | setter内で720 byteの定数表をコピーしている。 | 単独採用しない |
| E60-compressor-windows-exp:WindowsのCompressorゲイン復元にexpを使う | Windowsの標準数学関数ではexp2による圧縮ゲイン復元が毎sampleの固定費となる。単体比較はexp2約27.4ns、exp約2.93nsだった。 | 不採用 |
| E61-compressor-boundary:E61: 微小Kneeでlog2換算の丸め差が増幅される | 計算式の変更が音声へ与える誤差を確認する。 | 微小Kneeの連続128サンプルで絶対誤差RMS8.66385e−4となり、−80 dBFS条件を超えるため不採用 |
| E61-compressor-linux-log2:Compressorの検出レベルをlog2へ置き換える比較 | Linuxのlog10換算はlog2より約1.8ns高価だったが、丸め誤差がsoft Kneeの境界へ影響する可能性がある。 | 不採用 |
| E62-reverb-balanced-audio:E62: Reverbの帰還加算木と丸め誤差 | 計算式の変更が音声へ与える誤差を確認する。 | 全64条件でabsolute RMS条件を通過 |
| E63-reverb-mix-audio:E63: ReverbのMix差分形と丸め誤差 | 計算式の変更が音声へ与える誤差を確認する。 | 全64条件でabsolute RMS条件を通過 |
| E64-phaser-exp-audio:Windows Phaserの指数換算と誤差 | 64sampleごとのexp2費用を省けるか検証。 | 高出力のf32 RMS超過で不採用 |
| E65-reverb-flat-storage:Reverbの8線を連続領域へ格納する比較 | 独立した8個のVecは未使用capacityと個別ptr/lenを保持し、Stateと読出しmetadataを増やしている。 | 不採用 |
| E66-reverb-boxed-lines:Reverbの固定長履歴をBox sliceで保持する比較 | 準備後に拡張しない8本のVecがcapacityを保持している。 | 速度目的では採用保留 |
| E67-chorus-depth-preparation:Chorus Depth更新の初期化判定を省く比較 | 準備済みのDepthオートメーションでも、sample rate=0かどうかを毎回判定している。 | 不採用 |
| E68-reverb-filled-kernel:充填済みReverbのwarmup判定を特殊化する比較 | 全線の履歴が充填された後も8個のwarmup判定が毎sample残る。 | 採用保留 |
| E69-effects-off-outer-guard:Offスロットの系列呼出しを外側で省く比較 | Offスロットでも系列メソッドを呼ぶ経路を、呼出し前の条件判定で省けるか確認する。 | 棄却 |
| E7-slot-dispatch:slot別設定更新を固定indexへ展開 | slot定義のコピーと不連続indexの再走査が繰り返される。 | 統合候補 |
| E70-chorus-tuple-c28:現行構成でChorusのレジスタ受渡しを再評価 | 配列のステレオ受渡しによるメモリアクセスを省けるか、係数更新・音声生成の最適化を統合した構成で確認する。 | 採用保留 |
| E71-eq-bypass-c28:現行構成でEQのOff入口分離を再評価 | 系列側のEQ Off省略を適用した構成でも、単sample経路の入口分離で呼出し費用を省けるか確認する。 | 不採用 |
| E72-slot-tail-c28:現行構成で未変更スロット末尾更新を省く比較 | 他FXだけの操作でもDistortion設定の同値書戻しとkind/reset判定を繰り返す。 | 不採用 |
| E73-compressor-chain-boundary:2段CompressorのKnee境界と指数換算の誤差 | 微小なgain換算差が後段の既存検出境界で増幅されないか確認する。 | E60不採用 |
| E74-vst-borrowed-parameters:VSTオートメーションで設定配列を参照渡しする | 区間内で設定配列を保持しても、Synthへのby-value呼出し直前に1072byteのmemcpyが毎sample残る。 | 保留 |
| E74-vst-borrowed-parameters-windows:WindowsのVST設定配送を参照渡しへ変更 | 区間内で設定配列を保持しても、Synthへのby-value呼出し直前に1072byteのmemcpyが毎sample残る。 | 採否には使用しない |
| E74-vst-borrowed-parameters-windows-clean:Windowsの参照設定配送を同条件で再測定 | 区間内で設定配列を保持しても、Synthへのby-value呼出し直前に1072byteのmemcpyが毎sample残る。 | 同じ6条件・seed2026111375・10blockの全計画を再測定した |
| E75-vst-borrowed-current:現行の疎保存とVST参照配送を組み合わせる | 参照渡しのコピー省略と、現在の疎な設定保存を組み合わせた実VST処理の速度を確認する。 | C34基準の独立した固定比較は5短縮・1差未検出・0悪化 |
| E75-vst-borrowed-current-windows:現行のVST参照配送をWindowsで比較 | 参照渡しのコピー省略と、現在の疎な設定保存を組み合わせた実VST処理の速度を確認する。 | C34基準の全6条件・10block比較は3短縮・2差未検出・1悪化 |
| E76-eq-prewarp:EQのプリワープをRMS基準で再評価 | 旧E24はRMS誤差を満たしていたが、追加のpeak条件だけで速度比較を行わずに保留していた。EQ係数更新のtanを有理式へ置き換える利益を現在の構成で確認する。 | 不採用 |
| E76-eq-prewarp-windows:WindowsでのEQ有理プリワープ比較 | 旧E24はRMS誤差を満たしていたが、追加のpeak条件だけで速度比較を行わずに保留していた。EQ係数更新のtanを有理式へ置き換える利益を現在の構成で確認する。 | 不採用 |
| E8-eq-amplitude:EQのgain倍率を保持 | 周波数だけの変更でもgainの指数換算を繰り返す。 | 7ケースで有意な改善を検出せず、24 byteの状態追加を採用しない |
| E9-selective-conversion:未変更の種類とDelay換算を省く | 他のエフェクト設定の変更でslot種類とDelayも換算している。 | 統合候補 |
| Effects-RMS-audit:既存エフェクト精度実験をRMSで監査 | 保守的に追加したpeak条件と、ユーザー指定のRMS音声精度条件を区別して採否を訂正する。 | E24/E55/E58/E62/E63は既測定RMS条件を通過 |
| Final-vst-c36:最終実装の実VST3経路比較 | 実際のVST3キュー配送と出力書込みを含む最終版の性能・精度を固定mainに照合する。 | 両OSの実VST3出力は全24条件でRMS基準を通過 |
| M3-cutoff-compressor-boundary:Cutoff指数換算と後段Compressorの誤差増幅 | 上流の微小誤差が後段Compressorの有効な極小Knee設定で増幅しないか確認する。 | 12条件の数値検証でRMS反例を確認 |
| P1-vst-pitch-only:Pitch専用キューで全パラメータ配送を省略 | PitchのみのVST3オートメーションでも各sampleで134値のsnapshotをコピーし、変更されていない通常パラメータを比較していた。 | 標準41ケースとは別の実VST3 ABI 6条件を10ブロックで比較 |
| P2-vst-parameter-range:VST3オートメーション区間でパラメータsnapshotを保持 | 通常パラメータを連続変更するVST3経路は、同じ区間内でも各sampleでSynthの134値snapshotを再取得していた。 | P1比の実VST3 ABI追加6条件で2短縮・4差未検出・0悪化、全60音声ペアbit一致 |
| P3-vst-automation-dispatch:VST3の無変更区間とオートメーション配送を整理 | VST3の連続変更では各sampleで134値snapshotを取り直し、Pitchだけでも通常設定の比較へ配送していた。無変更区間への余分な判定も避けたい。 | C25を基準とした追加VST3 ABI6条件の10ブロック比較は6短縮・0悪化、全60音声ペアbit一致 |
| P3-vst-automation-dispatch-windows:VST3配送の整理をWindowsで比較 | Linuxで有効なPitch専用配送と区間snapshot保持が、Windows MSVCの実VST3 callbackでも有効か確認する。 | 追加VST3 ABI6条件の10ブロック比較は5短縮・1差未検出・0悪化、全60音声ペアbit一致 |
| R10-limiter-peaks:Limiterのピーク履歴の境界検査を省く比較 | Limiterのピーク履歴は準備時に非空の2冪長を確保し添字をmaskするが、サンプル処理にも境界検査が残る。 | 採用しない |
| R11-limiter-inline:Limiter単sampleの強制inline比較 | Limiterの系列ループにもsampleごとの関数呼出しが残る。 | 不採用 |
| R12-numeric-copy:数値が変わったDSP設定だけを保存する比較 | 少数の設定変更でもDSP cacheの全134値を保存する。 | 疎保存は単一変更で約6 ns、4項目で約4.8 ns短縮 |
| R13-limiter-block-linux:Limiterの系列loopだけで呼出しを省く(linux) | 単sample側への大きい本体の展開を避けつつ、系列loopの毎sample呼出しを省く。 | 採用候補 |
| R13-limiter-block-windows:Limiterの系列loopだけで呼出しを省く(windows) | 単sample側への大きい本体の展開を避けつつ、系列loopの毎sample呼出しを省く。 | 採用候補 |
| R14-numeric-snapshot-linux:変更値だけのDSP設定保存を音源で比較 | 連続操作のたびに134値を全保存する処理を減らす。 | 採用候補 |
| R14-numeric-snapshot-windows:変更値だけのDSP設定保存をWindowsで比較 | 連続操作のたびに134値を全保存する処理を減らす。 | 保留 |
| R15-numeric-snapshot-outline-linux:設定保存を配送本体から分離する(Linux) | 疎保存の展開によって配送関数が大きくなり、無関係な演奏ケースを遅くすることを避ける。 | 共通採用は保留 |
| R15-numeric-snapshot-outline-windows:設定保存を配送本体から分離する(Windows) | 疎保存の展開によって配送関数が大きくなり、無関係な演奏ケースを遅くすることを避ける。 | 採用候補 |
| R16-limiter-bypass-block:Limiter Offの出力計算を系列入口で省く | Offでも維持する検出履歴から、出力に使わないgain計算だけを除く。 | 不採用 |
| R17-prepared-rate-linux:定常Voice区間のレート比較を先頭へまとめる | 同じレートを準備した後もPREPARED系列が毎sampleレートを比較する。 | 不採用 |
| R17-prepared-rate-windows:定常Voiceのレート比較を入口へまとめる(Windows) | 同じレートを準備した後もPREPARED系列が毎sampleレートを比較する。 | 不採用 |
| R18-limiter-masked-head:Limiter queueの先頭添字をmaskで表す | 先頭添字は常にqueue範囲内だが、LLVMに境界が伝わらず追加の検査がある。 | 不採用 |
| R19-numeric-snapshot-multi-linux:変更値だけの設定保存で複数操作を比較 | 疎な設定保存が同時に複数の設定群を動かす場合にも有効か確かめる。 | 追加5条件で3短縮・2差未検出・悪化0、全50音声ペア一致 |
| R19-numeric-snapshot-multi-windows:変更値だけの設定保存で複数操作を比較(Windows) | 疎な設定保存が同時に複数の設定群を動かす場合にも有効か確かめる。 | Windows MSVC/Wine 11の追加5条件で3短縮・2差未検出・悪化0、全50音声ペア一致 |
| R2-single-oscillator:単一発振器の経路を定数で指定 | Osc2/3の1発振器経路でも一般のユニゾン数の判定が残る。 | C15との全41比較で11ケース短縮・有意な悪化0 |
| R20-limiter-bounded-size-linux:Limiter履歴長の整数変換を狭める(linux) | 最大65536の履歴長をusizeからf64へ毎sample換算している。 | 採用保留 |
| R20-limiter-bounded-size-windows:Limiter履歴長の整数変換を狭める(windows) | 最大65536の履歴長をusizeからf64へ毎sample換算している。 | 採用保留 |
| R21-master-rounding-grid:Master指数換算とfloat32丸め境界 | 音量係数の微小差が大振幅のfloat32丸めで絶対誤差上限を超えないか確認する。 | RMS精度条件に合格 |
| R3-voice-stereo-return:Voiceのステレオ戻り値をレジスターへ移す | 配列の戻り値の受渡しに間接書込みと読出しが発生している。 | 全41ケースで短縮0・差未検出27・悪化14 |
| R4-codegen1:コード生成単位を1つへまとめる | コード生成単位の分割を減らすことで、呼出しや最適化境界が改善するか調べる。 | 全41で5短縮・20差未検出・16悪化 |
| R5-thin-lto:Thin LTOによる関数間の最適化 | ソースを複雑化せず、安定したビルド設定だけで速度を改善できるか調べる。 | 全41で1短縮・31差未検出・9悪化 |
| R6-codegen1-thin:コード生成単位1とThin LTOの組合せ | ソースを複雑化せず、安定したビルド設定だけで速度を改善できるか調べる。 | 全41で9短縮・30差未検出・2悪化 |
| R7-limiter-master-loop:LimiterとMasterの出力ループをまとめる | Limiter処理後に別ループでMaster音量を掛け、同じ音声配列を再読出ししている。 | 不採用 |
| R8-bounded-exp2:小テーブルによるカットオフ倍率換算 | Windowsのexp2に汎用の補助処理が多い。 | Windowsでは約28→3.1 nsへ短縮、Linuxでは悪化 |
| R9-borrowed-setter:借用setterで配列コピーを省けるか確認 | 連続設定更新の134値のコピーを減らす。 | 静的比較で対象のコピーとsetter命令数が変わらず不採用 |
| V1-envelope-slope:エンベロープの傾きを区間境界で計算する | 線形エンベロープでサンプルごとに除算と範囲制限を行う。 | この版は採用保留 |
| V10-direct-banded:帯域波形だけ直接出力する | 直接書込みの変更範囲をさらに絞って副作用を確認する。 | 棄却 |
| V11-mono-pan:単発振器の定位配列コピーを省く | Osc2/3へ112 byteの7組定位係数を組み立てて渡している。 | 13ケースで短縮、10ケースは差未検出 |
| V12-bounds:範囲既知の波形参照を簡略化 | 波形表への参照で範囲検証が重複している。 | 棄却 |
| V13-pm-capture:位相変調closureを値捕捉にする | closure経由の参照・再読込みを減らせるか調べる。 | 棄却 |
| V14-signed-envelope:Envelopeの残り回数を符号付きにする | usize残り回数からf64への変換を短縮する。 | 9短縮、2悪化 |
| V15-unison-sse2:2ユニゾンの波形補間を並列化 | 独立したユニゾンの波形読出しと補間を逐次処理している。 | 23ケース中18短縮、1悪化、4差未検出 |
| V16-output-buffer:Voiceの作業配列を3発振器で共用 | 3発振器の各戻り値に一時配列とコピーが生じる。 | O1+M1を基準とした24ケースで23短縮・1差未検出 |
| V17-filter-outline:フィルタ係数の再計算処理を分離 | フィルタ係数の構築処理がVoiceの生成関数へ展開され、命令列が大きい。 | 全41ケースで37悪化・4差未検出 |
| V18-filter-stage-clear:2段目の同値書き戻しを省く | 2段フィルタで、履歴へ全bit有効のmaskを掛けて同じ値を書き戻している。 | 全41ケースは差未検出、音声fingerprintは一致 |
| V19-filter-outline-reference:係数再計算の戻り値を参照にする | 分離した係数計算は、キャッシュ一致時も24 byteの係数をstackへ書き、呼出し合流後に読み直していた。 | C09からの全41ケースで1短縮・13悪化・27差未検出 |
| V2-envelope-remaining:Envelopeの残りsample数を再利用 | 線形区間内でも同じ時間換算と除算が繰り返される。 | 統合候補 |
| V20-filter-cache-niche:フィルタ係数キャッシュの空状態を圧縮 | SVFのOptionキャッシュが追加の判別領域を持ち、各Filterに32 byteの余分な領域がある。 | 全41ケースで4短縮・37差未検出・悪化0 |
| V21-phase-sse2:ユニゾンの位相をSSE2で同時更新 | 生成後の位相更新がユニゾンごとのscalar演算と個別のcount分岐へ展開されている。 | 全41ケースで有意な悪化が広く生じ、採用しない |
| V22-three-oscillator-dispatch:3発振器の固定順序を定数添字で配送 | 固定されたOsc3→2→1のループでも、実行時の添字・定位選択・変調先選択が残っている。 | 全41ケースで有意な悪化はなく、音声fingerprintは一致 |
| V23-phase-sse2-mono:1声の元式を維持した位相SSE2更新 | 2要素単位の位相更新では、単独発振器にもpair判定と動的な末尾処理が増える。 | 単音の大きい悪化は軽減したが、全41ケースの一部に有意な悪化が残り、採用しない |
| V24-modulation-mode-setter:位相変調の有効フラグを設定時に更新 | Mod設定から一意に決まる有効フラグを、各サンプルで3発振器へ再計算・代入している。 | 全41ケースでは重いReverb・Chorusを短縮した一方、一部に有意な悪化があり単独採用を保留する |
| V25-table-compact:帯域テーブル参照情報の圧縮と直接保持 | 波形補間のたびに選択情報からテーブル構造体を介して長さとオフセットを読む依存ロードがある。 | 全41ケースの10ブロック比較で短縮0、差未検出22、悪化19 |
| V26-envelope-niche:Envelopeの入力キャッシュの判別領域を共有 | Envelope入力キャッシュのOption判別領域が独立し、各Voiceに2個あるEnvelopeのサイズが136Bとなっている。 | 全41ケースの10ブロック比較で短縮1、差未検出37、悪化3 |
| V27-filter-validation:SVF設定の検証を係数更新時へまとめる | 同じ周波数・Q・レートでも毎サンプル入力設定を検証している。 | 全41ケースの10ブロック比較で短縮14、差未検出21、悪化6 |
| V28-wave-index:波形セル添字の不要な符号拡張を省く | SSE2で得たi32の波形セル番号をusizeへ直接変換すると、非負と分かっている添字にも64bitへの符号拡張が入る。 | 全41ケースの10ブロック比較で短縮6、差未検出35、悪化0 |
| V29-envelope-cast:通常範囲のサンプル数を符号付き整数から換算 | u64からf64への変換では上位bitを含む値への対応が毎サンプル実行され、通常のサンプル位置にも複数命令が必要となる。 | 単独のasmでは通常経路がcvtsi2sdへ短縮したが、全41ケースの10ブロック比較では短縮0、差未検出12、悪化29 |
| V3-prewarp:プリワープを有理式へ置き換える | フィルタ周波数の変化中にtanを繰り返す。 | 保留 |
| V30-envelope-asm:通常サンプル数の換算をinline assemblyで固定 | 純Rustの条件付き変換はunsigned換算へ再統合され、cold helper分離では全体性能が悪化した。 | debug/release各13テストと全410音声hash一致 |
| V31-band-inline-linux:通常帯域波形のinline展開:Linux | 通常帯域波形の入口を分離しているため毎サンプルcallが入り、Windowsでは多ユニゾン側でXMM10本の保存と復元が必要となる。 | Linux全41ケースの10ブロック比較で短縮2、差未検出13、悪化26 |
| V32-band-inline-windows:通常帯域波形のinline展開:Windows | Windowsの多ユニゾン波形入口がXMM10本を毎回保存・復元している。 | MSVC/Wine11全41ケースの10ブロック比較で短縮10、差未検出20、悪化11 |
| V33-band-sysv-windows:通常帯域波形の非公開関数でSysV呼出し規約を比較 | Windowsの帯域波形関数はXMM6〜15を保存・復元し、各Voiceの反復呼出しで費用が生じる。 | Windows全41条件の10対応ブロックで5短縮・33差未検出・3悪化 |
| V34-voice-inline-linux:Voiceの単サンプル本体を親のボイスループへ展開 | 各Voiceのサンプル入口で関数呼出しとレジスタ保存が反復する。 | Linux全41条件の10対応ブロックで、重いReverb +2.902 ns、Chorus +2.998 ns、Compressor +8.299 nsなどが悪化した |
| V35-voice-inline-windows:Voiceの単サンプル本体を親ループへ展開:Windows | WindowsのVoice単サンプル入口は各呼出しでXMM6本を保存し、4音の反復でも同じ費用が掛かる。 | Windows全41条件の10対応ブロックで12短縮・28差未検出・1悪化 |
| V36-math-runtime:Windowsの指数換算費用を切り分ける | Windowsの連続カットオフ処理がLinuxより重い。 | Windows exp2は26〜27 ns、exp換算は約2.91 ns |
| V37-windows-cutoff-exp:Windowsの動的カットオフ倍率をexpで求める | Windows CRTのexp2は動的カットオフ倍率の更新1回に約26〜27nsを要する。標準Padの複数Voiceでは反復費用が支配的になる。 | Windows全41条件の10ブロック比較で11短縮・27差未検出・3悪化 |
| V38-unison-slices:SSE2ユニゾンの反復を同長sliceで処理 | 通常波形の2ユニゾン読出しは固定配列をindexで参照しており、反復ごとに範囲検査が残る可能性がある。 | 全41条件の10対応ブロックで短縮0・差未検出34・悪化7 |
| V39-unison-avx:4ユニゾンのAVX補間 | 通常波形のユニゾン読出しで、2laneのSSE2より並列幅を広げられるか検証する。 | 全41条件の10対応ブロックは短縮5・差未検出13・悪化23 |
| V4-sine-cast:Sineの範囲既知キャスト | 範囲が既知のfloat→int変換に飽和判定が残る。 | 棄却 |
| V40-oscillator-layout:Oscillatorのホットフィールドを近接配置 | 通常サンプル生成で使用する位相・増分・ユニゾン数・波形テーブルが別々のキャッシュラインに位置する。 | 全41条件の10対応ブロックで短縮0・差未検出40・悪化1 |
| V41-sine-grid:正弦波の象限と補間区間を1回の整数変換で取得 | 正弦波の通常読出しでは象限と四半周期の補間セルを別々にfloatから整数へ変換している。 | 全41条件の10対応ブロックで短縮3・差未検出35・悪化3 |
| V42-remove-raw-pm:製品が使用しない生波形PM経路の削除 | 通常発音でも位相offsetを整数化・小数化し、非ゼロoffsetをwrapする経路が残っていた。製品のVoiceはModが有効なら必ずADAA2を選び、無効時のoffsetは±0である。 | Linux全41条件の10対応ブロックで短縮16・差未検出25・悪化0 |
| V43-remove-raw-pm-windows:未使用の生波形PM削除:Windows比較 | 通常発音でも位相offsetを整数化・小数化し、非ゼロoffsetをwrapする経路が残っていた。製品のVoiceはModが有効なら必ずADAA2を選び、無効時のoffsetは±0である。 | Windows MSVC/Wine11の全41条件・10対応ブロックで短縮22・差未検出19・悪化0 |
| V44-filter-two-stages:SVFの1段目と2段目を固定添字で明示 | Filterの段数は1または2なのに、動的添字のloopで両段を処理している。添字とloop末尾の判定を省けるか調べる。 | 全41条件の10対応ブロックで短縮2・差未検出22・悪化17 |
| V45-envelope-inline:Envelopeの更新を呼出し元へ展開 | Voiceごとに2回呼ぶEnvelope::update_sampleが独立callとなり、active/Inputの再読出しと呼出し費用を持つ。 | Linux全41条件の10対応ブロックで短縮4・差未検出33・悪化4 |
| V46-lazy-adaa-bank:位相変調が有効な発振器だけ原始関数の帯域を準備 | 周波数が連続的に変わる区間で、位相変調を使わない発振器もADAA原始関数の帯域を毎回探索・保持している。 | Linux全41条件の10対応ブロックで短縮2・差未検出38・悪化1 |
| V47-lazy-adaa-bank-windows:位相変調を使わない帯域準備省略のWindows評価 | 周波数が連続的に変わる区間で、位相変調を使わない発振器もADAA原始関数の帯域を毎回探索・保持している。 | Windows MSVC / Wine 11、全41条件の10対応ブロックで短縮4・差未検出35・悪化2 |
| V48-adaa-valid-hoist:無変調時のADAA履歴無効化を準備時へ移す | Noiseと無変調の周期波は毎サンプル同じvalid=falseを書き込む。 | Linux全41条件、10対応ブロックですべて差未検出 |
| V49-lazy-adaa-bank-u8:ADAA帯域準備省略でState配置を維持する | 変調を使わない発振器の原始関数帯域準備を省く最初の案では、bool追加がStateのフィールド配置を変え、他の処理を遅くした。 | Linux全41条件、10対応ブロックで短縮3・差未検出38・悪化0 |
| V5-table-cache:波形表の位置と長さを保持 | 選択した波形表の位置と長さを繰り返し参照する。 | 棄却 |
| V50-lazy-adaa-bank-u8-windows:配置を維持したADAA帯域準備省略のWindows評価 | 変調を使わない発振器の原始関数帯域準備を省く最初の案では、bool追加がStateのフィールド配置を変え、他の処理を遅くした。 | Windows MSVC / Wine 11、全41条件の10対応ブロックで短縮2・差未検出39・悪化0 |
| V51-adaa-floor-windows:WindowsのADAA位相折返しを厳密な切捨てと補正で計算 | ADAAは評価点ごとにfloorを呼ぶ。Windowsの実asmではCRT関数の呼出しが残る。 | Windows全41条件の10対応ブロックで短縮0・差未検出38・悪化3 |
| V52-pm-phase-update:ADAA履歴と保持位相の更新で計算を共有 | ADAA履歴の折返し補正と保持位相の更新が、同じphase+incrementと周期判定をそれぞれ計算する。 | Linux全41条件の10対応ブロックで短縮0・差未検出40・悪化1 |
| V53-adaa-floor-inline-windows:Windowsの位相折返しと原始関数展開を同時に評価 | floorの有界整数変換案ではp1/p2/rawのoutline化により、新たな内部関数呼出しが増えた。 | Windows全41条件の10対応ブロックで短縮1・差未検出38・悪化2 |
| V54-adaa-index:ADAAテーブルの非負インデックスをzero extensionで広げる | 位相から求めたセル番号は非負だが、i32からusizeへの変換が符号拡張として残る。 | 無施錠asm集計と重なった原測定を保全し、全41条件を同seed・同条件で再測定した |
| V55-adaa-bounds:ADAAセルの境界検証を不変条件の下で省略する | ADAAは1セル内の6係数を読むたびに、同じ共有データの境界を個別に検証している。 | Linux全41条件・10対応ブロックで2条件短縮、39条件差未検出、悪化なし |
| V56-adaa-bounds-windows:WindowsでのADAAセル境界検証省略 | ADAAは1セル内の6係数を読むたびに、同じ共有データの境界を個別に検証している。 | Windows全41条件・10対応ブロックで4条件短縮、37条件差未検出、悪化なし |
| V57-adaa-sse41-windows:SSE4.1でADAAの位相折返しを同じfloor式のまま評価する | WindowsのADAA位相折返しはfloorランタイム呼出しを繰り返す。 | Windows全41条件・10対応ブロックで4条件短縮、36条件差未検出、1条件悪化 |
| V58-adaa-safe-cell:ADAAの係数を安全な48バイトセルとして一括取得する | 1セル6係数の個別読出しが重複した境界検証を生成する。 | Linux全41条件・10対応ブロックで6条件短縮、35条件差未検出、悪化なし |
| V59-adaa-safe-cell-windows:WindowsでもADAAセルを安全なスライスとして取得する | 1セル6係数の個別読出しが重複した境界検証を生成する。 | Windows全41条件・10対応ブロックで4条件短縮、37条件差未検出、悪化なし |
| V6-prepared-entry:単sample入口で準備済み経路を選ぶ | 発振器準備済みでも単sample生成が一般経路を通る。 | 棄却 |
| V60-pm-single-series:位相変調の系列生成でOsc2/3を1発振器として特殊化する | 単サンプル入口には1発振器専用処理があるが、位相変調の系列入口ではOsc2/3も可変ユニゾン用処理を通る。 | Linux全41条件・10対応ブロックで2条件短縮、38条件差未検出、1条件悪化 |
| V61-pm-single-series-windows:Windowsでの位相変調系列の1発振器特殊化 | 単サンプル入口には1発振器専用処理があるが、位相変調の系列入口ではOsc2/3も可変ユニゾン用処理を通る。 | Windows全41条件・10対応ブロックで3条件短縮、38条件差未検出、悪化なし |
| V62-avx-fallback:AVX4の生成経路を既存SSE2 fallbackから分離する | AVX4の初回試作では3ユニゾン以下のSSE2経路にも可変offsetが混ざり、多数の条件が遅くなった。 | Linux全41条件・10対応ブロックで5条件短縮、16条件差未検出、20条件悪化 |
| V63-final-miri:最終DSP差分の重点Miri検証 | 新しいSSE2・SINGLE・ADAAセル・Voice間cacheの境界とメモリ安全性を確認する。 | 6項目成功 |
| V64-rms-policy-audit:Envelope・プリワープの誤差指標の再評価 | 以前の追加peakゲートと、今回のabsolute RMS要件を区別する。 | この6比較のabsolute RMS超過は0件 |
| V65-math-compressor-boundary:Envelope・プリワープ変更の下流境界検査 | 通常波形では許容内の微小差が、後段の有効な設定で増幅されないか調べる。 | 両案とも最大RMS約1.89e−4で不採用 |
| V66-final-audio:最終C36の音声精度検証 | 統合後DSPの波形誤差と静音を両対応OSで確認する。 | 1,662条件すべて成功 |
| V7-prewarp-hybrid:小さい引数のプリワープを短縮 | 小さい引数でも長い有理式を評価している。 | 6短縮、Sineが0.69 ns悪化 |
| V8-direct-output:発振器の出力配列への直接書込み | 波形ごとの生成結果からOscillatorSampleへの配列コピーがある。 | 17短縮、位相変調が2.24 ns悪化 |
| V9-direct-periodic:通常周期波だけ出力先を共通化 | 直接書込みの位相変調経路への影響を切り分ける。 | 棄却 |
| final-linux-44100-64:最終版の標準41ケース比較:linux 44,100Hz / 64sample | 固定mainに対して全41ケースの生成時間300ns以下と、特定条件の速度悪化がないことを最終確認する。 | 41ケース中41短縮・0差未検出・0悪化 |
| final-linux-48000-256:最終版の標準41ケース比較:linux 48,000Hz / 256sample | 固定mainに対して全41ケースの生成時間300ns以下と、特定条件の速度悪化がないことを最終確認する。 | 41ケース中41短縮・0差未検出・0悪化 |
| final-linux-96000-512:最終版の標準41ケース比較:linux 96,000Hz / 512sample | 固定mainに対して全41ケースの生成時間300ns以下と、特定条件の速度悪化がないことを最終確認する。 | 41ケース中41短縮・0差未検出・0悪化 |
| final-windows-44100-64:最終版の標準41ケース比較:windows 44,100Hz / 64sample | 固定mainに対して全41ケースの生成時間300ns以下と、特定条件の速度悪化がないことを最終確認する。 | 41ケース中41短縮・0差未検出・0悪化 |
| final-windows-48000-256:最終版の標準41ケース比較:windows 48,000Hz / 256sample | 固定mainに対して全41ケースの生成時間300ns以下と、特定条件の速度悪化がないことを最終確認する。 | 41ケース中41短縮・0差未検出・0悪化 |
| final-windows-96000-512:最終版の標準41ケース比較:windows 96,000Hz / 512sample | 固定mainに対して全41ケースの生成時間300ns以下と、特定条件の速度悪化がないことを最終確認する。 | 41ケース中41短縮・0差未検出・0悪化 |
誤差評価の基準/音声誤差の追加検証/大振幅の丸め誤差/Windows cutoff換算の誤差/指数換算の音声誤差/命令数の内訳/測定品質と中断試行
最も重いのはReverb Mixの連続操作(458.244 ns)。Chorus Depth・Compressor Threshold・Phaser Center・EQ周波数の連続操作も300 nsを超える。変わらないパラメーターの換算、設定差分の走査、毎sampleの係数更新を先に調べる。
Voice側では、複数ノート・ユニゾン・エンベロープ・フィルタの処理を分解して確認する。誤差が増幅しやすい強い位相変調、高いQ、急速な設定変更を音声比較へ加える。