Repository navigation
Releases: 6hdj/lrc-ttml
Release list
Lyric2TTML v1.2.1 —— 便携版(解压即用)

Lyric2TTML v1.2.1 —— 便携版修复(v1.2.0 的附件是"更新补丁",不是完整程序)
⚠️ v1.2.0 的附件Lyric2TTML-winui-v1.2.0-update.zip只是"更新补丁"
(只含 WinUI 壳 + 后端 exe,不含后端_internal运行库),单独运行会报
Failed to load Python DLL ... python314.dll。本次 v1.2.1 提供解压即用的便携版。
下载哪个?
| 文件 | 用途 |
|---|---|
Lyric2TTML-winui-v1.2.1-portable.zip(414 MB) |
解压即用:壳 + 后端(含 CUDA 运行库组件之外的全部 Python 依赖与模型框架) |
Lyric2TTML-winui-v1.2.1-update-patch.zip(64.8 MB) |
仅壳 + 后端 exe,给已有安装覆盖升级用 |
便携版首次使用
- 解压整个 zip,双击
winui\Lyric2TTML.exe - 模型管理 → 下载 Whisper 模型(魔搭官方源,约 20 MB/s;large-v3 约 2 分钟)
- 运行库 → CUDA 运行时「安装/修复」(527 MB,腾讯镜像,实测 22 秒)
- (可选)运行库 → Demucs Worker「安装」(约 86 秒,人声分离用)
本版修复
- 便携包内后端找不到模型:
web_server把HUGGINGFACE_HUB_CACHE默认指到_internal\.hf_cache,
而下载器写的是data\models\hf_cache⇒ 现在统一对齐;service_main同步该变量。 - 后装 CUDA 不生效:ASR 的 CUDA DLL 搜索路径新增
<数据目录>\runtime\cuda{,/bin},
并在每次创建识别引擎时重新注册 ⇒ 先开程序、再去运行库页装 CUDA,无需重启即可用显卡。 - 便携包不再捆绑 CUDA(2 GB),改为运行库页一键安装 ⇒ 包体从 2.37 GB 降到 414 MB(<2 GiB GitHub 限制)。
已验证(本版产物)
- 解压后的便携包:逐页自检 8/8;后端正常启动;4/7 模型就绪(campplus×3 + demucs),
Whisper 三个模型均可下载(官方源)。 - 完整流程实测:安装 CUDA(22 s)→ 下载 whisper-small(17 s)→ 真实转换 0 错误 / 63 行。
- 完整安装版(本地 9.7 GB 运行目录):7/7 模型就绪、真实转换 0 错误。
说明
- 仓库不再上传 6.4 GB 的完整后端(含 torch/CUDA),超过 GitHub 单文件 2 GiB 限制;
完整安装版请按docs/WinUI3-版本说明.md在本地构建,或用旧 Qt 安装包(v1.1.1)。 - 本机安全策略可能禁止程序写外部目录:设置里的「歌词保存到」建议用程序目录内子目录。
界面截图(WinUI 3,真实运行)
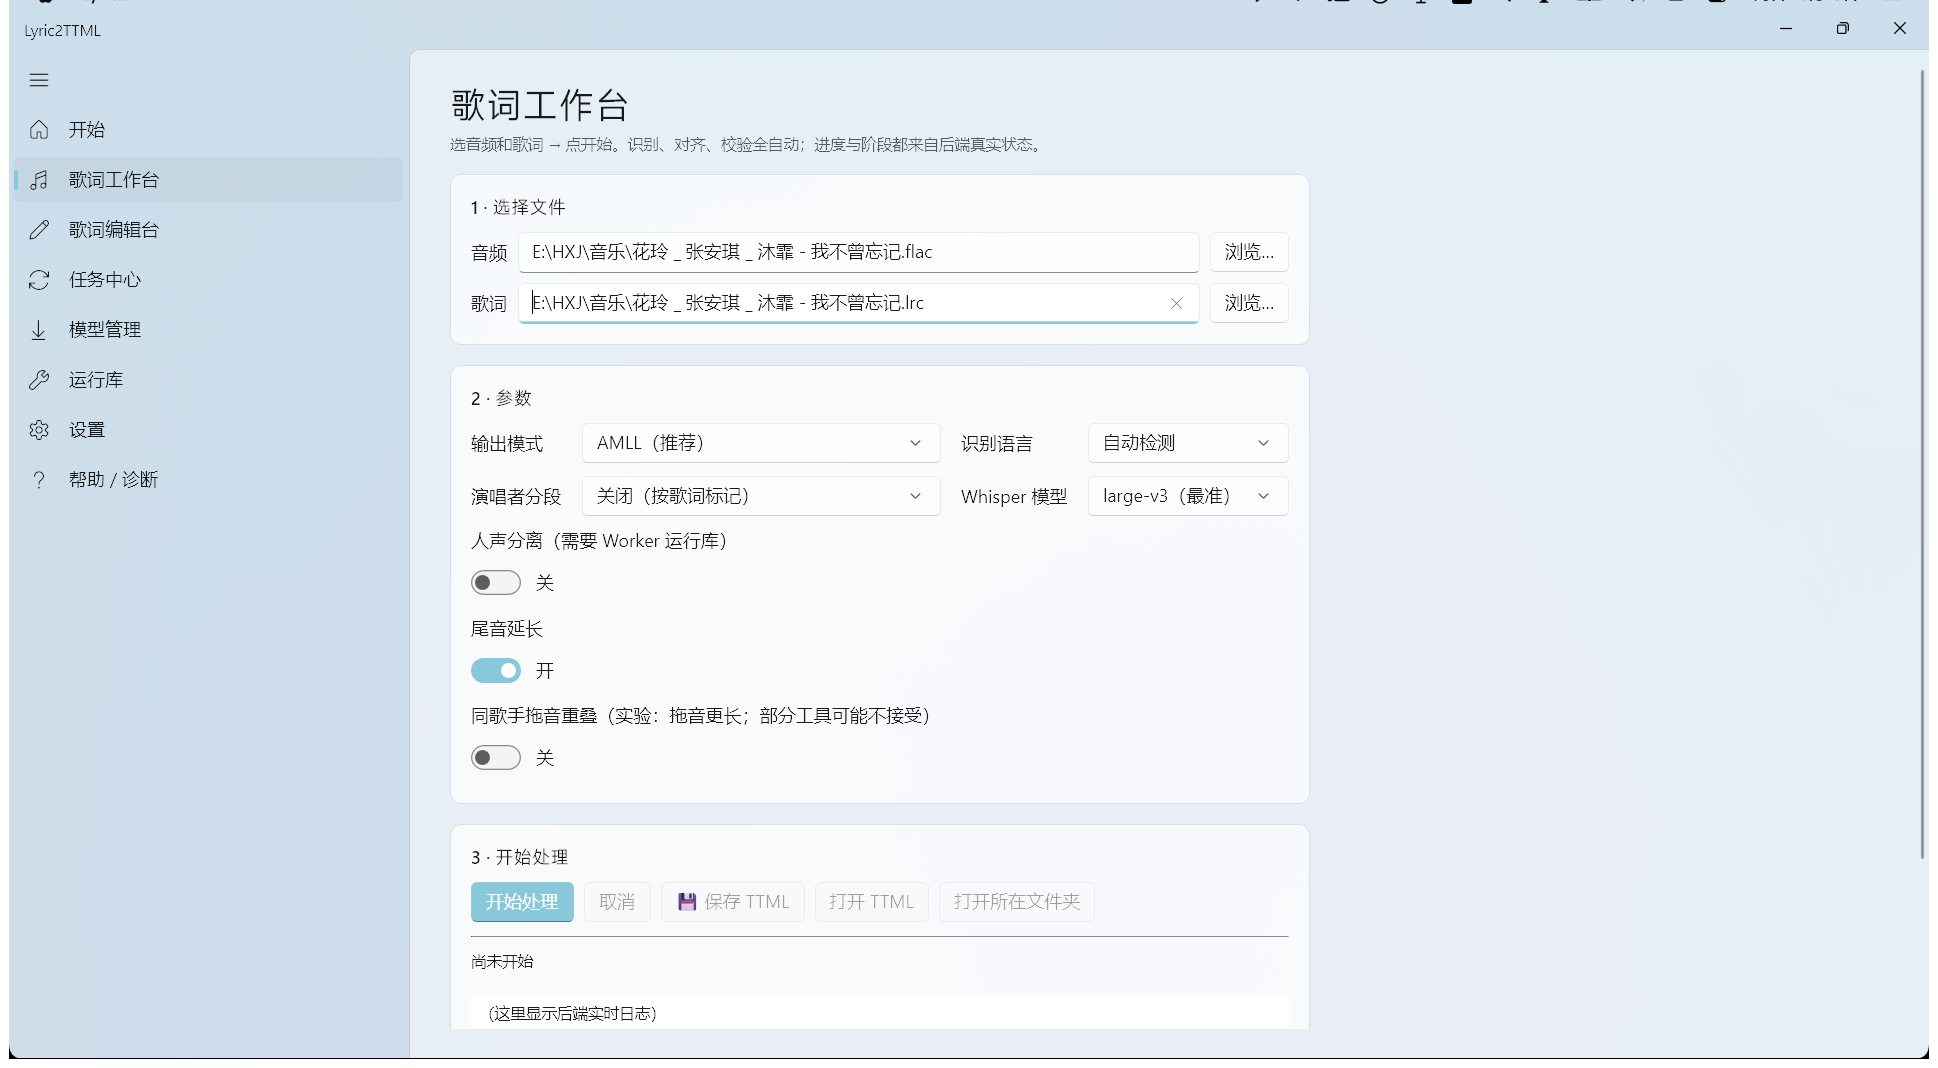
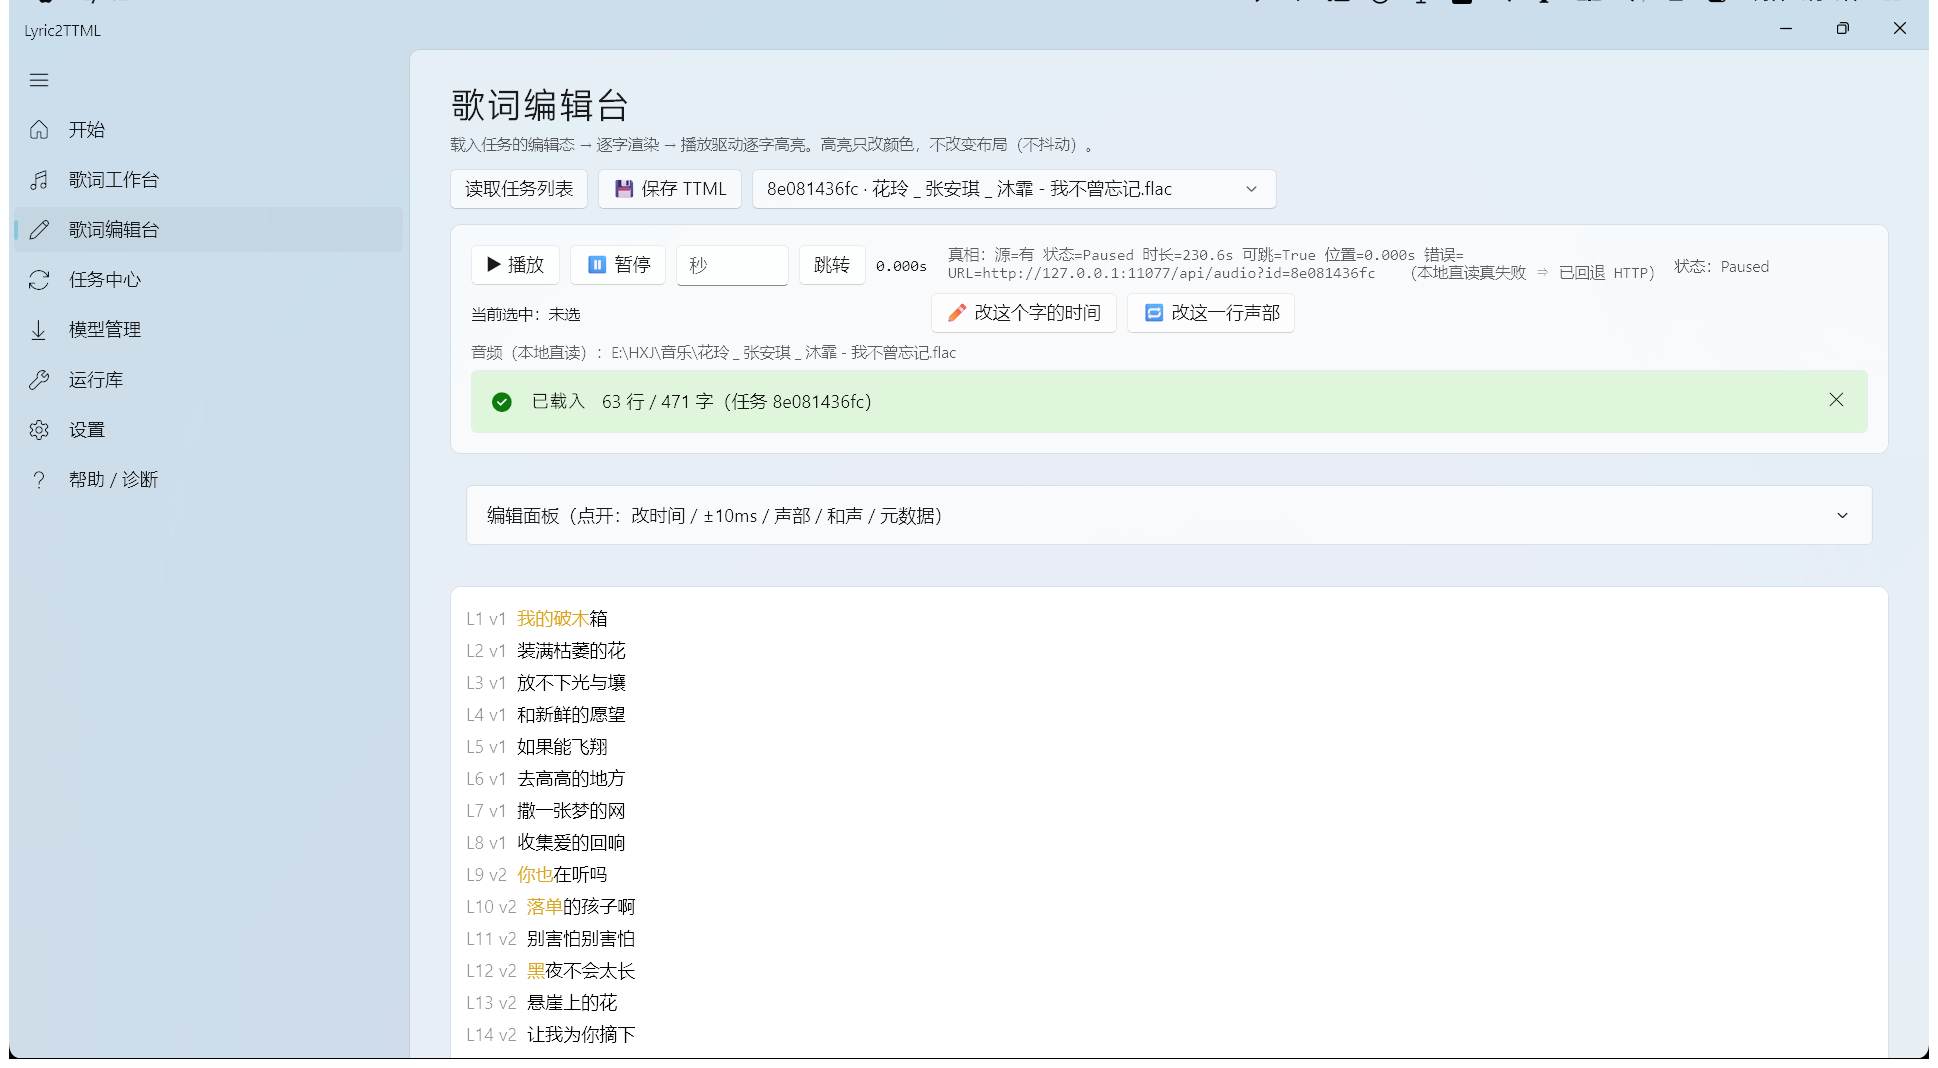
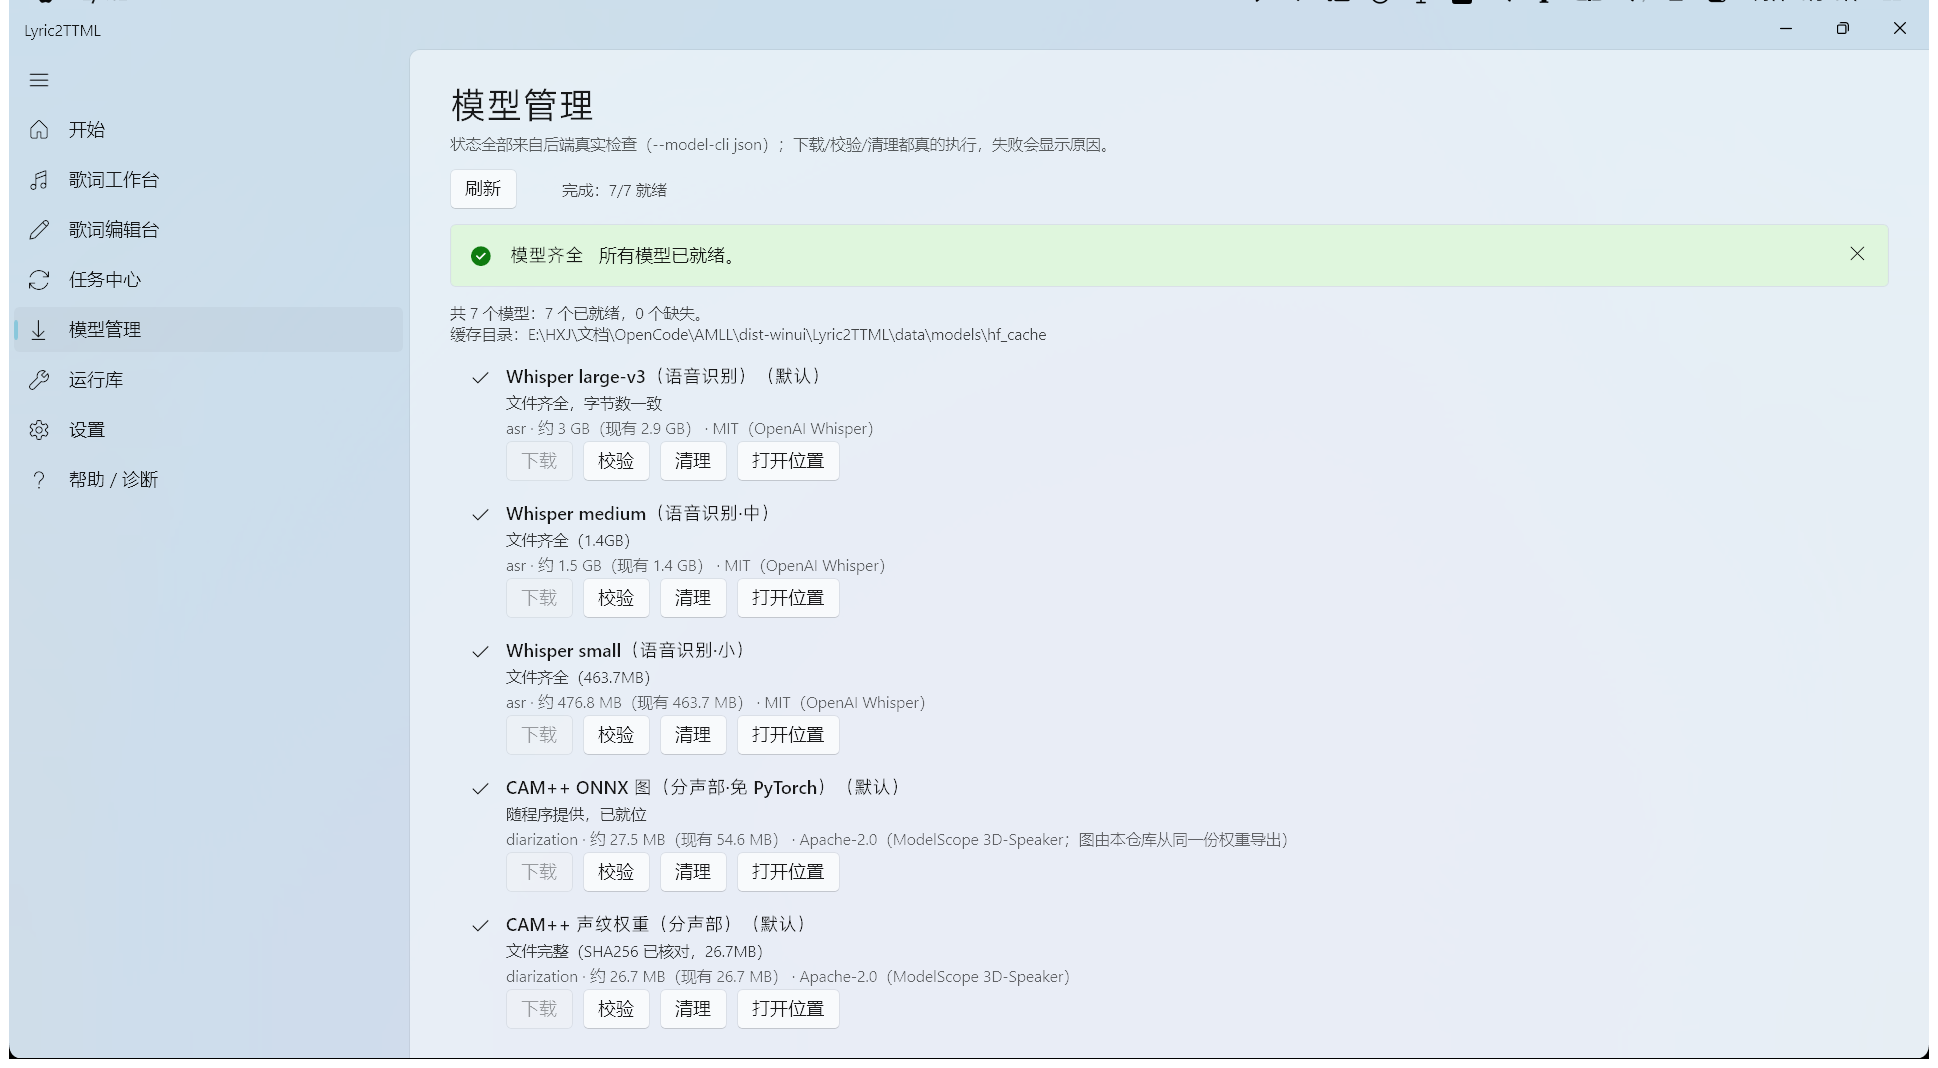
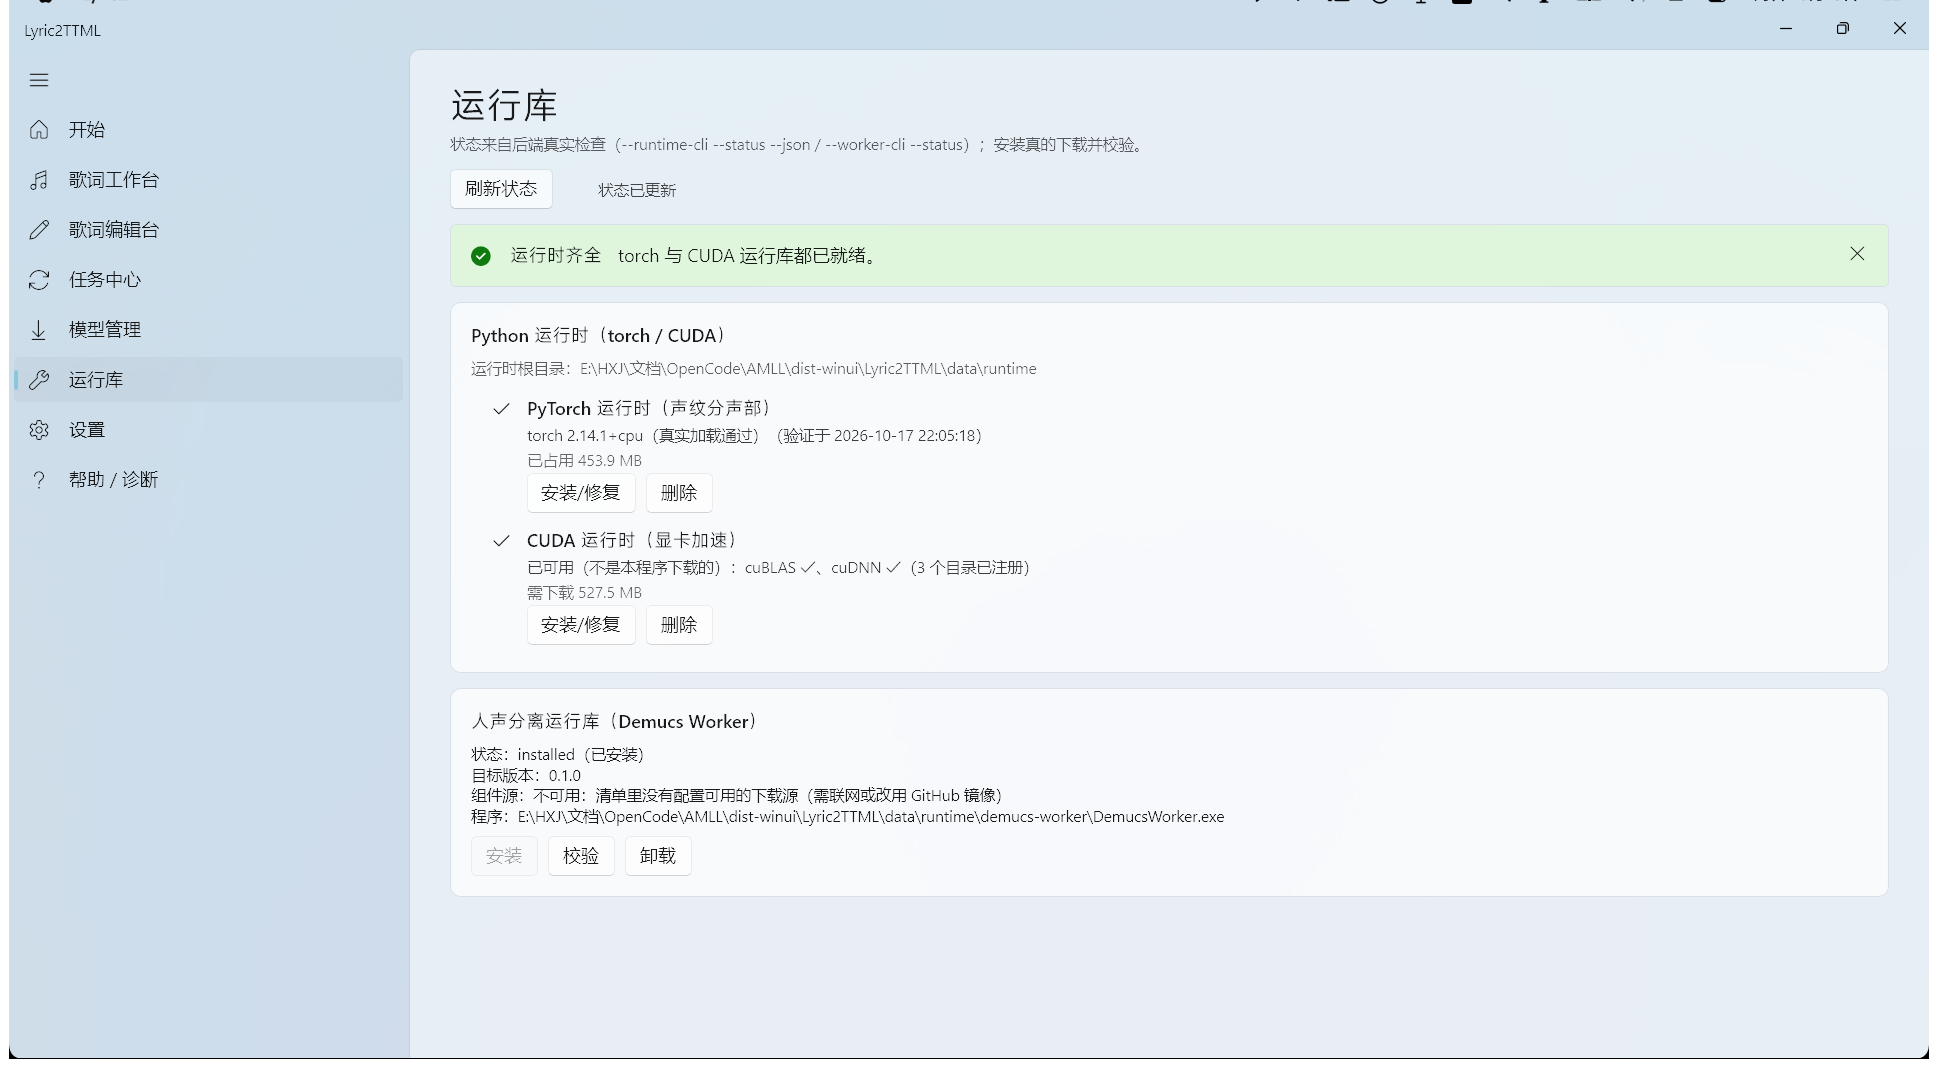
截图由程序真实运行(后端已启动、编辑台载入真实任务)后抓取;全部 8 页见仓库
docs/winui/。
2026-10-18 附件更新(无版本号变更)
- 软件加入应用图标(紫色「字」+ 时间轴):exe、任务栏、窗口标题栏生效。
Lyric2TTML-winui-v1.2.1-portable.zip已替换为带图标版本(415 MB),下载地址不变。
2026-10-18 附件修复(同一版本,下载地址不变)
- 修复便携版「运行库 → PyTorch 运行时」安装后真实加载验证失败:
ModuleNotFoundError: No module named 'timeit' / 'pickletools'。
原因是 PyInstaller 冻结后端缺少 torch 导入所需的标准库模块;已补进打包并在解压后的便携包里实测
torch 2.14.1+cpu(真实加载通过)。 Lyric2TTML-winui-v1.2.1-portable.zip已重新打包覆盖(sha256bc2232bd…)。
Lyric2TTML v1.2.0 —— WinUI 3 界面 + 模型/运行库下载修复
Lyric2TTML v1.2.0 —— WinUI 3 界面 + 模型/运行库下载修复
一、界面:全新 WinUI 3 壳
- 界面迁移到 WinUI 3(C# / XAML),保留原算法与后端能力:
开始 / 歌词工作台 / 歌词编辑台 / 任务中心 / 模型管理 / 运行库 / 设置 / 帮助诊断,全部为真实页面(无占位)。 - 页面缓存(切页不重建):正在跑的任务、日志、已选文件不会因为切页被清空。
- 主题:浅色 / 深色 / 跟随系统,选中即预览,保存后持久化;深色下歌词、编辑面板配色已适配。
- 编辑台:逐字渲染 + 播放高亮(咬字/拖音两阶段)、时间/±10ms/声部/和声/元数据编辑。
- 保存工作流改为显式保存:AI 处理完成后只写
.pending中间文件;点「💾 保存 TTML」才生成正式文件。
编辑台的修改只写草稿(.edit.json),点保存才写正式 TTML。未编辑时保存逐字节保留生成结果(长尾不被重算收回)。 - 保存文件名 = 歌手 - 歌名(如
花玲 _ 张安琪 _ 沐霏 - 我不曾忘记.ttml),同名自动加(2);证据文件同名。
二、模型与运行库(本次重点修复)
- 模型下载改走官方国内源(魔搭 ModelScope)直链:带 Range 断点续传 + 字节数校验;
HF 两端点与 GitHub Release 分卷镜像依次兜底。
实测(冻结后端):large-v3 2.9 GB / 117 s、medium 1.4 GB / 62 s、small 464 MB / 32 s,7/7 模型就绪。 - 三个 Whisper 模型均实测可加载并转写(CPU int8:large-v3 12.8 s、medium 6.8 s、small 2.3 s / 15 s 音频)。
- Demucs Worker 运行库实测安装 + 自检通过(torch 2.14.1+cu130、CUDA 可用、RTX 4060、demucs 4.1.0)。
- 模型缓存自动落在程序目录(
backend\data\models\hf_cache),不受%LOCALAPPDATA%写入限制影响;
旧版.hf_cache通过只读链接复用。 - 模型页「打开位置」:外部资源管理器调不起来时,自动改用应用内对话框显示路径 + 文件夹内容 + 复制路径。
- 「校验」在操作进行中会明确提示;已安装的 Worker 会正确启用「校验/卸载」。
三、其它修复
- 后端所有 CLI(
--model-cli/--runtime-cli/--worker-cli/--doctor)输出强制 UTF-8,
不再乱码、不再因✓字符触发UnicodeEncodeError。 - 设置页:保存不再被"目录不可写探测"硬拦(只警告);「关于」进入页面自动刷新。
- 工作台开关改竖排 + 标题可换行,不再被裁掉。
- 输出目录校验失败时,后端在任务日志里写明原因并回退默认目录。
- 修复
service_main会覆盖显式L2T_DATA_DIR/L2T_HF_CACHE的问题(便于沙箱测试/免安装部署)。
四、升级方式
- 已有 WinUI 目录:用
更新WinUI.bat(关闭程序后双击)或pwsh tools/deploy_winui.ps1,
脚本会等程序退出后复制新壳/后端并做逐页自检。 - 全新安装:见仓库
docs/WinUI3-版本说明.md(构建说明 + 已知限制)。
运行包内含 torch/CUDA,总目录约 9.7 GB,不随 Release 上传(超过 GitHub 单文件 2 GiB 限制)。
五、验证记录
- WinUI 逐页自检 8/8;主题自检
actualRoot=Dark;纯逻辑测试 137/137。 - 冻结后端真实转换:0 错误 / 33 警告 / 51 处尾音 / 23 条拖音证据。
- 全部模型下载 + 可用性、Worker 安装 + 自检均通过(见上)。
完整对比:v1.1.1 → v1.2.0(本次以源码 + 更新脚本形式发布)。
注意:本 Release 的附件是更新补丁,不是完整程序(单独运行会报 python314.dll 加载失败)。请下载 v1.2.1 便携版:https://github.com/6hdj/lrc-ttml/releases/tag/v1.2.1
Demucs Worker 运行组件 0.1.0(可选运行库,7 个组件包)
Lyric2TTML 的可选人声分离运行库(Demucs Worker),独立进程,主程序不导入其 torch/demucs。
- 共 7 个组件包(合计 1,671.8 MB,最大单片 442.3 MB),全部 tar.xz
- 每个组件都有 SHA256;下载后校验 → 解压到临时目录 → 完整性检查 + Worker 自检 → 原子切换
- 只有全部组件通过校验才启用 Worker;未安装不影响歌词识别/对齐/TTML 导出
安装位置:%LOCALAPPDATA%\Lyric2TTML\runtime\demucs-worker\
Lyric2TTML v1.1.1 —— 安装阶段不再要求下载大件;大陆可下 GPU 运行时的
Lyric2TTML v1.1.1 —— 安装阶段不再要求下载大件;中国大陆能下 GPU 运行时的
本版由两个真实用户反馈驱动:① 「软件还没打开就要下 3.5 GB」;② 「CUDA 运行库下不动 —— WinError 10061 目标计算机积极拒绝」。
下载
| 文件 | 大小 | SHA256 |
|---|---|---|
Lyric2TTML-1.1.1-setup.exe |
190.0 MB(199,202,165 字节) | 19aedb75d40f1b44cffaee13dfe226512b23e77ad6d4149328de64fb9da89271 |
- 构建 commit:
52c02af(可在软件内Lyric2TTML.exe --version核对)- 该 commit 之后只有一次仅改
docs/的提交(82634da,更新交付报告与模块说明),
没有任何源码改动 —— 所以本安装包与当前源码功能一致。 tools/check_artifact_freshness.py会因此报「产物早于 HEAD」,那是它按
「HEAD 变了就该重新打包」的保守判据;这里已逐文件确认过是纯文档变更。
- 该 commit 之后只有一次仅改
- 不需要管理员权限,双击即装
- 安装后占用约 342 MB(不含模型与 GPU 运行时)
这一版改了什么
1. 安装阶段只管「能不能打开」
以前安装程序把 21 项检查全跑一遍,然后让你「开始补全」—— 其中包含**语音模型(3 GB)**和 GPU 运行时(529 MB),软件还没打开就要下 3.5 GB。
现在按作用域分层:
| 层 | 内容 | 什么时候下 |
|---|---|---|
| launch | Python / 核心依赖 / 目录可写 / 磁盘 | 安装阶段检查,缺了就补 |
| convert | 语音模型、GPU 运行时 | 打开软件后到「模型」页下载 |
| extra | torch / demucs 等可选增强 | 用到才下 |
安装完成页现在写的是「安装完成,可以打开了」,并告诉你大件到哪下。
2. 中国大陆可以下载 GPU 运行时的
原来只配了 GitHub 单一源,大陆用户实测直接「连接被拒」,于是一个 DLL 都拿不到。现在:
- 新增腾讯云 / 阿里云 PyPI 镜像作为备用源(实测 3.91 MB/s / 0.17~8.7 MB/s);
- 首选源失败会自动换下一个 —— 并且修掉了一个真 bug:原来第一个来源的 URL 全失败就直接抛异常,第二个来源根本没机会被尝试,也就是说「加镜像源」此前是装饰;
- 修掉镜像 wheel 的 DLL 布局识别(
nvidia/cublas/bin/vsbin/)—— 以前会判「缺少文件」然后又重下 528 MB; - 修掉假就绪:文件被挪走时仍报「已就绪」(只比总字节数、不核对声明的文件)。
3. 不再下载 cuDNN
实测(真 RTX 4060 + 真音频):cuBLAS+cuDNN 1.431.50s vs 只有 cuBLAS 1.431.59s —— 没有差别,而 cuDNN 白占 1095 MiB。现在只下 cuBLAS(约 528 MB,原来约 2 GB)。
同时修正一句错话:「没有它只能 CPU,慢很多」—— 本项目没有 CPU 降级,缺运行库是直接报错。
4. 其余
- 语音识别必须用 NVIDIA 显卡;没有 N 卡也能打开软件,只在点「开始制作」时明确提示(不会崩溃、也不会让你白下 529 MB)。
- 卸载默认保留模型与运行时;想彻底清有明确选项。
- 覆盖升级不动用户数据:模型缓存、
config.json、你自己的输出文件都已实测保持字节不变。
本版验收结果(发布前实测)
| 项目 | 结果 |
|---|---|
tools/release_report.py(全量) |
28/28 通过 |
| 冻结版验收(真 exe) | 全部通过:运行时按需下载 2350.7s(真网络、走镜像回退)→ 真转换 27.6s → 校验 0 错误 |
| 干净环境(无模型 / 无 CUDA) | 10/10:安装目录 342.4 MB、can_open=True、界面自检通过 |
| 覆盖升级 v1.1.0 → v1.1.1 | 12/12:用户文件 / .hf_cache / config.json 字节不变,主程序升到 1.1.1 |
| 国内镜像 | 两个镜像长度与 SHA256 一致(553162896 字节 / 623f4302…);跨镜像分块逐字节比对通过 |
| 下载状态(未下载/取消/失败/断网重试) | test_runtime_install 18/18、test_cuda_runtime 11/11、test_hf_cache 8/8 |
| 无 N 卡 / CUDA 不可用 | test_gpu_guard 9/9(能打开、只在处理时提示、不诱导白下) |
| 产物一致性 | 产物内 commit = 52c02af = 当前源码;--version 可核对 |
首次使用(三步)
- 双击安装(不弹 UAC,默认装到
%LOCALAPPDATA%\Lyric2TTML)。 - 打开软件,按「开始」页引导装两样:语音识别模型(默认 large-v3 约 3 GB;想快点可先选
small约 477 MB)和 GPU 运行时(约 529 MB)。都有断点续传、SHA256 校验、可取消。 - 到「制作」页选音频 + 歌词,点「开始制作」。
已知问题与未验证项
- 真·干净机(没装过 Python 的 Win10/11)未验证 —— 需要一台独立虚拟机;本版的「干净环境」是隔离数据目录 + 空模型缓存的近似。
- 真·高分屏 / 混合 DPI 多显示器未验证(
QT_SCALE_FACTOR模拟的四档缩放已通过)。 - 安装向导界面为预览截图 + 单测验证;真人在 GUI 里点完一遍未做。
- 发布前自测路径(
--e2e)此前与 GUI 口径不一致(会真的下 4 GB),本版已统一;但因此不能用旧版自测结论推断本版行为。
Lyric2TTML v1.1.0 —— 安装包 190 MB(不再需要管理员权限)
Lyric2TTML v1.1.0 —— 安装包从 1.82 GB 降到 190 MB
把「普通歌词 + 音频」做成 Apple Music / AMLL 逐字 TTML 的离线桌面工具。
下载
只需下载下面这一个文件(190 MB):
| 文件 | 大小 | 说明 |
|---|---|---|
Lyric2TTML-1.1.0-安装程序.exe |
190 MB | 双击安装,不需要管理员权限 |
part1.bin + part2.bin + merge-and-extract-v3.bat(合计 1.8 GB,
还要手动合并解压)。v1.1.0 起是单个 exe,双击即可。
安装与首次使用(三步)
- 双击
Lyric2TTML-1.1.0-安装程序.exe—— 不需要管理员、不弹 UAC,
默认装到%LOCALAPPDATA%\Lyric2TTML(当前用户目录)。 - 首次打开后,按「开始」页的引导装两样东西(都会校验 SHA256、
支持断点续传,装一次以后永久可用):- 语音识别模型
Whisper large-v3,约 3 GB
(不放进安装包:GitHub 单文件上限 2 GB 且会让安装包巨大) - GPU 运行时(CUDA),约 529 MB —— 见下方说明
- 语音识别模型
- 都装好后到「制作」页选音频 + 歌词,点「开始制作」。
一首 5 分钟的歌约 30 秒 ~ 2 分钟。
两样东西都下完之后,软件完全离线可用。
为什么要单独下「GPU 运行时」(v1.1.0 的新变化)
语音识别必须用显卡(CPU 跑一首歌要几分钟,所以没有做 CPU 降级),
而显卡加速依赖 NVIDIA 的 cuBLAS 库 —— 其中 cublasLt64_12.dll
一个文件就 637 MB。
- 打进安装包 ⇒ 安装包 717 MB;
- 不打进安装包 ⇒ 安装包 190 MB,首次使用时按需下载(约 529 MB)。
所以 v1.1.0 采用后者。程序会在「开始」页把这一步列出来,
点一下就行;漏装了也不会静默失败 —— 点「开始制作」时会提前拦住并告诉你去哪装。
如果你的环境不能联网,需要自带 CUDA 运行时的完整版安装包,
请提 issue 说明。
权限说明(UAC)
- 默认不弹 UAC:安装程序默认装到当前用户目录,快捷方式与卸载项都写
HKCU,不需要管理员权限。 - 如果你手动把安装路径改成
C:\Program Files\...这类系统目录,
写入会失败 —— 此时请右键 → 以管理员身份运行安装程序。 - 程序嵌入的清单是
asInvoker(Microsoft 推荐的"不强制提权"做法)。
卸载
- 「设置 → 应用」里能找到 Lyric2TTML(当前用户的"已安装的应用")。
- 默认保留你下载的模型与运行时(约 3.5 GB),重装不用重下。
- 想彻底清理:卸载程序里有明确的"同时删除模型与数据"选项。
⚠️ 卸载不会删除你自己的输出文件(outputs/里的 TTML 与工程文件)。
这一版修了什么(相对 v1.0.3)
- 安装包 1.82 GB → 190 MB(CUDA 运行时改为按需下载)
- 不需要管理员权限,且真实右键"以管理员身份运行"也能正常工作
- 全新桌面 UI:开始 / 制作 / 任务 / 模型 / 设置 / 帮助与诊断
- 浅色 + 深色主题,高 DPI 下清晰(安装器此前在非 100% 缩放是模糊的)
- 安装向导分三步(选择位置 → 安装 → 完成),真实进度不伪造百分比
- 模型与运行组件:断点续传、SHA256 校验、可取消(取消不会留下半截安装)
- 卸载默认保留用户数据与模型
构建来源
本版安装包内的主程序记录了构建 commit,可在命令行运行
Lyric2TTML.exe --version 查看(形如「构建来源:commit xxxxxxx」)。
CUDA 运行时(cuBLAS 12,按需下载)
CUDA 运行库(cuBLAS 12),供 Lyric2TTML 1.1.0+ 按需下载。
这是什么
自 v1.1.0 起,CUDA 运行库不再打进主安装包(主包 717.7 MB → 189.9 MB)。
但语音识别需要它 —— 程序会在「模型」页的「运行组件(按需下载)」里
自动下载并校验这个 zip。
内容
�in/cublas64_12.dll、�in/cublasLt64_12.dll、�in/nvblas64_12.dll
(来自 nvidia-cublas-cu12,NVIDIA CUDA Toolkit EULA)
解压后放到 <数据目录>/runtime/cuda/,即成为 <数据目录>/runtime/cuda/bin/*.dll。
校验
SHA256 8372ad034553778cbf9d554b6b4fb397426232ef710448bcc8213c477056c9ec
Lyric2TTML v1.0.3 - 单文件安装包
Lyric2TTML v1.0.3
把普通歌词(.txt / .lrc)配合歌曲音频,转换成 Apple Music / AMLL 的逐字 TTML。
全程本地运行:不需要 API Key、不上传任何数据。
下载与安装
安装包 1.78 GB,切成两个分卷。三个文件都下载,放在同一个文件夹里:
| 文件 | 大小 |
|---|---|
Lyric2TTML-1.0.3-part1.bin |
950 MB |
Lyric2TTML-1.0.3-part2.bin |
873 MB |
merge-and-extract-v2.bat |
1.4 KB |
- 双击
merge-and-extract-v2.bat- 它会先用
copy /b合并两个分卷,再用 Windows 自带的tar解压到extracted\子文件夹 - 开头会打印「Lyric2TTML 安装包解压工具 版本 v2」 —— 没看到这行说明你用的是旧脚本(旧版在 1.8GB 条目上会报
解码时找到无效数据) - 实测 3 秒完成,1042 个文件 1858 MB
- 它会先用
- 进入
extracted文件夹,双击安装程序_onedir.exe
(会弹 UAC 请求管理员权限 —— 安装程序需要;主程序不需要) - 点「开始安装」→ 可以选安装路径 → 点「开始补全」→ 点「▶ 启动软件」
手动做也行:
copy /b Lyric2TTML-1.0.3-part1.bin + Lyric2TTML-1.0.3-part2.bin L2T.zip
tar -xf L2T.zip -C extracted
安装包已内置
Python 运行时 3.14 / 全部依赖库 / CPU 版 PyTorch / CUDA 运行库(cuBLAS + cuDNN) / CAM++ 网络定义。
唯一还需要联网下载的是语音识别模型(large-v3,约 3 GB)——
GitHub 单文件上限 2 GB,装不进安装包。下载支持断点续传。装完之后完全离线。
关于 CUDA:NVIDIA 驱动自带驱动层,不需要装 CUDA Toolkit、不需要 nvcc;
cuBLAS/cuDNN 不在驱动里,按 Python 依赖分发 —— 已内置,用户不用做任何事。
这一版修掉的问题
| 症状 | 根因 |
|---|---|
合并脚本报 'opy' 不是内部或外部命令 |
.bat 用了 LF 换行,cmd 会吞掉下一行首字符 → 改 CRLF |
解压报 解码时找到无效数据(InvalidDataException) |
PowerShell 5.1 的 Expand-Archive 处理不了 1.8 GB 的条目 → 改用 Windows 自带的 tar,2.1 秒解完 |
解压时满屏 找不到路径 |
同上,Expand-Archive -Force 先删后写,删不掉就每条报一次 → tar 不做这一步 |
| 自检卡 15~20 分钟 | 补全后又跑一遍 --doctor(要 import torch + 加载 2GB cudnn)→ 改成轻量复查,实测 37.5 秒 |
| 权限不足 / 桌面快捷方式建不出来 | 安装程序改成运行时自提权(弹 UAC) |
| 卸载程序乱码、无响应 | .bat 用 GBK 写却 chcp 65001 → 去掉 chcp,交互改 CHOICE |
安装路径变成 E:\Lyric2TTML\Lyric2TTML |
「浏览…」选中的目录被又追了一层名字 → 现在就用你选的那个 |
| 分声部开了却没反应 | 权重路径用了 __file__,打包后指向 _internal,和安装位置对不上 → 静默退回单人。现在认 exe 目录,且任何退回单人的路径都会打日志 |
TypeError: ... unexpected keyword argument 'metadata_errors' |
打包环境装到 av 19,该参数已被移除 → 钉版 av<19 |
系统要求
- NVIDIA 显卡(RTX 系列体验最好;GTX 10 系及以后可用)
- Windows 10 / 11 64 位
- 约 8 GB 空闲磁盘
- 首次安装需联网(下模型);之后完全离线
本项目强制使用 GPU,没有 CPU 降级。检测不到可用显卡时会明确报错并列出排查步骤。
验证情况
selftest.py36 组离线自检- 合并脚本:真跑一遍 → 合并产物 SHA256 与原始 zip 逐字节一致,解压 1042 个文件 1858 MB,3 秒
- 端到端安装测试:解压 12430 个文件 / 检查 21 项 / 补全 / 复查 全部通过,37.5 秒
- 真实转换:
(cuda, float16)→ CAM++ 判定 2 个声部 →v1: 20 行 / v2: 12 行、0 个错误
许可证
Lyric2TTML v1.0.2 - 单文件安装包(修复安装不完整)
只下载 Lyric2TTML-1.0.2-installer.exe 一个文件,内含完整主程序。
修掉 v1.0.1 三个 bug:
- 检查中途崩溃(SimpleNamespace 没有 action 字段)导致待装列表残缺,却报'安装完成'
- asr 不认 HUGGINGFACE_HUB_CACHE,装的地方和找的地方不是同一个目录
- 补全完不复查就直接给'启动软件'
现在:点开始安装 -> 自动解压 -> 检查 22 项 -> 点补全 -> 自动装完(模型 3GB / CUDA 2GB / 声纹权重 300MB)-> 复查通过后才给'启动软件'。
Lyric2TTML v1.0.1 —— 单文件安装包
Lyric2TTML v1.0.1
把普通歌词(.txt / .lrc)配合歌曲音频,转成 Apple Music / AMLL 的逐字 TTML。
本地运行、不需要 API Key。
只下一个文件:Lyric2TTML-1.0.1-installer.exe
里面已经包含完整的主程序,双击它就行 —— 像装微信/QQ 一样:
- 双击
Lyric2TTML-1.0.1-installer.exe - 点「开始安装」→ 自动解压到
%LOCALAPPDATA%\Lyric2TTML - 它会逐个检查运行需要的东西(共 22 项:显卡 / CUDA 运行库 / 语音识别模型 /
声纹分声部模型 / 依赖库 / 磁盘空间 / 目录权限 …),缺什么就告诉你 - 点「开始补全」→ 自动下载安装
- 全部就绪后按钮变成「▶ 启动软件」,点一下就开始用
以后不需要再开安装程序,直接双击安装目录里的 启动.bat 即可。
⚠️ 首次安装要联网下载模型(约 5 GB)
模型权重不随安装包分发(GitHub 单文件上限 2 GB,而且这些本来就该按需拉取):
| 东西 | 大小 | 用途 | 缺了会怎样 |
|---|---|---|---|
语音识别模型 large-v3 |
~3 GB | 认歌词、定逐字时间 | 完全没法转换 |
CUDA 运行库 cublas + cudnn |
~2 GB | 让识别跑在显卡上 | 只能 CPU,慢十几倍 |
| CAM++ 声纹权重 | ~300 MB | 对唱分声部 | 开了分声部也不会分(静默退化成单人) |
装完之后完全离线。 国内网络下载失败时:
- 安装程序会自动先试
hf-mirror.com镜像 - 模型的下载支持断点续传,中断了重跑即可
- CUDA 运行库是直接从 PyPI 取 wheel 解出 DLL 放到程序目录的
cuda\,
不动系统、不要管理员权限、删掉那个文件夹就等于卸载
这版修了什么
| 症状 | 根因 |
|---|---|
| 点一次「开始补全」就弹出一个新窗口,跟病毒一样 | PyInstaller 冻结后 sys.executable 就是安装程序自己,pip install 变成重新启动自己。现在彻底不用 pip:CUDA 走 HTTP 直取 wheel 解包,模型委托主程序下载 |
| 安装程序谎报 numpy / ctranslate2 / faster-whisper「未安装」 | 它在自己那个临时 Python 环境里 import(打包时特意排除了这些包)→ 必然失败。现在改为向主程序要环境报告(Lyric2TTML.exe --doctor --json) |
| 界面被挤爆、按钮看不见 | 检查项从 6 涨到 21,清单没滚动条。现在可滚动 + 窗口 860×700 |
| 模型下载失败却报"GPU 初始化失败" | 所有异常都被当成显卡问题。现在先分辨"模型拿不到"和"显卡用不了",各自给可操作的提示 |
| 得先下 zip 再下安装程序,脱裤子放屁 | 现在安装包内含主程序本体,一个文件搞定 |
系统要求
- NVIDIA 显卡(RTX 系列体验最好;GTX 10 系及以后也能用)
- Windows 10 / 11 64 位
- 约 8 GB 空闲磁盘(模型 + 运行库 + 权重)
本项目强制使用 GPU,没有 CPU 降级 —— 用 CPU 处理一首歌要几分钟,
静默降级只会让人以为"程序就是这么慢",其实只是没用上显卡。
检测不到可用显卡时会明确报错并列出排查步骤。
许可证
MIT —— 可自由使用、修改、分发,包括商用。
Lyric2TTML v1.0.0 — 首次公开发布
Lyric2TTML v1.0.0
把普通歌词(.txt / .lrc)配合歌曲音频,转换成 Apple Music / AMLL 的逐字 TTML。
全程本地运行:不需要 API Key、不上传任何数据。
⚠️ 先看这里:首次使用要联网下载模型
模型权重(large-v3 约 3 GB)不在下载包里 —— GitHub Release 单文件上限 2 GB,
而且它本来也该由使用者自己拉取。
这一步没做的话,第一次转换一定会失败。 所以请按下面的顺序来:
| 你下载的是 | 第一次怎么用 |
|---|---|
...-portable.zip(源码 + 安装脚本) |
解压 → 双击 首次安装.bat → 完事(依赖和模型都会自动装好) |
...-win64-lite.zip(免 Python) |
解压 → 双击 首次安装.bat → 完事(只下模型) |
装完之后双击 启动.bat 就能用。之后完全离线。
装完不确定好不好?双击 检查环境.bat —— 它会逐项体检并告诉你缺什么、怎么补:
[OK]  [必需] Python ≥ 3.10            3.14.6
[OK]  [必需] faster-whisper(核心)    1.2.1
[OK]  [必需] Whisper 语音识别模型      已缓存:large-v3(2948MB)
[--]  [可选] CAM++ 声纹权重            未找到 → 对唱分声部不可用,其它功能不受影响
[OK]  [信息] GPU(CTranslate2)        1 个
  ✓ 全部就绪,可以直接用
模型下载失败怎么办(国内经常遇到):双击 下载模型.bat 重试(支持断点续传)。
脚本会自动先试 hf-mirror.com 镜像、再试官方源;两个都不行时,它会打印
「怎么手动放置已有模型」「怎么换小模型」的具体做法。
想先跑通、不想下 3 GB:把
下载模型.bat里的命令改成
python download_model.py --model small(约 0.5 GB),界面上「Whisper 模型」也选small。
下载哪个?
| 附件 | 大小 | 适合谁 | 说明 |
|---|---|---|---|
Lyric2TTML-1.0.0-win64-lite.zip |
94 MB | 大多数人 | 不用装 Python,解压即用。语音识别、对齐、全部 TTML 功能、编辑台都能用 |
Lyric2TTML-1.0.0-portable.zip |
1 MB | 想用全部功能 | 源码 + 一键安装脚本,需要 Python 3.10+,联网装一次依赖 |
为什么区分"轻量版":本项目的依赖里 torch + CUDA 运行时占 4.9 GB,
却只服务于「声纹分声部」和「人声分离」两个可选功能;语音识别本身只要 0.15 GB。
所以轻量版不打 torch —— 它不会崩(那两处都是函数内 import),
只是这两个功能不可用,界面上会明确提示。
想要完整功能,用 portable 版(或自己 pip install -r requirements.txt)。
用起来
# 解压后双击 启动.bat  →  浏览器打开 http://127.0.0.1:8765
# 命令行:
Lyric2TTML.exe --audio 歌.wav --lyrics 歌.lrc -o out.ttml
Lyric2TTML.exe --doctor          # 环境体检
Lyric2TTML.exe --help
启动.bat / 首次安装.bat / 检查环境.bat / 下载模型.bat —— 四个脚本覆盖全部新手流程,
不需要敲任何命令。
主要能力
- 逐字时间轴:faster-whisper 识别 + 自研 DP 强制对齐,时间戳全部来自真实音频
- LRC 锚点:有 LRC 时按乐句切片识别、用歌词当提示词,精度明显更高
- 双轨精修:匹配率偏低的行单独重听那一小段再对齐一次
- 背景和声:
(和声)→<span ttm:role="x-bg">,不会单独成行(单独成行在播放器里看不见) - 演唱者分段:CAM++ 声纹 + k-means,四档(关闭 / 强制 1 / 2 / 3 声部)
- 句尾拖音补全:能量 + 基频连续性双判据
- 翻译 / 音译层、AMLL / Apple 双格式、六平台 ID(含酷我、酷狗)
- 人工精修编辑台:时间轴微调、声部批量改、文本增删改、和声编辑、音频试听 + 逐字高亮
这一版修掉的问题
| 症状 | 根因 |
|---|---|
| 首次转换必失败、却提示"GPU 初始化失败" | ensure_loaded 把所有异常都当成显卡问题;真实原因是模型没下载到。现在会明确告知,并给出手动放置 / 镜像 / 换小模型三条出路 |
| 纯文本歌词只出一两行、匹配率 30% 以下 | 把整份歌词当 initial_prompt,Whisper 认为"上面已经转写过了"就跳过。现在只给首句 |
| 编辑器保存后唱段分段被合并 | _split_sections 在 song_part 非空时直接短路成一个 <div> |
| 编辑器保存后词曲作者丢失 | ttml_reader 从来没读 <songwriters> |
.txt 里 [v1] 单独一行静默失效 |
只会剥出一个空行,后续行不继承 agent;LRC 里更会被整行丢弃 |
打包后 --help 崩掉 |
help 文本里的 ⚠️ 不在 GBK 里,冻结进程 stdout 走控制台代码页 |
已知限制
- 分声部约 90%:音色接近的对唱会偶发分错;人数只能由你指定
(实测三种自动判据全部失败) - 两人齐唱 / 同时张嘴时无法拆分
- 拖音长度无法用外部数据验证(QQ 的
.qrc自己也截断拖音) - 轻量版不含 torch:分声部与人声分离不可用
- CAM++ 声纹权重不随包分发,需要自行获取(见 README)
验证情况
selftest.py36 组离线自检(不需要网络与大模型)tools/verify_amll_parse.py用官方 AMLL 解析器验产物能不能显示- 分声部准确率 85.0%(真值:AMLL TTML DB 人工标注,4 首 / 160 行)
tools/test_ui_runtime.js真运行时 UI 测试(Node 最小 DOM 里跑页面真实脚本)
许可证
MIT —— 可自由使用、修改、分发,包括商用。
模型权重不随仓库分发,首次运行自动下载。第三方组件授权见
README 的「第三方依赖与许可」。