Repository navigation
Releases: DocPang/qwen38-k100ai-int8-optimization
Release list
v1.3.1 — Final Unified TP1 / TP2 / TP4 Image

v1.3.1 是当前 v30 正式版,本次已经重新制作成一个完整 Docker 镜像,TP1 / TP2 / TP4 通过 PROFILE 直接切换。
- 单一最终镜像:PROFILE=tp1|tp2|tp4
- TP2 legacy flash-attn 260602 sidecar 已内置,TP1/TP4 保持 260728
- SGLang all-rank allocator rootfix,取消 external /flush_cache guard
- TP2 mixed c4 / TP4 mixed c8 已重新验证
- TP1 GPU2、TP2、TP4 cache-resume authority 均 PASS
- Docker save -> zstd -> docker load round-trip PASS
完整镜像(夸克):https://pan.quark.cn/s/2e35321f6278?pwd=gPVV
提取码:gPVV
文件:Qwen3.8-K100AI-v1.3.1-final-image.tar.zst
SHA256:4e43edd8a0cf5ee0e501aefb051170587b1da3003392fdd2d32a1d9712e11d8f
镜像:qwen38-k100ai-int8:v1.3.1
Image ID:sha256:534f9512a3d5217c8f65f11183ed75db19e7aa3df1ecc4da1ba993e98793973d
详细更新、部署方式和验证结果见 README.md、RELEASE_NOTES_v1.3.1.md 与 v1.3.1/VALIDATION.md。
v1.2.2 — DFlash2 Sampling Fix
v1.2.2 主要修复 TP4 DFlash2 在默认采样 / temperature>0 时可能触发 scheduler 退出的问题。
- 支持 temperature / top_k / top_p / min_p 的 DFlash2 speculative sampling
- greedy 路径保持不变,mixed c4 已实机验证
- 最新完整镜像已更新到首页 README
完整镜像(夸克):https://pan.quark.cn/s/653e165c2fc7?pwd=DBia
提取码:DBia
文件:Qwen3.8-K100AI-Unified-v1.2.2.tar.zst
SHA256:91818fcc5ae0fc1cfcec6b6b9cc2950ee991f293fd16221ccd80e91fa069850d
详细验证与已知边界见 RELEASE_NOTES_v1.2.2.md。
v1.2.1 — TP4 raw-q8 ABI hotfix
v1.2.1 — TP4 raw-q8 performance hotfix
这是 v1.2.0 的 TP4-only 小版本热修复。TP1 / TP2、模型权重、SourceFind SGLang 版本和 flash-attn 版本均不变。
背景
v1.2.0 为修复 SourceFind flash-attn 260728 环境下 TP4 raw-q8 verifier 的输出异常,采用了正确但更保守的 2 × q4 verifier。该方案避免乱答,但在长上下文下会重复扫描 KV Cache,使 TP4 Decode 相比旧冠军出现约 8%–20% 的回退。
进一步审计确认,问题不是 q8 算法本身,而是 260728 新增的 raw paged_attention layout ABI 参数适配错误。TP4 当前 paged KV 几何的正确值为 layout=0。修正后可以安全恢复 single raw-q8。
本次修复
- SourceFind flash-attn 版本仍固定为:
2.8.3+das.opt1.dtk2604.torch290.2607280958.gebb4be - TP4 exact DFlash verifier 恢复 single raw-q8;
- 260728 raw
paged_attention使用经过重新验证的layout=0; - raw-q8 仅允许:
q=8 / QH6 / KVH1 / D256 / page64 / BF16; - 所有非精确 shape fail-closed;
- BF16 KV Cache 约束不变;
- TP1 / TP2 不受影响。
验证结果
isolated raw-q8(layout=0) 在 16K / 64K / 128K / 257.9K 均与 v1.2.0 的 2 × q4 reference bitwise equal。
full-model:
- 普通回答 PASS;
tool_choice=autoPASS;- canonical 16K / 64K / 128K / 257.9K 输出 SHA 与 v1.2.0 正确版本完全一致;
- 139265 cache-resume gate-v2:2× cold deterministic,cached_tokens=131072,replay=8193,
cached == cold,PASS; - 128K 三次 Decode:
87.90 / 87.33 / 87.36 tok/s; - 257.9K 两次 Decode:
70.49 / 73.56 tok/s; - 257.9K 第二轮 TTFT
132.09s,与旧冠军约132.25s基本一致。
代表性对比:
| 上下文 | v1.2.0 q8split | v1.2.1 raw-q8 | 旧冠军参考 |
|---|---|---|---|
| 16K | 110.94 | 113.55 | 113.10 |
| 64K | ~94.41 median | 98.59 median | 102.21 |
| 128K | ~78.06 median | 87.36 median | 88.68 |
| 257.9K | 57.20 | 70.49 / 73.56 | 72.49 |
64K 仍观察到单次 Decode runtime 低点,输出 SHA 和 DFlash 接受率未改变,因此不以单次峰值或低点作为正式性能结论。
安装方式
GitHub Release 同时附带小补丁包:qwen38-k100ai-v1.2.1-tp4-hotfix.tar.gz,SHA256:43a47bb3a12fa84ba46e49a425ec120222b401fbe4a8e72b06ba324db18385e5。
本次不要求重新下载完整 Docker 镜像。已有 v1.2.0 RC2 镜像的用户,在仓库中执行:
cd hotfixes/v1.2.1
bash apply.sh
会基于本地 v1.2.0 镜像生成:
qwen38-k100ai-int8:unified-20260827-v1.2.1
然后把原启动命令中的镜像名替换为上述 v1.2.1 镜像即可,其余参数完全不变。
详细说明、回滚方法和版本锁见 hotfixes/v1.2.1/README.md。
原始验证 JSON:
results/tp4_v121_rawq8_layout0_16k_20260827.jsonresults/tp4_v121_rawq8_layout0_64k128k257k_20260827.jsonresults/tp4_v121_rawq8_layout0_257900_repeat_20260827.jsonresults/tp4_v121_cache_resume_139265_20260827.json
回滚
v1.2.0 原镜像不会被修改。直接切回:
qwen38-k100ai-int8:unified-20260826-fa260728-q8split-rc2
即可恢复 v1.2.0 的 2 × q4 verifier。
v1.2.0 — Unified TP1 / TP2 / TP4 Full Image
v1.2.0 — Unified TP1 / TP2 / TP4 image
本次更新将 TP1 / TP2 / TP4 收敛为 同一个完整 Docker 镜像,并更新 SourceFind 新版 flash-attn。重点修复新版环境下可能出现的乱答、输出异常和工具调用异常,同时继续完善 TP2 / TP4 长上下文、缓存复用和 TP4 并发能力。
主要更新
- TP1 / TP2 / TP4 统一为一个镜像,通过
PROFILE=tp1|tp2|tp4切换。 - 更新
flash-attn 2.8.3+das.opt1.dtk2604.torch290.2607280958.gebb4be。 - 修复新版 flash-attn 下 TP2 / TP4 输出异常;正常回答与自动工具调用已重新验证。
- TP2 继续修复部分上下文长度下速度突然下降的问题。
- TP4 继续优化长上下文、缓存复用和 Agent 场景。
- TP4 已针对 2 / 3 / 4 并发进行适配,最高按 4 并发优化。
- 启动时可直接修改
PORT和MODEL_NAME,无需修改镜像内部文件。 - 本次只提供 完整 Docker 镜像,不再同时维护多套部署流程。
TP4 并发粗略参考
不同请求并发时的总吞吐约为:
| 并发 | 总吞吐 |
|---|---|
| 1 | ~95–97 tok/s |
| 2 | ~115–117 tok/s |
| 3 | ~141–152 tok/s |
| 4 | ~175–183 tok/s |
为不同 prompt 的 aggregate throughput 粗略参考;实际结果会受上下文长度、缓存命中和输出长度影响。
完整镜像
夸克网盘:
https://pan.quark.cn/s/156dd54a0861?pwd=2T8B
提取码:2T8B
文件:
Qwen3.8-K100AI-Unified-20260826-RC2.tar.zst
SHA256:
215cfb3f15254b8c8cb790a091f21c27827d77abdcd89c7e86ebbc58a4fe6770
模型权重(二选一下载)
如果已经有上一版的 Target / Draft 权重,可以直接继续使用,不需要重新下载。
推荐使用之前整理好的夸克完整权重包,一包同时包含 Target + Draft:
Qwen3.8-K100AI-Weights-20260823- https://pan.quark.cn/s/eb79a87216ba?pwd=Rcxc
- 提取码:
Rcxc - 文件:
qwen38-k100ai-w8a8-dflash2-weights-20260823.tar.zst - SHA256:
aa33b9d1ed1e31b1f5c3c6989a302299ecb957ff3f2768f233fdaab17f0073f5
也可以按 README 中固定 revision 从 HuggingFace 分别下载 Target + Draft。两种方式二选一,不需要 BF16 / FP16 Base 权重。
完整导入、真实权重目录、TP1 / TP2 / TP4 启动,以及端口 / 模型名称修改方式见仓库 README。
历史性能数据
上一版本的正式十档测速数据、JSON 结果和测速图片继续保留在仓库中,没有删除。详细结果见 PERFORMANCE.md、results/ 和 assets/。
已知限制
- 保持 BF16 KV Cache,不建议自行切换 FP8 KV Cache。
- 正常
tool_choice=auto/ 默认工具调用可用。 - 当前 DFlash 不支持
tool_choice=required对应的强制 grammar-constrained decoding。 - TP1 / TP2 极长上下文缓存复用仍在继续完善;TP4 会继续扩大随机缓存和并发回归测试。
v1.1.0 — TP1 / TP2 / TP4 Unified Series
v1.1.0 — TP1 / TP2 / TP4 Series
发布日期:2026-08-23
这是第一次把 TP1、TP2、TP4 作为一个完整系列正式发布。
主要变化
- TP1 更新为当前正式方案:此前单卡 128K 方案不再作为最终性能引用;新增 BM128 long-KV 32K→253952、257.9K ceil-causal qtail、262K context 与完整 257.9K quality gate。
- TP2 首次正式公开:包含 cross-rank shared-scale layers32–47、TP2 row-LDSx、BM128 long-KV、257.9K qtail、raw-q8 verifier。
- TP4 保持当前冠军配置:与 TP1/TP2 统一进入同一系列入口。
- 统一 Docker runtime:
PROFILE=tp1|tp2|tp4。 - 补齐 TP1/TP2/TP4 的完整 native 依赖闭包:系列共提供 7 个已验证用户态 gfx928 extensions,包括 TP2 row-LDSx、K5120 full5 / LDS-x 等正式运行时实际依赖,并全部附对应 HIP 源码。
- patchset 增加 TP1/TP2 完整 runtime closure、TP2 tune-cache、processor overrides。
run.sh按 Profile 只映射所需 render node:TP1=1、TP2=2、TP4=4。- 新增统一 authority 文件与三档十档总表。
最终十档
统一口径:canonical corpus / output256 / DFlash2 / cold / 每档独立 cache flush / contaminated=false。
| 上下文 | TP1 TTFT | TP1 Decode | TP2 TTFT | TP2 Decode | TP4 TTFT | TP4 Decode |
|---|---|---|---|---|---|---|
| 512 | 5.93s | 23.92 | 0.42s | 70.61 | 0.41s | 100.74 |
| 2K | 7.21s | 28.65 | 1.62s | 86.08 | 1.08s | 119.03 |
| 4K | 12.41s | 25.65 | 4.15s | 77.09 | 2.36s | 95.65 |
| 8K | 8.42s | 27.58 | 3.89s | 83.24 | 2.40s | 110.88 |
| 12K | 13.74s | 28.29 | 12.92s | 85.27 | 4.12s | 91.06 |
| 16K | 16.55s | 26.59 | 9.59s | 81.27 | 4.60s | 113.10 |
| 32K | 34.01s | 27.30 | 23.23s | 79.05 | 10.01s | 128.25 |
| 64K | 72.66s | 31.68 | 40.36s | 73.32 | 22.18s | 102.21 |
| 128K | 174.68s | 33.90 | 90.66s | 49.98 | 49.45s | 88.68 |
| 257.9K | 466.44s | 24.30 | 234.28s | 53.10 | 132.25s | 72.49 |
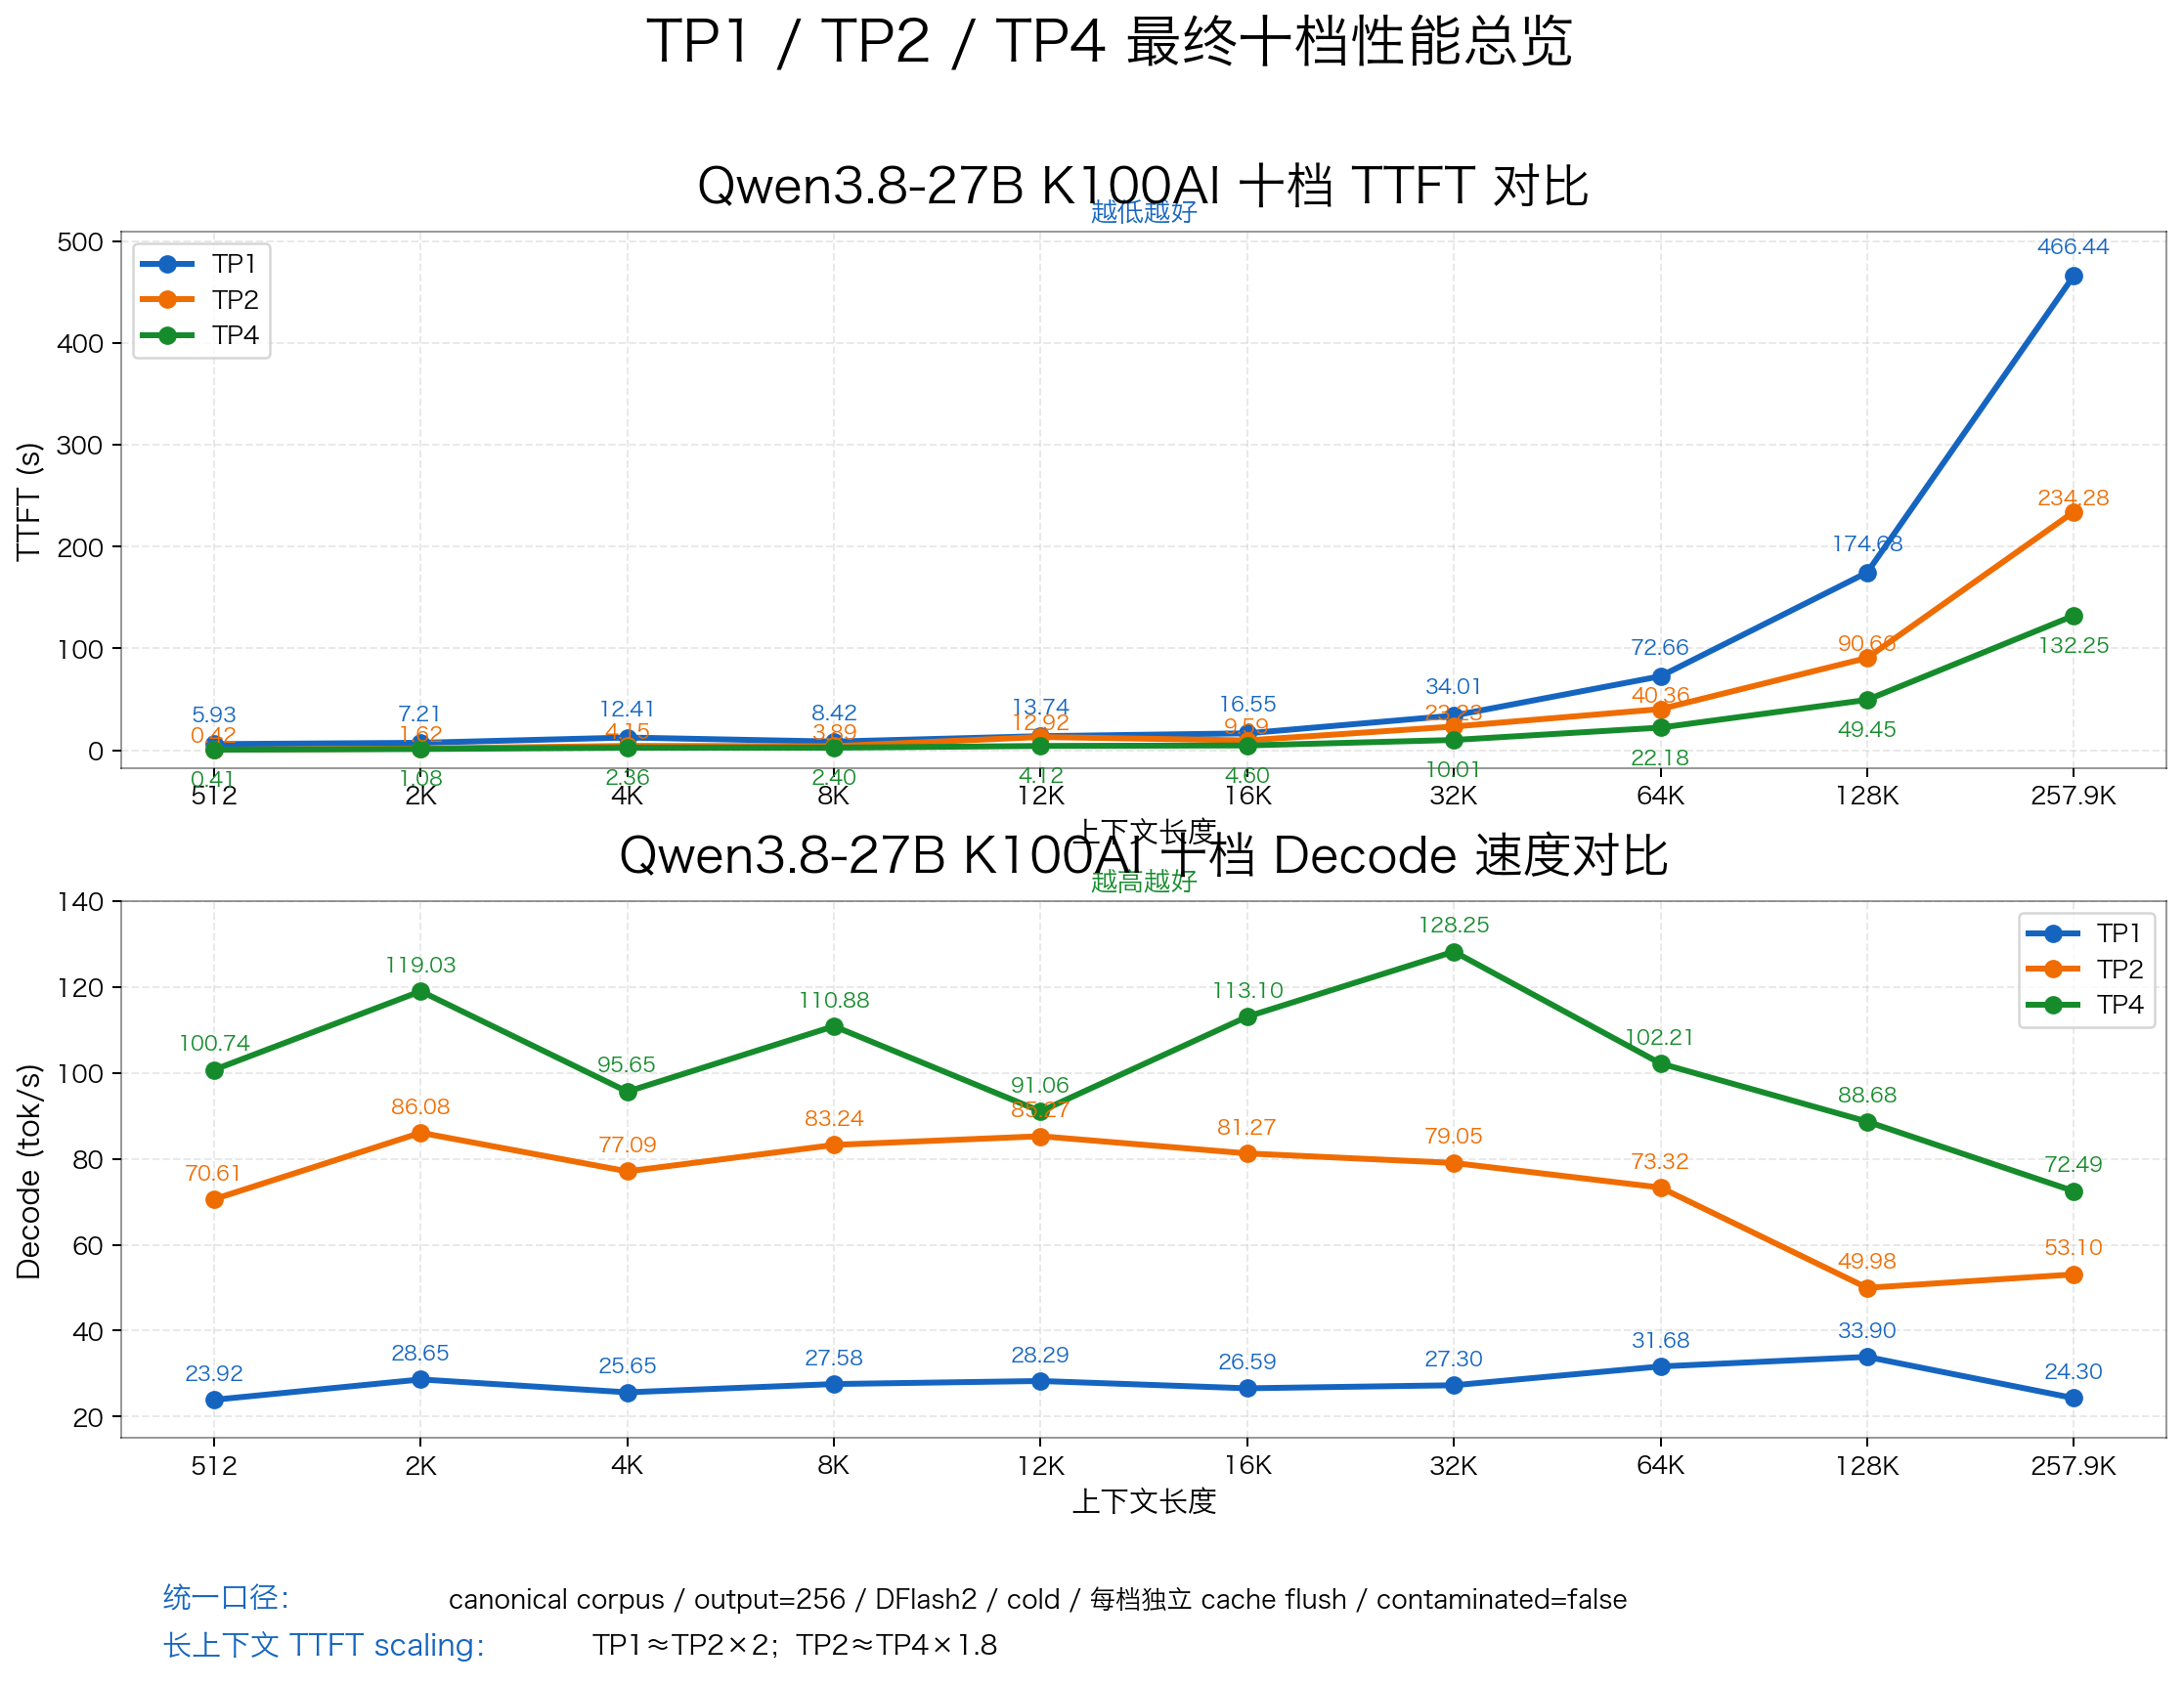
完整 Total / scaling / quality:PERFORMANCE.md。
TP1 旧版修正
此前 TP1 128K TTFT 为 231.13s。当前正式结果为 174.68s,并新增 257.9K 正式结果 466.44s / 24.30 tok/s。
旧研究期 TP1 文件已从公开仓库移除。
正式验收
- TP1:
accept=true;short semantic PASS;Arithmetic20=18/20(仅历史 case8/17);257.9K semantic PASS;257.9K P95 needle PASS。 - TP2:
accept=true;同口径质量门通过。 - TP4:formal 10/10 + 长上下文 quality/stability 已完成。
Patchset
qwen38-k100ai-patchset.tar.gz
SHA256 861903598b683ba592d68f795ac10493cbbd5e47f9b6c2757cf542d10b2930d4
发布前已在 K100AI 服务器上基于固定 SourceFind image digest 完成真实 docker build:
sha256:366525b25f452f85eb0ea5813604a64f03c648627bc824bb498b56cf5a325dde
构建过程中 TP1/TP2/TP4 runtime py_compile、TP2/TP4 tune-cache 数量、7 个 native .so 均通过 fail-closed 检查。
升级提醒
完整镜像已重新打包为支持 TP1 / TP2 / TP4 的统一版本。
完整镜像
重新打包的统一镜像支持 PROFILE=tp1|tp2|tp4,不包含模型权重。用户只需额外挂载 W8A8 target 与 DFlash2 draft,不需要 BF16/FP16 Base 权重。
- Docker tag:
qwen38-k100ai-int8:unified-20260823 - 压缩包:
qwen38-k100ai-int8-unified-20260823.docker.tar.zst - 压缩大小:5.65 GiB(6,065,184,632 bytes)
- SHA256:
6d14588722b0fea0ab66a53e2810385d1f9999a9cd78c8e1d2e6640c744f2b14 - 完整镜像下载:夸克网盘 full_images,提取码:
M8Fr;GitHub Release 保留 patchset、十档数据与整包 SHA256。
下载整包后按 SHA256 校验,再执行 zstd -dc ... | docker load。
v1.0.1 · Unified TP1/TP4 Docker image
统一完整运行时镜像
这次更新主要解决“单卡和多卡是否需要维护两套 30GB 级 Docker 镜像”的问题:现在 TP1 与 TP4 共用同一只预构建运行时镜像,通过 PROFILE=tp1 / PROFILE=tp4 切换。
新增
- 统一 Docker tag:
qwen38-k100ai-int8:unified-20260822 PROFILE=tp1:1× K100AI,Agent128K profilePROFILE=tp4:4× K100AI,longctx-v8 Champion,默认 profile- TP1 generic overlay 与 TP4 overlay 同时封装
- TP1 / TP4 DFlash2 worker 均包含 sampling 可用性保护:意外的非 greedy 请求不再触发旧 fatal gate 杀死 scheduler;生产路径仍建议
temperature=0
验收
- TP1 使用空闲 K100AI 真冷启动:PASS
- TP1
/health=200 - TP1 Chat Completion 精确返回
UNIFIED_TP1_OK - TP1
restart=0 / OOM=false - TP4 entrypoint 与 v1.0.0 longctx-v8 Champion 镜像字节一致
- TP4 DFlash2 worker 与当前 hardened 运行版 SHA256 一致
- 服务端 / Mac 双端
zstd -t与 SHA256 校验通过
完整镜像下载
夸克网盘:https://pan.quark.cn/s/1e9abeef509a?pwd=duZx
提取码:duZx
文件:qwen38-k100ai-int8-unified-20260822.docker.tar.zst
压缩后大小:约 5.67 GiB
SHA256:e3e2874939b540a935191939fe6309e583a7bf1808f6341f07aba447740d7557
导入:
zstd -dc qwen38-k100ai-int8-unified-20260822.docker.tar.zst | docker load模型权重不包含在 Docker image 内,仍需挂载
/models/target与/models/draft。这样避免在运行时镜像里重复打包几十 GB 权重。
完整使用说明见仓库 full_images/README.md。
v1.0.0 · TP4 longctx-v8 Champion
TP4 longctx-v8 Champion
Qwen3.8-27B SmoothQuant W8A8 / INT8 on Hygon K100AI, SGLang 0.5.12 + DFlash2, TP4.
Formal cold output256 authority
- 16K: 4.603s TTFT / 113.10 tok/s decode
- 32K: 10.012s / 128.25 tok/s
- 64K: 22.184s / 102.21 tok/s
- 128K: 49.450s / 88.68 tok/s
- 257.9K: 132.249s / 72.49 tok/s
- Full 10-level decode median: 101.48 tok/s
All 10 levels were independently Radix-flushed, output256, uncontaminated; final service state was restart=0 / OOM=false / health=200.
Long-context correctness / stability
- 128K thinking needle: PASS
- 257900-token exact retrieval @ 95%: PASS
- 257.9K formal repeat x3: identical SHA, 0 restart / 0 OOM
- Fixed irregular-tail causal mapping for real q=3948 (
ceil(Q/BLOCK_M)-1-pid), eliminating the old duplicate-write / missing-tail-block race.
Reproducible package
The repository default Docker profile now ships:
- q16K prefill through 128K
- exact KV=131072 q16 numerical repair
- automatic q8K chunks after 128K
- fixed q3948 split8 tail path at 257900 tokens
- native raw q8 paged DFlash2 verifier for the audited TP4 geometry
- 7 exact long-context W8A8 tune-cache JSONs
- custom all-reduce enabled
Patchset SHA256: d25f5412f34a47138c3f249991c5625fd567a6e79d1ef000015217acf7c889d9
See TP4.md and results/ for full methodology and machine-readable evidence.