Releases: LucasOl1337/sussurro
Release list
Sussurro v0.4.0 — Turbo, escolha de modelos e CPU

Sussurro v0.4.0 — Turbo, escolha de modelos e CPU
O Sussurro passa a usar Whisper Turbo por padrão em GPUs NVIDIA e também funciona sem GPU dedicada. Escolha o modelo que combina com seu computador e troque sem reiniciar.
Novidades
- Seis modelos multilíngues: Tiny, Base, Small, Medium, Turbo e Large-v3. Selecione MODELO e EXECUTAR EM, depois clique em Aplicar modelo.
- CPU ou GPU: Automático escolhe Turbo em CUDA e Base na CPU. A instalação para CPU dispensa os pacotes NVIDIA; CUDA fica em
requirements-cuda.txt. - Guia por computador: Base para CPUs básicos, Small para CPUs mais capazes, Turbo para GPUs como RTX 3060, 4070 e 4090. Large-v3 fica disponível para quem prioriza precisão. São pontos de partida, não benchmarks de cada placa.
Melhorias
- Turbo no lugar do large-v3 fixo: quantização INT8/FP16 em GPUs compatíveis reduz o custo de memória. A velocidade e a precisão variam com hardware, áudio e modelo; compare com suas gravações.
- Troca com recuperação: o download termina antes de liberar o modelo anterior. Se o carregamento falhar, o Sussurro tenta recuperá-lo pelo cache; as preferências só são salvas após sucesso.
- Estado visível: cabeçalho e comando
statusmostram modelo, dispositivo, precisão e carregamento. Trocas só são aceitas após o ditado ou arquivo em andamento terminar.
Também incluído desde v0.3.0
- Transcrição de arquivos locais por
python app.py transcribe <arquivo>, com arquivamento no histórico e sem abrir microfone ou colar texto. Instale FFmpeg no PATH para esse comando. - Gravações com falha preservam o WAV e permitem tentar a transcrição novamente no mesmo registro.
- Modo colar respeitado no app Codex/ChatGPT; terminais usam Ctrl+Shift+V.
- Interrupções no áudio do headset deixam de disparar gestos de mute pendentes; detecção por silêncio passa a ser opcional e desligada por padrão.
- Barra de gravação posicionada corretamente em monitores com escala fracionária e origem deslocada.
- Vídeo de demonstração atualizado no site.
Como atualizar
Feche o app, atualize o código e as dependências, e abra novamente. Em checkouts sem alterações locais:
git pull --ff-only
# CPU:
uv pip install -r requirements.txt
# OU GPU NVIDIA:
uv pip install -r requirements-cuda.txt
Se usa o ZIP, preserve settings.json, library.json e history/ ao trocar a pasta do aplicativo. Não há atualizador automático.
Instalações antigas adotam Automático → Turbo na GPU / Base na CPU ao atualizar. Histórico, biblioteca, microfone e atalhos são preservados. O primeiro uso de cada modelo precisa de internet para baixar os pesos; depois o áudio é processado localmente.
Validação e limites
- 42 testes de regressão de ditado, modelos, migração de preferências, recuperação de falhas e seleção de dispositivo.
- Carregamento e inferência reais em CPU e CUDA; interface exercitada em bancada X11 isolada.
- Aceleração GPU nesta versão é NVIDIA/CUDA. AMD e Intel usam CPU. Windows não foi executado nesta validação; CPUs fracos podem não acompanhar ditado em tempo real.
Sussurro v0.3.0 — gestos no headset, site e barra polida
Gestos do headset, barra que segue o monitor, site com vídeo e fontes com Xft no Linux.
Adicionado
- Aba OMARCHY (Linux): gestos do headset MCHOSE X9 acionam o ditado sem tocar no PC — roda de volume invertida rápido ou toque duplo no mute (detectado pelo silêncio digital do mic). Liga/desliga, Enter automático, ajuste dos tempos, mic reserva, instalação da regra udev e feed de eventos, tudo na aba. Módulo
sussurro_devices.py, pronto para outros perfis de fone. - Comandos
toggle-enter,start-enterestop-enterpor socket local: a sessão termina apertando Enter depois da última colagem, confirmando o envio da frase. contrib/omarchy/: regras de janela do Hyprland (sussurro.lua), regra udev do fone e passo a passo.
Corrigido
- Barra de gravação no Hyprland: aparece no monitor onde o cursor está (antes ficava sempre no monitor do meio, porque o Tk em XWayland vê uma tela única e o ponteiro dele congela fora de janelas X). Agora pergunta ao socket do Hyprland. Módulo
sussurro_hypr.py. - Barra de gravação sem o retângulo escuro atrás da cápsula: no Hyprland ela vira uma janela gerenciada (classe
SussurroBar) e a regraroundingrecorta os cantos. - Barra de gravação em X11 sem Hyprland: a janela é recortada na forma da cápsula pela extensão SHAPE (python-xlib, já instalado pelo pynput).
- Coluna da hora no histórico medida na fonte real; com Xft ela encostava no texto.
- Documentado que o Tk do Python do
uvvem sem Xft (fontes bitmap); use o Python do sistema no Linux.
Site
- Página em
docs/(GitHub Pages) com vídeo de demonstração gravado numa bancada isolada, capturas de cada aba e comparação com o Wispr Flow.
Site com vídeo de demonstração: https://lucasol1337.github.io/sussurro/
Sussurro v0.2.0 — Linux e colagem mais rápida
O Sussurro chega ao Linux com melhorias na captura, no atalho e na colagem. Esta versão corrige um timeout que acrescentava 2 segundos antes de inserir o texto e mantém a transcrição local com large-v3, CUDA, float16 e beam_size=5.
Destaques
- Colagem sem o timeout de 2 segundos: a chamada ao
wl-copydeixa de esperar pelos pipes do processo que continua servindo o clipboard. Isso também evita acionar a digitação de reserva depois de uma cópia bem-sucedida. - Atalho mais rápido: o cliente de comandos usa somente a biblioteca padrão, sem carregar a interface e as bibliotecas de IA a cada clique.
- Captura mais responsiva no Linux: blocos de 20 ms, abertura na taxa nativa do microfone e envio dos últimos blocos antes de encerrar a gravação.
- Aquecimento completo: Whisper e VAD ficam prontos antes de liberar o ditado.
- Clipboard restaurado em segundo plano: a espera de 400 ms permite a próxima inferência, respeita novas cópias do usuário e mantém a ordem entre colagens consecutivas.
Medições locais
Testes em Linux/Hyprland com RTX 4070 Ti SUPER e microfone FIFINE:
| Etapa | Antes | Depois |
|---|---|---|
| Comando do atalho, com caches aquecidos | 272 ms | 23,4 ms, mediana de 12 execuções |
Chamada isolada ao wl-copy |
2.001,7 ms, timeout | 15,7 ms, sucesso |
| Blocos de captura do microfone no Linux | 100 ms | 20 ms |
Em um campo GTK nativo de Wayland, o texto completo apareceu em 86,8 ms desde o início da colagem, com acentos e quebra de linha preservados. Esse tempo não inclui captura, transcrição nem acionamento do atalho. São medições desta máquina; o tempo total depende do áudio e do ambiente.
Mais mudanças desde a v0.1.0
- Porte para Linux, incluindo bibliotecas CUDA, dispositivos de captura, monitor de áudio do PC, clipboard e adaptações da interface.
- Comandos
toggle,start,stopestatuspor socket local para integrar o ditado ao compositor; envio de teclas em Wayland viawtype. - Widgets atualizados pela thread principal do Tk e consulta de eventos a cada 20 ms.
- Histórico com lista própria, reprodução do áudio e cópia do texto.
- Formatação com pontuação entre cláusulas, parágrafos em pausas longas e quebras antes de âncoras de listas faladas.
- Menos trabalho duplicado no modo final: uma concatenação dos blocos e uma passagem de VAD pelo faster-whisper.
- Proteção contra sobrescrita de sessões ainda em entrega ou arquivamento.
- Log local de desempenho com rotação, sem áudio nem texto ditado.
Validação e compatibilidade
- 9 testes de regressão aprovados.
- 8 gravações locais com o mesmo texto de referência após as otimizações; o teste com silêncio não produziu texto.
- O modelo, a precisão e o
beam_sizeforam mantidos. - GPU NVIDIA/CUDA continua obrigatória; não há fallback para CPU.
- Wayland requer
wl-clipboard,wtypee um atalho configurado no compositor. O launcher localsussurronão é instalado automaticamente; os comandos também funcionam compython app.py toggleepython app.py status, usando o ambiente virtual. - A colagem foi validada em GTK nativo de Wayland. A janela de teste Tk/Xwayland não confirmou inserção; outros aplicativos precisam de verificação conforme o ambiente.
- Não houve nova validação de execução no Windows nesta release.
Atualização
Encerre o aplicativo, atualize o código, instale as dependências de requirements.txt no ambiente virtual e reabra o Sussurro. Na primeira abertura, aguarde o modelo ficar pronto. Em atalhos do compositor, use caminhos absolutos para o Python do ambiente virtual e o app.py.
Sussurro v0.1.0
Primeiro release do Sussurro: ditado local por voz para Windows. Você fala, o texto aparece digitado ou colado onde o cursor estiver — e nenhum áudio sai da sua máquina.
Caminho do áudio: microfone → Silero VAD → faster-whisper large-v3 em CUDA (float16).
Novidades
Ditado com atalho global de mouse — o botão lateral liga e desliga a gravação em qualquer aplicativo, em alternar (clique liga/desliga) ou segurar (push-to-talk). O clique é suprimido, então não vira "voltar" no navegador.
Transcrição simultânea ou final — simultaneo entrega trecho por trecho conforme você pausa (corte por VAD depois de ~0,7 s de silêncio); final acumula tudo e transcreve de uma vez ao parar.
Fonte de captura: microfone, áudio do PC ou os dois — loopback WASAPI para transcrever o que está tocando nas caixas, ou a mistura das duas fontes antes do VAD.
Barra flutuante com onda ao vivo — cancelar (X), a onda do áudio que está sendo realmente capturado e confirmar (V). Sempre no topo, fora do Alt-Tab, sem roubar foco; arraste pelo meio para reposicionar. Cancelar descarta o áudio e os trechos ainda em voo, sem colar nada.
Biblioteca de correções — cadastre o que o whisper escreve errado e o termo certo. São duas passadas: exata (sem diferenciar caixa, tolerando espaço e hífen) e fonética, que pega variante não cadastrada pelo som — nine hauter, 9 rooter e ninerouter viram 9router. Os termos certos também vão como hotwords na decodificação, o que evita o modelo inventar uma palavra parecida.
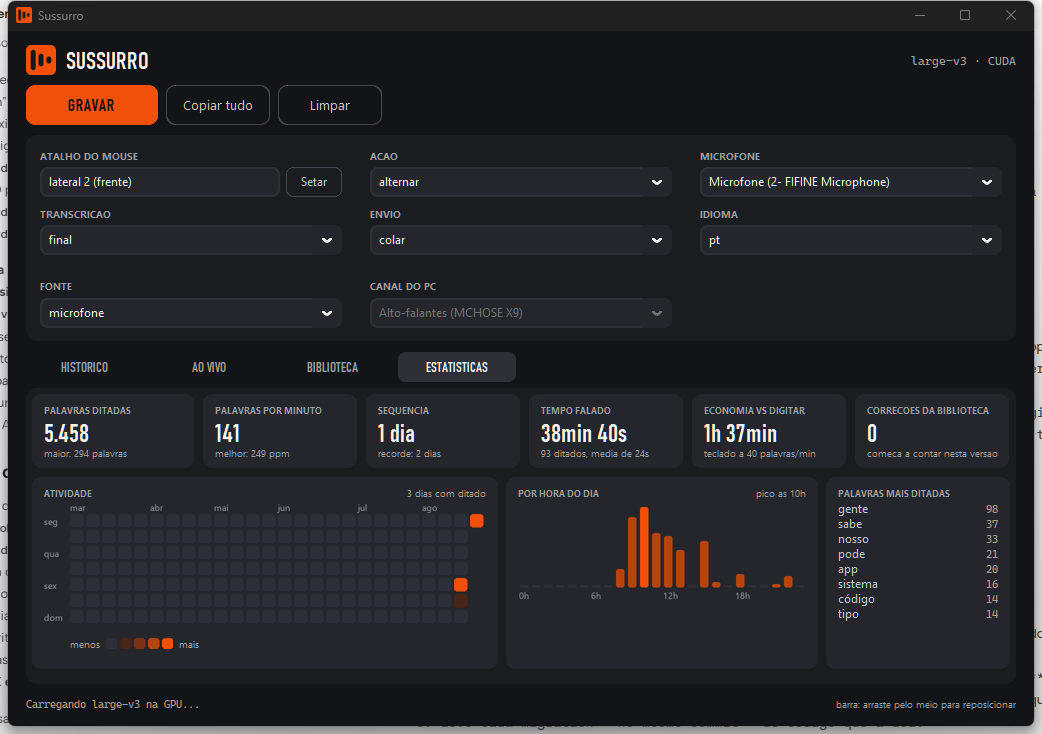
Estatísticas — total de palavras, palavras por minuto, sequência de dias, tempo falado, economia em relação a digitar, correções aplicadas pela Biblioteca, mapa de atividade, distribuição por hora do dia e as palavras que você mais fala. Tudo é derivado do próprio histórico, sem contador paralelo; a janela se alarga sozinha ao abrir a aba, então nenhum número fica escondido atrás de barra de rolagem.
Histórico e Ao vivo — as sessões passadas com play do WAV e cópia do texto, e o texto da sessão atual.
Detalhes que importam
- Nada sai do computador: captura, VAD, modelo e injeção de texto são 100% locais.
- Clipboard preservado: colar via Ctrl+V faz backup e restaura todos os formatos do que estava na área de transferência.
- Suas gravações e preferências ficam fora do git:
history/,settings.jsonelibrary.jsonsão conteúdo seu.
Requisitos
Windows 10/11, Python 3.11 e GPU NVIDIA — o modelo carrega em device="cuda", compute_type="float16".
Instalação
uv venv --python 3.11
uv pip install -r requirements.txt
.venv\Scripts\pythonw.exe app.py
Na primeira execução o large-v3 é baixado pelo faster-whisper e aquecido antes de liberar o botão GRAVAR.