Repository navigation
Home
Welcome to the EduAvatar wiki!
项目名称:师智分身 — 基于 RAG + LangGraph + Wav2Lip 的 AI 智能助教数字人
本项目旨在构建一个"课程教学数字人",将大语言模型(LLM)、检索增强生成(RAG)、语音合成(TTS)和数字人面部渲染技术融为一体,实现一个能讲课、会答疑、带表情的 AI 智能助教。
用户对着麦克风说话提问,系统自动识别语音,通过 LangGraph 智能 Agent 分析意图、检索课程知识库,生成口语化回答,最终由数字人形象配合唇形同步播报出来。
学生语音 → ASR 转文字 → LangGraph Agent 智能决策
    → 意图识别(讲解/解题/招呼)
    → 检索 FAISS 本地知识库(未命中则网络搜索兜底)
    → 口语化内容改写
    → TTS 语音合成 → Wav2Lip 数字人口型同步
    → WebRTC 实时推流至浏览器
| 场景 | 说明 |
|---|---|
| 📚 课程辅导 | 学生课后随时提问,AI 助教基于课件/教材精准回答 |
| 🏫 翻转课堂 | 数字人代替老师完成基础知识讲授,课堂时间用于深度互动 |
| 🌐 远程教育 | 偏远地区学生也能享受 7×24 小时 AI 助教服务 |
| 🔒 数据安全 | 课程资料不出本地,全部基于本地 FAISS 向量数据库 |
一条链路贯穿始终:语音 → 文字 → 意图理解 → 知识检索 → 答案生成 → 语音合成 → 数字人播报。
RAG(Retrieval-Augmented Generation,检索增强生成)就是让大模型在回答之前,先去本地知识库里"翻资料"。
打个比方:普通 AI 像是一个没带课本去考试的学生,只能凭记忆答题;RAG 就是让它考前翻了课本、看了笔记,回答更有依据。
RAG 就是给 AI 配上"课程资料库",让它回答专业课程问题时不再瞎编。
本项目中 RAG 的核心组件:
| 组件 | 技术选型 | 作用 |
|---|---|---|
| 文档加载 | PyPDF / python-docx | 读取 PDF、Word、TXT 等课程资料 |
| 文本分块 | RecursiveCharacterTextSplitter | 把长文档切成 500 字的小段,保持语义完整 |
| 向量化 | BAAI/bge-small-zh-v1.5 | 把中文文本转成数学向量,方便语义搜索 |
| 向量存储 | FAISS (Facebook AI Similarity Search) | 本地存储和快速检索向量,纯 CPU 运行 |
LangGraph 是 LangChain 团队推出的 AI 工作流编排框架。它不是简单的"你问我答",而是把 AI 的思考过程拆成多个步骤,像画流程图一样编排起来。
打个比方:普通 API 调用就像去自动售货机买饮料(投币→出货),LangGraph 就像去餐厅点餐(服务员询问口味→厨房选料→烹饪→摆盘→上菜),每一步都能根据情况动态调整。
LangGraph 就是给数字人装上"大脑",让它能判断你是想听课还是想解题,然后走不同的处理流程。
本项目 LangGraph 工作流包含 10 个节点 + 6 个条件路由:
用户输入 → 意图识别(讲解/解题/招呼)
    ├─ 讲解线:FAISS 检索 → 本地命中?→ 是→口语化改写 → 输出
    │                              └ 否→网络搜索 → 口语化改写 → 输出
    └─ 解题线:复杂度判断 → 简单→直接推理 → 输出
                           └ 复杂→FAISS检索 → 命中?→ 是→分步解题 → 输出
                                                       └ 否→网络搜索 → 分步解题 → 输出

Wav2Lip 是一个经典的唇形同步模型,输入一段音频和一张人脸图片,输出口型与音频完美匹配的人脸视频帧。
它的工作方式很像"配音演员":给定一段语音(TTS 生成),把人物形象的脸部表情重新画一遍,让嘴型跟语音完全对上。
Wav2Lip + TTS 就是给 AI 装上 "嘴巴和脸",让它能把文字用真人般的样子朗读出来。
WebRTC 是一种浏览器原生的实时音视频传输技术。它不需要安装任何插件,延迟低至 500ms 以内,比传统直播方案(RTMP 3-5秒)快得多。
WebRTC 就是给数字人配上"高速公路",让音视频以最快速度传到你眼前。
| 技术 | 作用 | 通俗说法 |
|---|---|---|
| RAG(FAISS + BGE) | 检索课程知识 | AI 的"记忆库" |
| LangGraph Agent | 意图理解、分支决策 | AI 的"大脑" |
| TTS(EdgeTTS) | 文字转语音 | AI 的"声带" |
| Wav2Lip | 唇形同步渲染 | AI 的"嘴巴" |
| WebRTC | 实时音视频传输 | AI 的"快递通道" |
| 配置项 | 最低要求 | 推荐配置 |
|---|---|---|
| CPU | 4 核 | 8 核以上 |
| 内存 | 8 GB | 16 GB+ |
| GPU | 无(CPU 可运行) | NVIDIA GPU 4GB+ 显存(RTX 3060 即可) |
| 硬盘 | 10 GB | 50 GB+(存放模型和知识库) |
| Python | 3.11 | 3.11 |
| CUDA | — | 12.4 |
| 操作系统 | Windows 10/11 或 Linux | Ubuntu 24.04 |
# 创建虚拟环境(Python 3.11)
conda create -n szfs python=3.11
conda activate szfs

# 安装 PyTorch(CUDA 12.4 版)
conda install pytorch==2.5.0 torchvision==0.20.0 torchaudio==2.5.0 pytorch-cuda=12.4 -c pytorch -c nvidia

# 如果不用 GPU,装 CPU 版:
# conda install pytorch==2.5.0 torchvision==0.20.0 torchaudio==2.5.0 cpuonly -c pytorch
⚠️ 重要:推荐 Python 3.11。后端要求>=3.11,前端numba>=0.57.0已适配 3.11,soundfile==0.12.1在该版本下稳定。
项目依赖已分为两个文件,分别安装:
# 安装后端 Agent 依赖(LangGraph / LangChain / FAISS 等)
pip install -r backend/requirements_backend.txt

# 安装数字人前端依赖(PyTorch / Wav2Lip / WebRTC 等)
pip install -r fronted/requirements_fronted.txt依赖概览:
- 后端:
langgraph、langchain、sentence-transformers、faiss-cpu、pypdf、docx2txt- 前端:
opencv-python>=4.8.0、numba>=0.57.0、soundfile==0.12.1、aiortc、edge_tts、imageio-ffmpeg(内置 FFmpeg)、transformers、diffusers
下载地址:夸克网盘,下载后按以下说明放置文件。
需要 3 个文件/文件夹:
-
s3fd.pth— 人脸检测模型,放到wav2lip/face_detection/detection/sfd/下 -
wav2lip256.pth— 重命名为wav2lip.pth,放到models/下 -
wav2lip256_avatar1.tar.gz— 解压后整个文件夹放到data/avatars/下
以上路径均相对于
前端/LiveTalking-main/目录。
# 示例:从下载目录复制文件到项目

# 1. 复制 s3fd.pth(人脸检测模型)
cp s3fd.pth 前端/LiveTalking-main/wav2lip/face_detection/detection/sfd/s3fd.pth

# 2. 复制并重命名 wav2lip256.pth → wav2lip.pth(唇形同步权重)
cp wav2lip256.pth fronted/LiveTalking-main/models/wav2lip.pth

# 3. 解压并放置数字人形象
tar -xzf wav2lip256_avatar1.tar.gz
cp -r wav2lip256_avatar1 前端/LiveTalking-main/data/avatars/
✅ 验证:完成后应能看到
models/wav2lip.pth文件,以及data/avatars/wav2lip256_avatar1/目录。
 首次运行知识库构建脚本时会自动从 HuggingFace 下载。国内可设置镜像加速:
# Windows CMD
set HF_ENDPOINT=https://hf-mirror.com

# 或者 PowerShell
$env:HF_ENDPOINT="https://hf-mirror.com"

在 backend/agent/ 目录下创建 .env 文件:
# ===== LLM API 配置(以 DeepSeek 为例,兼容 OpenAI 接口)=====
OPENAI_API_KEY=sk-your_deepseek_api_key
OPENAI_API_BASE=https://api.deepseek.com/v1
MODEL=openai/deepseek-chat

# 如果用阿里云百炼(通义千问),改为:
# OPENAI_API_KEY=sk-your_dashscope_key
# OPENAI_API_BASE=https://dashscope.aliyuncs.com/compatible-mode/v1
# MODEL=openai/qwen-plus

# ===== 网络搜索 API(知识库未命中时兜底)=====
TAVILY_API_KEY=tvly-your_tavily_api_key

# ===== FAISS 知识库路径 =====
FAISS_INDEX_DIR=../../faiss_store
FAISS_EMBEDDING_MODEL=BAAI/bge-small-zh-v1.5知识库是数字人的"记忆",决定了它能回答哪些课程内容。
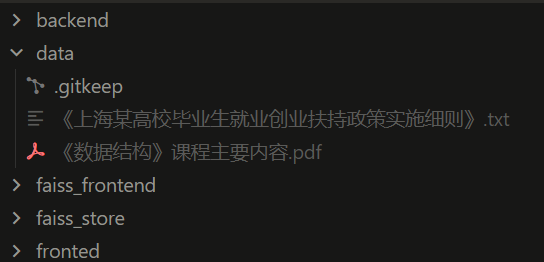
将课程 PDF、Word 文档、TXT 讲义放入 data/ 目录:
EduAvatar/
└── data/
    ├── 《数据结构》课程主要内容.pdf
    ├── 知识点讲义.docx
    └── 补充资料.txt
cd rag
python rag_faiss_build.py --source_dir ../data --index_dir ../faiss_store
运行流程:
原始文档(txt/pdf/docx/doc)
    ↓ 文档加载器(PyPDF / Docx2txt / TextLoader)
完整文本
    ↓ RecursiveCharacterTextSplitter(chunk_size=500, overlap=100)
文本片段 × N
    ↓ HuggingFace Embeddings(BAAI/bge-small-zh-v1.5)
向量表示(768维浮点数)
    ↓ FAISS 存储
faiss_store/index.faiss  +  index.pkl
运行成功后会看到类似输出:

cd rag

# 查询测试
python rag_faiss_query.py --query "什么是二叉树?"

# 返回 Top-4 相关文档片段及相似度评分
可选参数:
--index_dir指定索引路径,-k控制返回结果数量(默认 4)。
📦 完整代码见 GitHub 仓库:https://github.com/gdemoni/EduAvatar
Agent 是整个系统的"大脑",文件位于 后端/agent/src/react_agent/。本章节将带你逐步创建状态定义、Prompt 模板和工作流图三个核心文件。
首先,在 后端/agent/src/react_agent/ 目录下创建 state.py 文件,文件内容如下所示:
"""定义 Agent 在整个处理流程中需要传递的状态数据"""

from dataclasses import dataclass, field
from typing import Sequence
from langchain_core.messages import AnyMessage
from langgraph.graph import add_messages
from typing_extensions import Annotated


@dataclass
class InputState:
    """外部输入:用户对话消息"""
    messages: Annotated[Sequence[AnyMessage], add_messages] = field(
        default_factory=list
    )


@dataclass
class State(InputState):
    """Agent 内部状态:在各节点间流转的数据"""

    intent: str = field(default="")
    # 用户意图:explain(讲解知识点)、solve(解题)、welcome(打招呼)、ask_intent(需要澄清)

    solve_mode: str = field(default="")
    # 解题模式:direct(简单题直接推理)、retrieval(复杂题先检索知识库)

    retrieved_context: str = field(default="")
    # 从 FAISS 或网络检索到的参考知识

    data_source: str = field(default="")
    # 数据来源:direct(直接推理)、local(本地知识库)、web(网络搜索)、none(未找到)

    solution_steps: str = field(default="")
    # 解题步骤(解题分支专用)

    rewritten_content: str = field(default="")
    # 改写后的口语化教学内容(讲解分支专用)
该代码的作用是定义 Agent 在处理流程中需要传递的状态数据,核心包含两个类:
-
InputState:外部输入状态,只包含
messages字段,用于接收用户对话消息。add_messages注解确保新消息自动追加到历史中。 -
State:继承自 InputState,添加了 6 个内部流转字段——
intent(意图)、solve_mode(解题模式)、retrieved_context(检索知识)、data_source(来源标注)、solution_steps(解题步骤)、rewritten_content(改写内容)。
💡 设计要点:State 里每个字段都有
default="",因为 LangGraph 节点函数返回的 dict 只包含"变化了"的字段,未返回的字段自动保留原值。
最后,在 后端/agent/src/react_agent/ 目录下创建 graph.py 文件,这是整个 Agent 的核心——定义所有处理节点和路由逻辑。
① 意图识别节点
from react_agent.context import Context
from react_agent.prompts import INTENT_PROMPT, SIMPLE_SOLVE_CHECK_PROMPT, \
    QUERY_REWRITE_PROMPT, REWRITE_PROMPT, SOLVE_PROMPT, STEPS_PROMPT, \
    DIRECT_SOLVE_PROMPT, RELEVANCE_CHECK_PROMPT
from react_agent.state import InputState, State
from react_agent.tools import faiss_search_local, search
from react_agent.utils import load_chat_model


async def intent_recognition_node(state: State, config=None) -> dict:
    """分析用户意图:'explain'(讲解)、'solve'(解题)、
       'welcome'(打招呼)或 'ask_intent'(需要澄清)"""
    if not state.messages:
        return {"intent": "welcome"}

    last_message = state.messages[-1]
    if not last_message.content or not str(last_message.content).strip():
        return {"intent": "welcome"}

    model = load_chat_model("openai/qwen-plus")
    response = await model.ainvoke([
        SystemMessage(content=INTENT_PROMPT)
    ] + state.messages)

    intent = response.content.strip().lower()
    if "ask_intent" in intent:
        return {"intent": "ask_intent"}
    if "welcome" in intent:
        return {"intent": "welcome"}
    if "explain" in intent or "讲解" in intent:
        return {"intent": "explain"}
    return {"intent": "solve"}
该节点的作用是接收用户输入后调用 LLM 判断意图,返回四种意图之一,后续路由函数根据意图分流到不同处理管线。
② 欢迎与澄清节点
async def welcome_node(state: State) -> dict:
    """发送欢迎语,引导用户提问"""
    return {"messages": [
        AIMessage(content="你好!我是你的智能助教。我可以为你讲解知识点,"
                  "例如解释什么是光合作用;也可以为你解答具体的题目,"
                  "请直接把题目发给我。请告诉我你想学什么?")
    ]}


async def ask_clarification_node(state: State) -> dict:
    """意图不清时追问用户"""
    return {"messages": [
        AIMessage(content="请问您是希望我为您讲解某个知识点,还是解答具体的题目?")
    ]}
③ 题目复杂度判断节点
async def problem_solving_node(state: State, config=None) -> dict:
    """判断题目难度,决定是直接推理还是检索知识库"""
    model = load_chat_model("openai/qwen-plus")
    human_messages = [m.content for m in state.messages
                      if isinstance(m, HumanMessage)]
    query = " ".join(str(c) for c in human_messages)

    check_response = await model.ainvoke([
        SystemMessage(content=
            SIMPLE_SOLVE_CHECK_PROMPT.format(query=query))
    ])
    decision = str(check_response.content).strip().upper()

    if "SIMPLE" in decision:
        return {"solve_mode": "direct", "data_source": "direct"}
    return {"solve_mode": "retrieval"}
④ 知识检索节点(本地 + 网络兜底)
async def retrieve_local_node(state: State, config=None) -> dict:
    """本地 FAISS 检索:先查询重写,再向量检索"""
    model = load_chat_model("openai/qwen-plus")
    human_messages = [m.content for m in state.messages
                      if isinstance(m, HumanMessage)]
    history = "\n".join(str(c) for c in human_messages)

    # 步骤 1:查询重写(口语 → 精准搜索词)
    rewrite_response = await model.ainvoke([
        SystemMessage(content=
            QUERY_REWRITE_PROMPT.format(history=history))
    ])
    query = rewrite_response.content.strip() or history

    # 步骤 2:FAISS 向量检索
    results = await faiss_search_local(query)
    if results and results.get("results"):
        context = "\n\n".join(
            r.get("content", "") for r in results["results"]
        )
        return {"retrieved_context": context, "data_source": "local"}
    return {"retrieved_context": "", "data_source": "none"}


async def retrieve_web_node(state: State, config=None) -> dict:
    """网络搜索兜底:Tavily Search API"""
    model = load_chat_model("openai/qwen-plus")
    human_messages = [m.content for m in state.messages
                      if isinstance(m, HumanMessage)]
    history = "\n".join(str(c) for c in human_messages)

    rewrite_response = await model.ainvoke([
        SystemMessage(content=
            QUERY_REWRITE_PROMPT.format(history=history))
    ])
    query = rewrite_response.content.strip()

    web_results = await search(query)
    if web_results and web_results.get("results"):
        context = "\n\n".join(
            r.get("content", "") for r in web_results["results"]
        )
        return {"retrieved_context": context, "data_source": "web"}
    return {"retrieved_context": "", "data_source": "none"}
该代码包含两个检索节点:
-
retrieve_local_node:本地 FAISS 检索,两步骤——先用 LLM 将口语问题重写为精准搜索词,再调用
faiss_search_local向量检索。 - retrieve_web_node:网络搜索兜底,当本地检索无结果时自动降级到 Tavily 网络搜索。
⑤ 教学内容生成节点(讲解 + 解题)
async def layered_rewriting_node(state: State, config=None) -> dict:
    """将检索知识分层改写为口语化教学内容"""
    model = load_chat_model("openai/qwen-plus")
    source_desc = "本地知识库" if state.data_source == "local" else "网络搜索"

    prompt = REWRITE_PROMPT.format(
        context=state.retrieved_context, source=source_desc
    )
    response = await model.ainvoke([SystemMessage(content=prompt)])
    return {"rewritten_content": response.content}


async def generate_solution_steps_node(state: State, config=None) -> dict:
    """生成分步解题过程"""
    model = load_chat_model("openai/qwen-plus")
    human_messages = [m.content for m in state.messages
                      if isinstance(m, HumanMessage)]
    query = " ".join(str(c) for c in human_messages)

    # 步骤 1:生成详细解答
    solve_prompt = SOLVE_PROMPT.format(
        query=query, context=state.retrieved_context
    )
    solution_response = await model.ainvoke([SystemMessage(content=solve_prompt)])

    # 步骤 2:格式化为分步讲解
    source_desc = "本地知识库" if state.data_source == "local" else "网络搜索"
    steps_prompt = STEPS_PROMPT.format(
        solution=solution_response.content, source=source_desc
    )
    steps_response = await model.ainvoke([SystemMessage(content=steps_prompt)])
    return {"solution_steps": steps_response.content}


async def _direct_solve_node(state: State, config=None) -> dict:
    """简单题直接推理,不检索知识库"""
    model = load_chat_model("openai/qwen-plus")
    human_messages = [m.content for m in state.messages
                      if isinstance(m, HumanMessage)]
    query = " ".join(str(c) for c in human_messages)
    response = await model.ainvoke([
        SystemMessage(content=DIRECT_SOLVE_PROMPT.format(query=query))
    ])
    return {"solution_steps": response.content, "data_source": "direct"}


async def output_teaching_content_node(state: State) -> dict:
    """拼装最终回答并标注数据来源"""
    if state.intent == "explain":
        content = state.rewritten_content
    else:
        content = state.solution_steps

    source_sentence = "以上内容主要参考了本地知识库中的资料。"
    if state.data_source == "direct":
        source_sentence = "这个问题比较基础,我是直接推理计算后给出的答案。"
    elif state.data_source == "web":
        source_sentence = "以上内容主要参考了网络搜索的结果。"
    elif state.data_source == "none":
        source_sentence = "抱歉,我没有找到相关的资料。"

    if source_sentence not in content:
        content = f"{content.rstrip()} {source_sentence}".strip()
    return {"messages": [AIMessage(content=content)]}
该代码包含 4 个节点:
- layered_rewriting_node:讲解分支专用,使用 REWRITE_PROMPT 将检索知识改写成逐行输出的口语化教学内容。
- generate_solution_steps_node:解题分支专用,两步走——先用 SOLVE_PROMPT 生成详细解答,再用 STEPS_PROMPT 格式化为分步讲解。
- _direct_solve_node:简单题直接推理节点,不经过知识库检索,直接用模型推理给出答案。
- output_teaching_content_node:最终输出节点,拼装回答内容并自动标注数据来源。
⑥ 条件路由函数
def _route_intent(state: State):
    """根据意图分流到不同处理管线"""
    if state.intent == "welcome":     return "welcome_node"
    if state.intent == "ask_intent":  return "ask_clarification_node"
    if state.intent == "explain":     return "retrieve_local_explain"
    return "problem_solving_node"  # solve

def _route_solve_mode(state: State):
    """解题模式分流:简单题直接解答,复杂题先检索"""
    if state.solve_mode == "direct":
        return "direct_solve_node"
    return "retrieve_local_solve"

def _check_retrieval_explain(state: State):
    """讲解分支:本地有结果 → 改写,无结果 → 网络搜索兜底"""
    if state.data_source == "local" and state.retrieved_context.strip():
        return "layered_rewriting_node"
    return "retrieve_web_node"

def _check_retrieval_solve(state: State):
    """解题分支:本地有结果 → 生成步骤,无结果 → 网络搜索兜底"""
    if state.data_source == "local" and state.retrieved_context.strip():
        return "generate_solution_steps_node"
    return "retrieve_web_node"

def _route_after_web(state: State):
    """网络搜索后根据原始意图分流回讲解/解题管线"""
    if state.intent == "explain":
        return "layered_rewriting_node"
    return "generate_solution_steps_node"
该代码定义了 5 个条件路由函数,是工作流的"交通枢纽":
- _route_intent:意图分流,将 welcome / ask_intent 直接结束,explain 走检索讲解管线,solve 走解题管线。
-
_route_solve_mode:解题模式分流,简单题走
_direct_solve_node,复杂题走retrieve_local_solve。 - _check_retrieval_explain:讲解检索后判断,本地有结果则改写,无结果则网络搜索兜底。
- _check_retrieval_solve:解题检索后判断,逻辑同上但走解题后续节点。
- _route_after_web:网络搜索完成后根据原始意图分别汇入讲解或解题管线。
⑦ 组装工作流图
from langgraph.graph import END, StateGraph

builder = StateGraph(State, input_schema=InputState)

# ---- 添加 10 个节点 ----
builder.add_node("intent_recognition_node", intent_recognition_node)
builder.add_node("welcome_node", welcome_node)
builder.add_node("ask_clarification_node", ask_clarification_node)
builder.add_node("problem_solving_node", problem_solving_node)
builder.add_node("retrieve_local_explain", retrieve_local_node)
builder.add_node("retrieve_local_solve", retrieve_local_node)
builder.add_node("retrieve_web_node", retrieve_web_node)
builder.add_node("layered_rewriting_node", layered_rewriting_node)
builder.add_node("generate_solution_steps_node", generate_solution_steps_node)
builder.add_node("direct_solve_node", _direct_solve_node)
builder.add_node("output_teaching_content_node", output_teaching_content_node)

# ---- 连接节点(边和条件边)----
builder.add_edge("__start__", "intent_recognition_node")
builder.add_conditional_edges("intent_recognition_node", _route_intent)
builder.add_conditional_edges("problem_solving_node", _route_solve_mode)
builder.add_conditional_edges("retrieve_local_explain", _check_retrieval_explain)
builder.add_conditional_edges("retrieve_local_solve", _check_retrieval_solve)
builder.add_conditional_edges("retrieve_web_node", _route_after_web)

# 所有处理管线汇聚到输出节点
builder.add_edge("layered_rewriting_node", "output_teaching_content_node")
builder.add_edge("generate_solution_steps_node", "output_teaching_content_node")
builder.add_edge("direct_solve_node", "output_teaching_content_node")
builder.add_edge("output_teaching_content_node", END)

# 终端节点
builder.add_edge("welcome_node", END)
builder.add_edge("ask_clarification_node", END)

# 编译生成可运行的 Graph
graph = builder.compile(name="RAG Agent")
该代码是工作流的"骨架",将前面定义的所有节点和路由函数组装在一起:
-
注册节点:
add_node将 10 个节点函数注册到图中(注意retrieve_local_node被注册了两次,分别用于讲解和解题管线,保持图形清晰)。 -
添加边:
add_edge是固定流转路径,add_conditional_edges根据路由函数的返回值动态选择下一节点。 -
汇聚输出:讲解(改写)、解题(分步)、直解三条管线最终都汇聚到
output_teaching_content_node,统一标注来源后结束。
💡 关键设计:10 个节点各司其职,6 个条件路由实现智能分流。讲解和解题两条独立管线在输出节点汇聚,代码解耦清晰。
"""FAISS 本地检索 + Tavily 网络搜索"""

async def faiss_search_local(query: str, k: int = 5) -> dict:
    """
    本地 FAISS 向量检索
    步骤:加载索引 → 向量化查询 → 相似度搜索 → 阈值过滤
    """
    # 1. 加载 FAISS 索引(全局缓存,避免重复加载)
    index_dir = Path("../../faiss_store")
    embeddings = HuggingFaceEmbeddings(model_name="BAAI/bge-small-zh-v1.5")
    vectorstore = FAISS.load_local(str(index_dir), embeddings,
                                    allow_dangerous_deserialization=True)

    # 2. 检索 Top-K,带 L2 距离评分
    docs_and_scores = vectorstore.similarity_search_with_score(query, k=k)

    # 3. 相似度阈值过滤(L2 距离 ≤ 5.0 视为相关)
    results = []
    for doc, score in docs_and_scores:
        if score <= 5.0:
            results.append({
                "content": doc.page_content,
                "score": float(score)
            })

    return {"results": results}


async def search(query: str) -> dict:
    """网络搜索兜底(Tavily Search API)"""
    wrapped = TavilySearch(max_results=10)
return await wrapped.ainvoke({"query": query})整个 Agent 工作流由以下节点组成,完整覆盖"讲解知识点"和"解答题目"两大场景:
 各节点职责:
| 节点 | 职责 |
|---|---|
intent_recognition_node |
判断用户意图:讲解 / 解题 / 欢迎 / 意图不明 |
welcome_node |
发送欢迎语,引导用户提问 |
ask_clarification_node |
意图不清时追问用户明确需求 |
problem_solving_node |
判断题目难度,决定直解还是检索知识库 |
direct_solve_node |
简单题直接用模型推理,不走知识库 |
retrieve_local_explain / retrieve_local_solve
|
调用 FAISS 检索本地课程资料 |
retrieve_web_node |
本地检索无结果时用 Tavily 网络搜索兜底 |
layered_rewriting_node |
将检索到的知识分层改写为教学内容 |
generate_solution_steps_node |
生成分步解题过程 |
output_teaching_content_node |
拼装最终回答并标注数据来源 |
💡 核心设计思想:两条主链路——讲解链路(本地检索 → 分层改写 → 输出)和解题链路(判断难度 → 检索/直解 → 分步解答 → 输出),本地无结果时统一走网络搜索兜底。
启动 LangGraph Dev Server 打开可视化工作流界面:
cd 后端/agent

# 以可编辑模式安装 react_agent 包(首次运行必须)
pip install -e .

# 启动 LangGraph 开发服务器
langgraph dev
⚠️ 常见报错:启动时如果出现protobuf版本冲突按以下步骤修复:
pip uninstall fireworks-ai -y
pip install -U "protobuf>=6.32.1,<7"
然后重新执行
langgraph dev即可。


启动成功后终端会输出:
🚀 API: http://127.0.0.1:2024
🎨 Studio UI: https://smith.langchain.com/studio/?baseUrl=http://127.0.0.1:2024
📊 API Docs: http://127.0.0.1:2024/docs
在浏览器中打开 Studio UI 链接,进入 LangGraph Studio 界面后:
-
左侧面板选择
agent工作流 -
在输入框输入
"请解释什么是二叉树",点击运行 -
观察右侧可视化流程图中节点按以下顺序逐个高亮:
__start__ → intent_recognition_node → retrieve_local_explain
         → layered_rewriting_node → output_teaching_content_node → END
- 点击任意高亮节点,可以在右侧面板查看该节点的输入和输出数据,方便调试每个环节的处理逻辑
💡 这就是 LangGraph 的核心调试方式——在网页端直观看到 Agent 每一步怎么走、传了什么数据,无需在终端打 log。
后端 Agent 通过 LangGraph Server 自动暴露 API,无需手写 FastAPI。前端通过 llm.py 桥接调用。
"""前端调用后端 Agent 的桥接模块"""

import asyncio
from langchain_core.messages import HumanMessage
from react_agent.graph import graph

def llm_response(message, nerfreal):
    """
    接收用户消息 → 调用 LangGraph Agent → 逐句送入 TTS 播报队列

    Args:
        message: 用户输入的文本
        nerfreal: 数字人渲染实例(负责 TTS 播报)
    """

    async def run_agent():
        # 第一步:调用 LangGraph Agent
        result = await graph.ainvoke(
            {"messages": [HumanMessage(content=message)]},
            config={"configurable": {"model": "openai/deepseek-chat"}}
        )

        # 第二步:获取 Agent 回复内容
        if "messages" in result and result["messages"]:
            content = result["messages"][-1].content

            # 第三步:逐句切分,送入 TTS 播报队列
            # 为什么逐句?因为让用户 2 秒内听到第一句话,而不是等 20 秒听全部
            buffer = ""
            for char in content:
                buffer += char
                # 遇到句子结束标点,即发送一整句给 TTS
                if char in ".!?;。!?;\n":
                    if len(buffer) > 10:          # 过滤太短的片段
                        nerfreal.put_msg_txt(buffer)
                        buffer = ""
            # 发送尾部剩余内容
            if buffer:
                nerfreal.put_msg_txt(buffer)

    asyncio.run(run_agent())
💡 流式播报原理:LLM 生成完整回答后,按标点符号逐句切分,每切出一句就立即送入 TTS 合成并播报。用户感知的首句延迟 < 2 秒,而非等全部文字生成完才开始播报(传统方式首字延迟可能 10-30 秒)。
数字人前端基于 LiveTalking 项目,提供 WebRTC 实时交互界面。
确保已完成 3.3.1 模型文件准备 后再启动。
cd 前端/LiveTalking-main

# 使用 Wav2Lip 模型 + Edge TTS,监听 8010 端口
python app.py --transport webrtc --model wav2lip --avatar_id wav2lip256_avatar1启动参数说明:
| 参数 | 取值 | 说明 |
|---|---|---|
--transport |
webrtc |
传输协议,固定使用 WebRTC 实时推流 |
--model |
wav2lip |
数字人模型类型 |
--avatar_id |
wav2lip256_avatar1 |
数字人形象 ID,对应 data/avatars/ 下的文件夹名 |
--tts |
edgetts(默认) |
TTS 引擎,可选 edgetts / azure / aliyun / xtts 等 |
--listenport |
8010(默认) |
HTTP 监听端口 |
--batch_size |
自动 | GPU 批处理大小,显存不足时可设为 4 或 8
|
启动后输出:
start http server; http://<serverip>:8010/webrtcapi.html
如果使用webrtc,推荐访问webrtc集成前端: http://<serverip>:8010/dashboard.html
在浏览器中打开 http://serverip:8010/webrtcapi.html,在文本框输入任意文字并提交,数字人即会播报这段文本。
如果你有自己的教师出镜视频,可以生成专属数字人形象:
cd fronted/LiveTalking-main

# 生成自定义数字人形象
python -m avatars.wav2lip.genavatar --video_path xxx.mp4 --img_size 256 --avatar_id my_teacher_avatar

# 参数说明:
# --video_path   输入视频路径(要求:无声、闭嘴、正面人脸的 MP4 视频)
# --img_size     固定为 256(Wav2Lip 模型的要求)
# --avatar_id    自定义形象名称,生成在 data/avatars/ 下
# --face_det_batch_size  若卡住可调小,例如 --face_det_batch_size 4
⚠️ 重要:输入视频必须是闭口无声视频(人物正面、嘴巴闭合、无语音),否则嘴型同步效果会受影响。
生成后使用新形象启动:
python app.py --transport webrtc --model wav2lip --avatar_id my_teacher_avatarLiveTalking 项目支持多种数字人渲染引擎,除了默认的 Wav2Lip,还可以使用效果更好的模型。
| 模型 | 启动参数 | 特点 | 适用场景 |
|---|---|---|---|
| Wav2Lip | --model wav2lip |
经典唇形同步,速度最快,资源占用最低 | 快速入门、低配设备 |
| MuseTalk | --model musetalk |
嘴型同步效果更好,支持全身动态 | 高画质教学场景 |
| Ultralight | --model ultralight |
轻量级实时渲染,延迟极低 | 实时交互直播 |
切换模型只需修改 --model 参数,例如:
# 切换到 MuseTalk 模型
python app.py --transport webrtc --model musetalk --avatar_id wav2lip256_avatar1 --tts edgetts --listenport 8010

# 切换到 Ultralight 模型
python app.py --transport webrtc --model ultralight --avatar_id wav2lip256_avatar1 --tts edgetts --listenport 8010
💡 更多模型配置和最新功能请参考 LiveTalking 官方仓库:https://github.com/lipku/LiveTalking
# ===== 终端 1:启动后端 LangGraph Agent =====
cd backend/agent
pip install -e .    # 首次运行需要
langgraph dev
# 启动后访问 Studio UI 链接可查看工作流图
# (保持运行,不要关闭)

# ===== 终端 2:启动数字人前端 =====
cd fronted/LiveTalking-main
python app.py --model wav2lip --avatar_id wav2lip256_avatar1
# (保持运行,不要关闭)

# ===== 终端 3(可选):知识库管理 Web UI =====
cd faiss_frontend
python app.py
# 浏览器打开 http://localhost:8787 管理知识库打开 http://localhost:8010/dashboard.html,你会看到:
- 数字人视频画面 — Wav2Lip 实时渲染的唇形同步视频
- 文本输入框 — 可以直接打字提问
- 麦克风按钮 — 点击后说话,自动语音识别
-
对话记录区 — 显示问题和回答的文字记录

场景一:讲解知识点
用户说:"请解释一下什么是栈?"

数字人播报:
栈是一种线性数据结构
它的最大特点就是后进先出
也就是最后放进去的元素
会最先被取出来
我们可以把栈想象成一个只能在一端操作的容器
这一端叫栈顶 另一端叫栈底
以上内容主要参考了本地知识库中的资料

浏览器打开 http://localhost:8010/webrtcapi.html:
- 点击 START 按钮,看到数字人画面
- 在文本框中输入"你好,请做一下自我介绍"
- 点击 提交,等待数字人播报
所有服务都在本机运行,适合开发和演示。
# 终端 1:后端 Agent
cd 后端/agent && pip install -e . && langgraph dev
# Studio UI 可查看工作流图: https://smith.langchain.com/studio/?baseUrl=http://127.0.0.1:2024

# 终端 2:数字人前端
cd 前端/LiveTalking-main && python app.py --model wav2lip --avatar_id wav2lip256_avatar1 --tts edgetts --listenport 8010内网其他设备访问:http://你的IP:8010/dashboard.html
如需部署到云服务器,推荐使用 AutoDL 或类似 GPU 云平台。
# 1. 上传项目代码和模型文件
# 使用 scp 或 winscp 上传到服务器

# 2. 安装依赖(同 3.2 节)

# 3. 使用 tmux 后台托管服务
tmux new -s agent
cd 后端/agent && pip install -e . && langgraph dev
# Ctrl+B D 退出托管

tmux new -s frontend
cd 前端/LiveTalking-main && python app.py --model wav2lip --avatar_id wav2lip256_avatar1 --tts edgetts --listenport 8010
# Ctrl+B D 退出托管

# 4. 查看后台服务
tmux ls
tmux attach -t agent     # 进入 agent 终端
tmux attach -t frontend # 进入前端终端| 服务 | 端口 | 说明 |
|---|---|---|
| LangGraph Agent | 2024 | 后端 API |
| 数字人前端 Web | 8010(TCP) | Web 界面 |
| 数字人前端 WebRTC | 1-65536(UDP) | 音视频实时传输 |
| 知识库管理 UI | 8787 | 知识库管理界面(可选) |
⚠️ 部署到服务器时,防火墙必须开放 TCP 8010 和 UDP 1-65536 端口,否则 WebRTC 无法传输音视频。
本项目基于以下优秀的开源项目构建,在此致以诚挚感谢:
| 项目 | 用途 | 仓库地址 |
|---|---|---|
| LiveTalking | 数字人前端框架(Wav2Lip / MuseTalk / Ultralight 多模型支持) | github.com/lipku/LiveTalking |
| LangGraph ReAct Agent | 后端 Agent 工作流引擎 | github.com/langchain-ai/react-agent |
| LangChain | LLM 应用开发框架 | github.com/langchain-ai/langchain |
| FAISS | 向量相似度检索 | github.com/facebookresearch/faiss |
| Wav2Lip | 唇形同步模型 | github.com/Rudrabha/Wav2Lip |
| HuggingFace | 嵌入模型(BGE) | huggingface.co/BAAI/bge-small-zh-v1.5 |
📌 核心技术公式:课程教学数字人 = RAG 知识库(记忆) + LangGraph Agent(大脑) + Wav2Lip 数字人(嘴巴+脸) + WebRTC(高速公路)