Rapport
Projet étudiant IMT Atlantique / Télécom Bretagne Rapport MGP320
Aujourd'hui, l'informatique est omniprésent dans tous les domaines. La navigation maritime ne déroge pas à cette règle. Les systèmes de géolocalisation, de navigation, de communication en sont fortement dépendants. Cependant, il arrive que des éléments logiciels ou matériels contiennent des vulnérabilités. Celles-ci peuvent mettre à mal l'intégrité des systèmes d'informations en obtenant des droits trop élevés. Des personnes malintentionnées peuvent intercepter des communications, supprimant toute confidentialité dans les échanges. Il se peut même que des dégâts physiques soient causés. Or, on peut trouver sur internet des bases de données qui recensent les vulnérabilités. Proposées gratuitement, ces informations sont accessibles par tous. L'objectif de ce projet est de réaliser un programme qui vérifiera quotidiennement si les logiciels utilisés sur les bâtiments maritimes font l'objet d'une vulnérabilité.
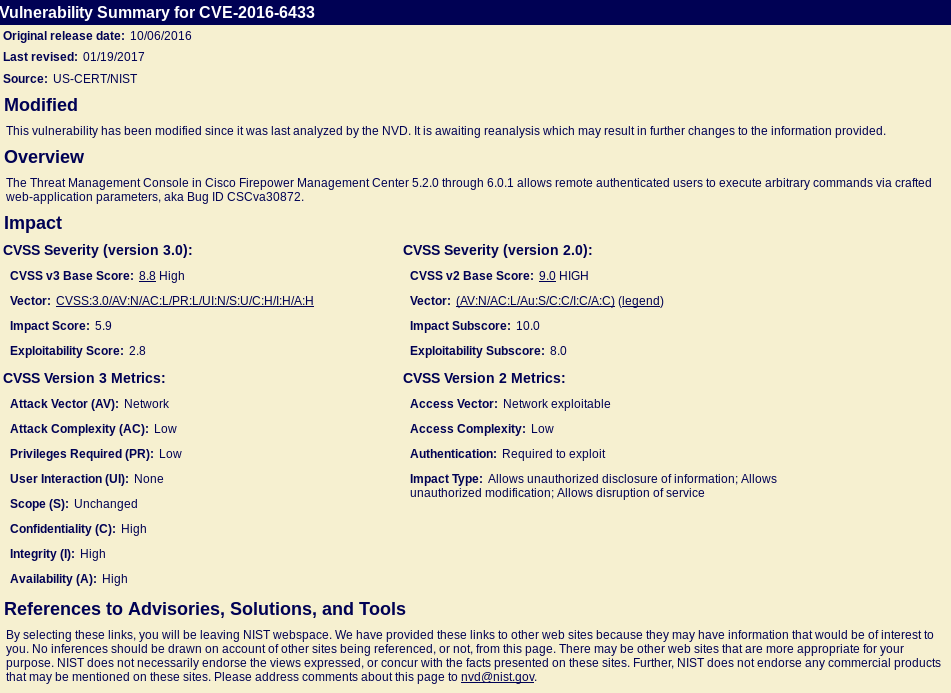
Beaucoup d'entreprises font appel à des Computer Emergency Response Teams (ou CERT) pour assurer une veille en sécurité. Ces services peuvent être proposés par des entreprises ou bien des administrations. Ils proposent de la documentation aux salariés et ils dispensent des conseils pour une bonne utilisation de l'outil informatique. L'une de leur mission est de recenser les vulnérabilités qui ont été révélées récemment. Ils sont les premiers concernés lorsque leur organisme est victime d'une faille. En France, l'Agence National de la Sécurité des Systèmes d'Information (aussi appelé ANSSI) est un service du gouvernement français. Elle se présente comme une "Autorité nationale en matière de sécurité et de défense des systèmes d’information" et constitue "un réservoir de compétences qui met son expertise et assiste les administrations et les opérateurs d’importance vitale." (http://www.ssi.gouv.fr/agence/cybersecurite/lanssi/). Elle propose une liste des vulnérabilités connues (http://cert.ssi.gouv.fr/). De l'autre côté de l'Atlantique, le MITRE travaille en relation avec le département de la Sécurité intérieure des États-Unis. Il propose un inventaire des vulnérabilités appelé Common Vulnerabilities and Exposures (CVE) au sein de la National Vulnerability Database (ou NVD). Chaque site utilise une nomenclature différente pour désigner les vulnérabilités. Pour le MITRE, chaque vulnérabilité est nommée selon la logique suivante : CVE-AAAA-NNNN où AAAA représente l'année de découverte et NNNN un numéro qui est incrémenté à chaque nouvelle découverte. Leur plus ancienne entrée dans leur base de données date de 1999.
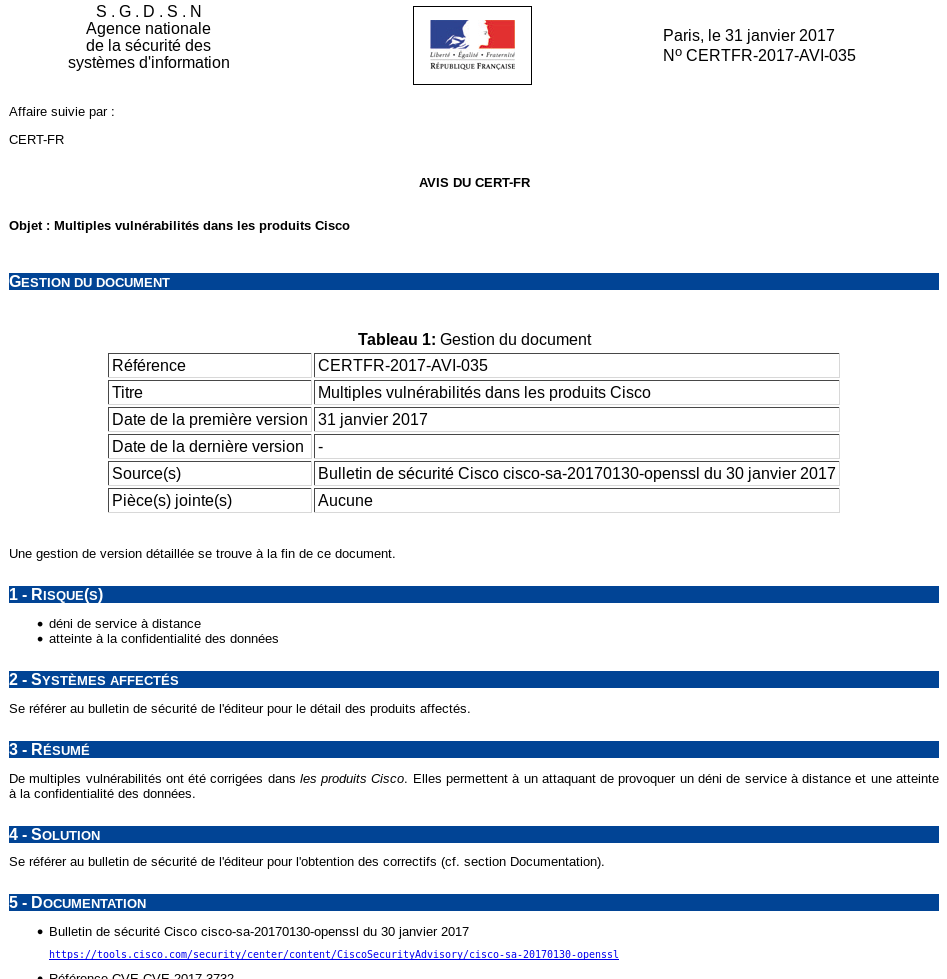
L'ANSSI utilise d'autre règles de nommage. Ils distinguent les avis des alertes. Les premiers relatent une vulnérabilité et les moyens de s'en prévenir tandis que les seconds mettent en lumière les dangers plus importants et immédiats. La nomenclature est la suivante : CERTFR-AAAA-AVI-NNN ou CERTA-AAAA-AVI-NNN pour les avis, CERTFR-AAAA-ALE-NNN ou CERTA-AAAA-ALE-NNN pour les alertes.
Le schéma suivant présente les différentes étapes dans la vie des composants logiciels d'un bâtiment maritime :
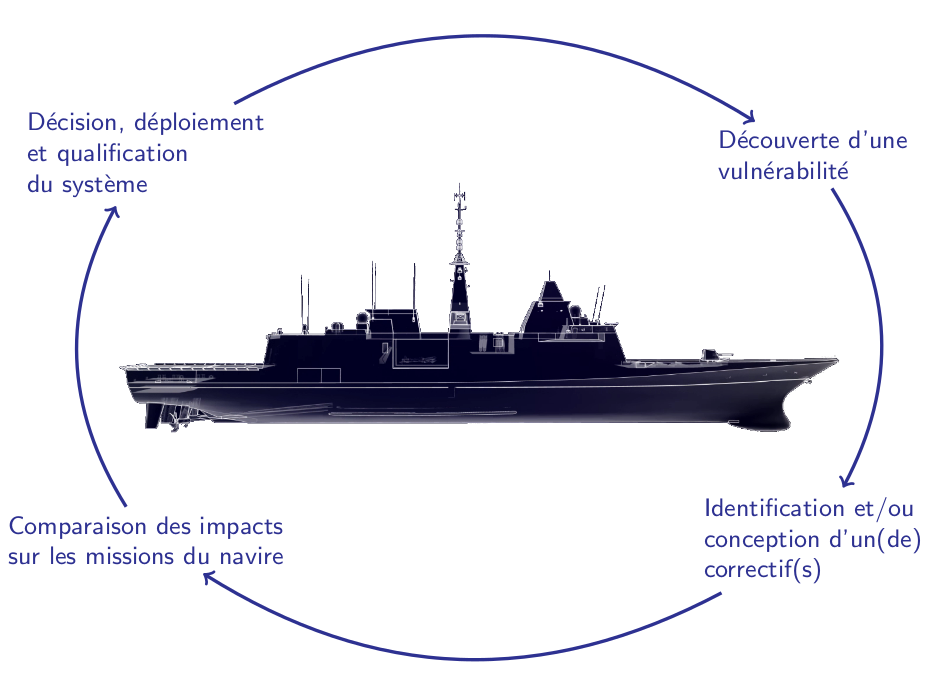 Lorsqu'une vulnérabilité est détectée, un correctif doit être trouvé. Celui-ci peut être proposé par les éditeurs eux-mêmes ou bien être conçu par les équipes internes. Lorsqu'une (ou plusieurs) solution(s) est(sont) trouvée(s), celle(s)-ci est(sont) analysée(s) pour déterminer quel sera l'impact. Une fois cette étude menée, une décision peut être prise. Soit l'accord est donné pour effectuer la modification, il faut alors réfléchir au déploiement et qualifier le système. Soit l'accord est refusé, la correction sera déployée à un moment plus opportun ou abandonnée. Notre projet concerne donc l'automatisation de la phase "Découverte de vulnérabilité" dans le schéma précédent.
Les données que l'on nous fournit détaillent les logiciels utilisés et les fonctions principales concernées. Elles apparaissent sous la forme suivante :
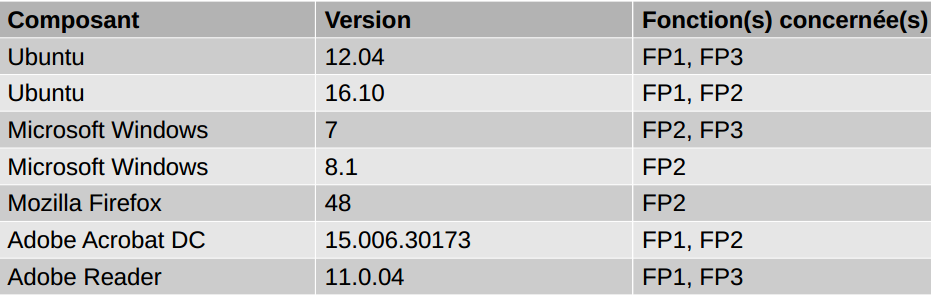 Pour faciliter l'administration des postes, les logiciels sont regroupés par fonctions principales. Par exemple, la fonction principale n°1 utilise le système d'exploitation Ubuntu dans sa version 12.04 et 16.10 tandis que la fonction principale n°2 utilise Ubuntu 16.10 et windows 7. Cela montre qu'un composant logiciel - ici Ubuntu 16.10 - peut être utilisé dans plusieurs fonctions principales -ici FP1 et FP2. Nous pouvons faire une autre remarque : une version d'un logiciel peut être concernée et pas une autre. Par exemple, seul Ubuntu 16.10 est à associer à FP2, pas Ubuntu 12.04.
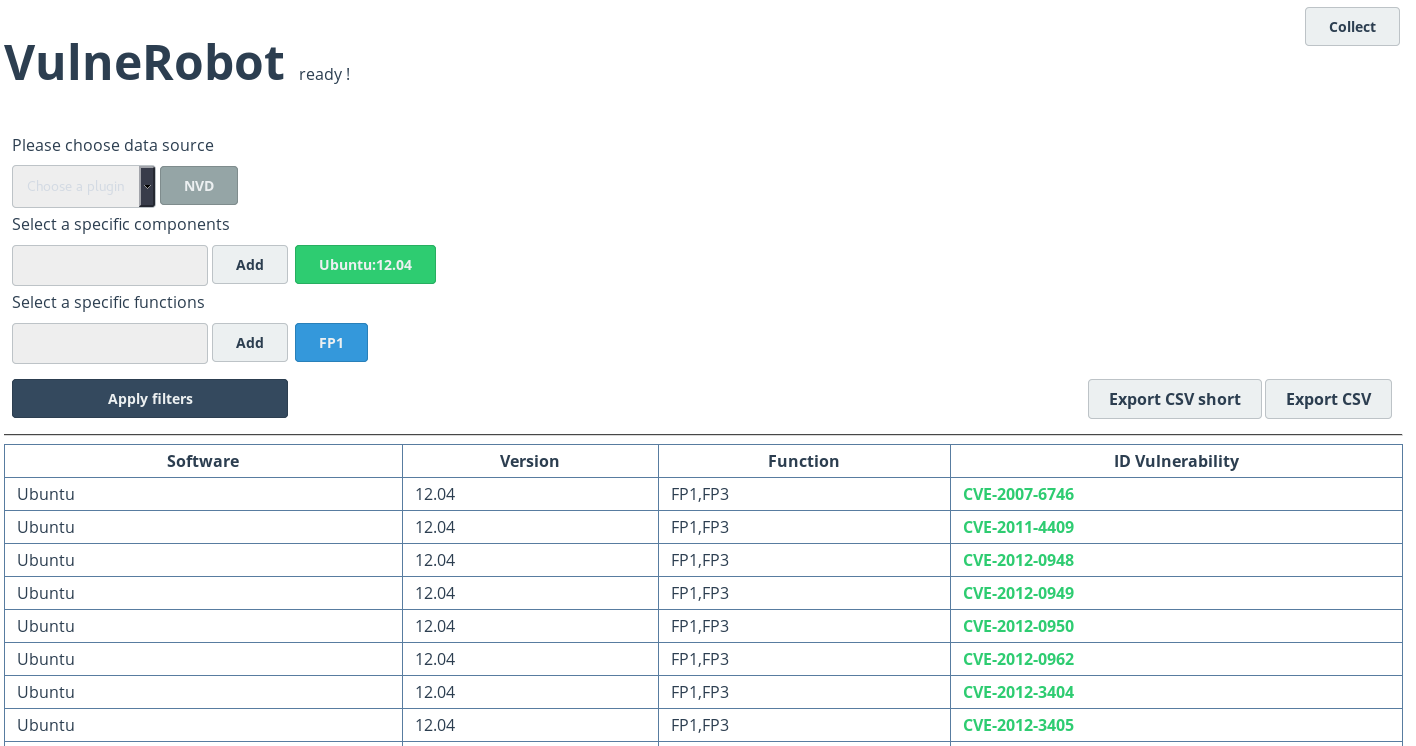
Le but de ce projet est de réaliser un outil de collecte automatique des vulnérabilités qui apparaissent sur internet. Celui-ci se nomme VulneRobot. Il reçoit en paramètre un fichier qui liste les logiciels utilisés sur un bateau. Notre programme cherche alors si les logiciels utilisés font l'objet d'une vulnérabilité. Si tel est le cas, VulneRobot les liste puis affiche les résultats. La base logicielle proposera le traitement des données. Pour analyser les sites, on rajoute alors un plugin spécifique par base de données. Ainsi, l'idée originale est de réaliser les plugins pour le site de l'ANSSI et celui du MITRE.
Fabien Dagnat et Bastien Sultan sont les deux professeurs qui ont encadré ce projet. La demande de nos encadrants était d'effectuer des réunions de présentation de notre travail et d'échange deux fois par semaine : en milieu de semaine le mercredi matin et en fin de semaine le vendredi soir.
Le rapport est à déposer sur Moodle le 6 février, tandis qu'une présentation aura lieu le jeudi 9 février. Le livrable logiciel est à proposer à la fin de la semaine, soit le vendredi 10 février.
Concernant l'aspect technique, il était demandé de proposer le logiciel de collecte VulneRobot, la base de données et un moyen de récupérer les informations. Il était également important de réaliser une documentation complète qui permette d'installer et d'utiliser la solution simplement. Par rapport aux technologies à utiliser, les contraintes étaient faibles. Seul le projet sur GitHub était créé comme solution de forge.
Les compétences étant hétéroclites entre les deux étudiants, le travail a été partagé selon les appétences de chacun. Ainsi, le premier élève est plus à l'aise avec le code et le langage Go. C'est lui qui a réalisé une grande partie du code. Néanmoins, le second étudiant a participé également à la programmation en réalisant des fonctions spécifiques ou bien en programmant l'interface Web de présentation des résultats. Celui-ci a eu une part de travail plus importante au moment de rédiger les rapports ou dans les tâches annexes.
Le planning Gantt a été réalisé avec le site teamgantt.com. L'image suivante présente le découpage des tâches au début du projet :
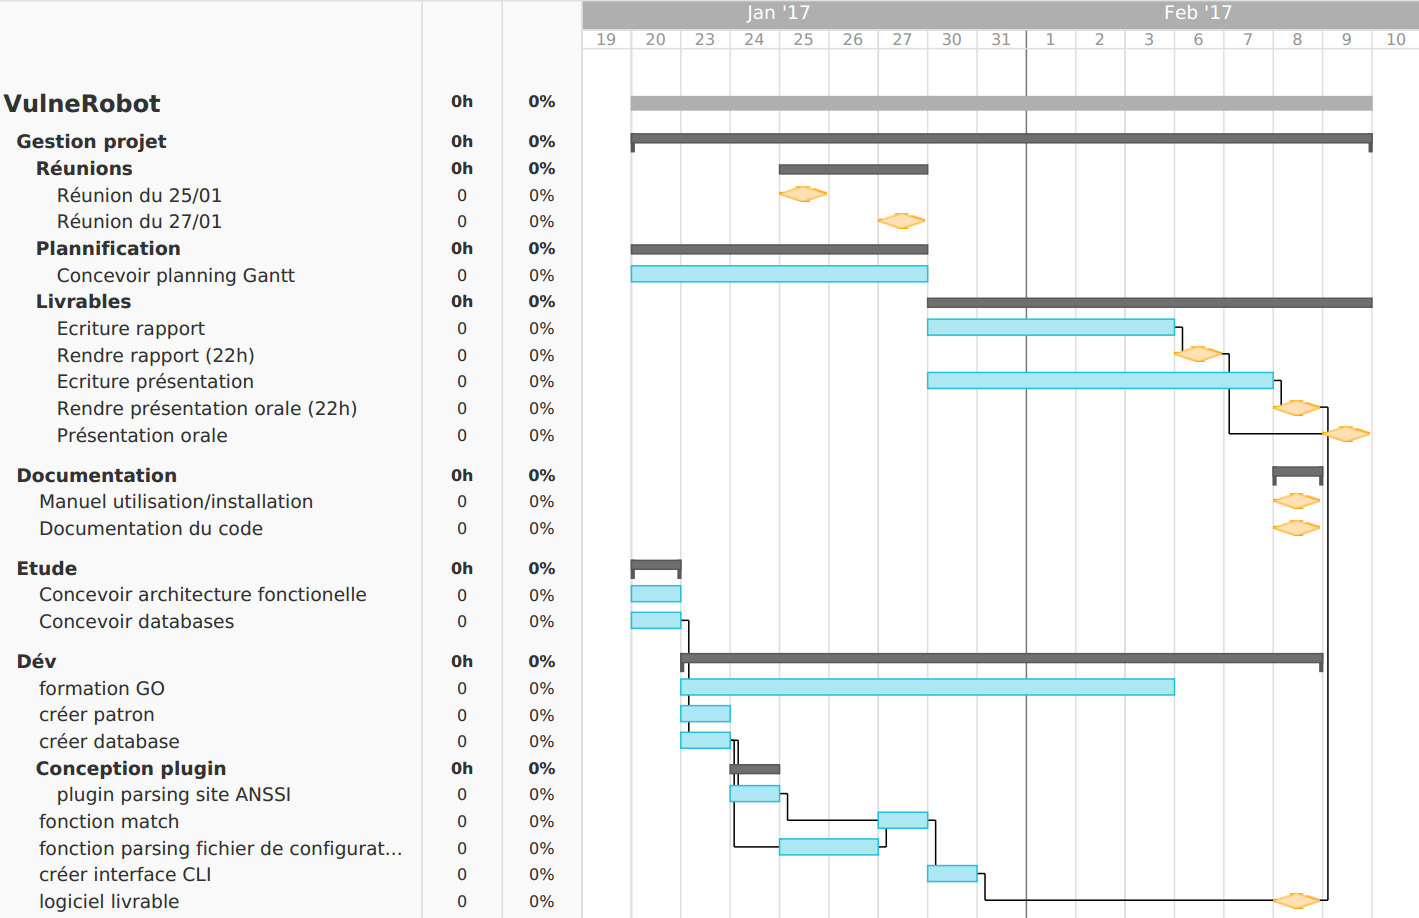 Les différents livrables apparaissent sous la forme de losanges oranges. Les tâches sont représentées par des rectangles de couleur bleu, décrivant la période durant laquelle la tâche est réalisée.
La partie gestion de projet liste les deux premières réunions prévues au début du projet. Les autres n'étaient pas programmées mais elles étaient prévues à une fréquence de deux fois par semaine. La tâche planification est prévue sur une semaine car certains points demandaient plus de précisions et auraient des impacts sur la planification initiale. Les deux autres semaines seraient utilisées pour travailler petit à petit à l'écriture du rapport, de la documentation et l'élaboration de la présentation.
La phase suivante est l'étude. Elle est le travail préliminaire au développement. La formation en langage Go s'étend sur toute la période de travail. Ce n'est pas une tâche à proprement parler puisque sa finalité ne déclenche aucune autre tâche. Comme le fait remarquer le planning, le patron du logiciel a d'abord été conçu. Cette structure permet de réaliser un projet propre et de partir sur de bonnes bases. En parallèle, la base de données et sa structure étaient créées. Une fois ces fondations réalisées, il a fallu développer les plugins permettant d'analyser les différents site. Au départ, seule l'analyse du site de l'ANSSI était attendue. En parallèle, la fonction d'analyse du fichier de configuration permettrait de lire les données décrivant les composants logiciels. La suite du projet consistait à créer une fonction qui vérifie quand une vulnérabilité et un composant logiciel correspondaient. Enfin, une interface en ligne de commande devait être développer pour lancer VulneRobot depuis une console.
Une des libertés offertes par le cahier des charges est le choix du langage de programmation à utiliser pour développer le logiciel. Dès la première réunion avec les encadrants, ce sujet a été éclairci. Le langage Go s'est avéré être un bon candidat par rapport à d'autres langages possibles (Python, C, PHP, ...). Go a de bonnes performances, proche de langage plus bas niveau comme le langage C, tout en proposant un accès simplifié à des fonctions et librairies de haut-niveau. Par exemple, un dépôt de n'importe quelle forge peut être directement importé puis utilisé dans le code. De plus, Go est accompagné d'outils intégrés au compilateur qui permettent un formalisme et un développement efficace et sûr. Il encourage l'élaboration de test et l'utilisation de "lint", une analyse du code afin d'éviter de possible erreur de programmation courante (buffer overflow, null reference, ...). Une gestion de la documentation existe aussi avec un procédé proche de la javadoc. La documentation peut-être générée avec la commande "godoc" mais aussi visualisée directement à partir de la forge et visible sur le site https://godoc.org/github.com/linuxisnotunix/Vulnerobot/modules/collectors. Ce langage, qui nécessite une compilation, est capable de générer des binaires pour la majorité des plateformes et des systèmes d'exploitations. Cela permet de garantir l’exécution du programme quelque soit l'environnement, là où des langages interprétés sont dépendants de la version de l'interpréteur et des librairies installées.
Le choix de la solution de la base de données n'est pas défini dans le cahier des charges initiale. Lors de la première réunion, nous avons décidé d'utiliser une solution compatible SQL afin de faciliter la ré-utilisation de la base de données ultérieurement par l'équipe encadrante. Au vue du faible volume de donnée et des faible accès concurrents (utilisation par un seul utilisateur), SQLite remplit le besoin. Il offre une simplicité de mise en place car le système se base sur un simple fichier pour stocker les données et il peut même la sauvegarder en mémoire vive à des fins temporaires.
Afin de prévoir les évolutions futures et faciliter le développement, une solution ORM (Object-Relational Mapping) a été utilisée, via une librairie en go GOrm. L'utilisation d'ORM permet de faire abstraction de la solution de base de données. Si le volume de donnée augmente ou si des accès concurrents devenaient nécessaires, nous pourrions utiliser d'autres bases de données plus adéquates, telles que MySQL ou PgSQL. Dans un langage orienté objet, cette solution simplifie également la programmation car elle permet de manipuler des objets plutôt que des requêtes à la base de données.
Afin de prévoir un possible évolution et ajout de source de donnée à analyser, le logiciel doit répondre au critère du cahier des charges que la partie de collecte et d'analyse doit être modulaire. Comme indiqué dans le schéma fonctionnel (en annexe), les collectors doivent implémenter une interface qui permet à un contrôleur (CollectorList) de collecteur (Collectors) afin de les instancier et de leurs demander d’exécuter la tache demander au programme, "Collector.Collect()" et "Collector.List()", mais aussi des informations sur le module lui-même "Collector.ID()".
Afin de faciliter la gestion des paramètres d’exécution et l'accès à la base de données, des classes d'accès à ces ressources sont créées sur le modèle de singleton qui s'initialise au démarrage. Par exemple, lors de la première demande d'accès à la base de données, celle-ci est crée et retourne un accès commun à la base de données. Cela permet d'éviter les problèmes d'accès concourant à la base de données.
Un module "outils" du programme fournit des fonctions statiques simples afin de faciliter des taches récurrentes du logiciel comme le fait d'analyser les paramètres de la ligne de commande ou encore le fichier de configuration. Cela simplifie le code et facilite l'application de test unitaire sur des parties spécifiques du code.
Dans un premier temps, selon le cahier des charges, le logiciel doit être exécutable à partir de la ligne de commande et doit contenir deux commandes principales. La première commande, appelée par la suite "collect", permet la phase de collection des données à partir des sources des modules. La seconde commande, appelée par la suite "list", effectue la corrélation entre la configuration logiciel connue et les données collectées précédemment. Le résultat est ensuite afficher dans le format choisi par l'utilisateur : csv ou json.
L'interface en ligne de commande propose une aide à l’exécution décrivant les différentes commandes et paramètres. Un exemple du message par défaut de l’exécution du logiciel est disponible en annexe.
Par la suite, pour faciliter l'utilisation du logiciel par des personnes moins enclins à utiliser la ligne de commande, une interface graphique de visualisation des résultats a été demandée. Dans un premier temps, il a été choisi de faire une page statique analysant un fichier de résultat généré par la commande "list". Cela a par la suite été amélioré car il est simple de proposer un serveur en langage go. Un serveur web avec des capacités permettant de fournir une interface web un peu plus évoluée et interactive a été développée. Pour ce faire, une interface REST a été créée. Les commandes de la ligne de commande sont donc accessibles directement par des urls avec les mêmes paramètres d’exécution. Par exemple, on peut exécuter "list" en appelant l'url /api/list?format=csv&functions=une_function,une_seconde_function. Le résultat sera identique au résultat de la ligne de commande.
Une première diffculté a été de déterminer précisément le logiciel concerné par une vulnérabilité. Sur les sites, le champ composant concerné par une vulnérabilité est souvent décrit textuellement, avec peu de rigueur. Par exemple, on peut lire quelques fois "Ubuntu 16.04, Ubuntu 16.10" ou "A partir d'Ubuntu 16.04" ou encore "Ubuntu 16.04 et ultérieur". Il est alors difficile d'identifier exactement les composants concernées par la vulnérabilité. L'organisme américain National Vulnerability Database a défini un standard de nommage de logiciel et de leurs versions et les stocke dans un dictionnaire accessible en ligne (https://nvd.nist.gov/cpe.cfm). Ce standard s'appelle Common Platform Enumeration et représente de manière simple un logiciel de part son type, son nom et sa version exemple : https://nvd.nist.gov/cpe.cfm L'utilisation de se référentiel nous permet de consolider notre validation de l'existence d'une vulnérabilité voir même la confirmer avec certitude dans le module NVD ou les CPE sont référencés avec leurs versions dans toutes les déclarations de vulnérabilités.
Les pages de déclaration de l'ANSSI ne respecte pas un formalise et ont évoluées au cours du temps. Il est donc plus difficile de collecter les données de se site car les titres des sections peuvent changer d'ordre voir même de nommage. Le site étant aussi en français une sur-couche de translation doit être faite pour l'analyse de certain élément comme les dates.
Une autre complexité est apportée par la manière dont sont décrit les logiciels impactés (ex : Ruby 1.8.5 et versions antérieures, Airwatch Agent sans le dernier correctif de sécurité, ...). Ils sont décrit littéralement et même si le nommage respect une norme globale il peut varier en fonction des alertes et des années.
Ce projet a permis de réaliser un travail important en peu de temps. Il a débuté par une étude des caractéristiques logicielles. Cette phase a permis de réfléchir aux différents aspects architecturaux, autant au niveau fonctionnel que de l'organisation des données. Il était ensuite plus aisé de commencer le travail efficacement. Nous aurions pu nous attendre à des difficultés suites à la différence de niveau entre les deux élèves. Cependant, chacun a pu participer dans la partie programmation ainsi que dans les tâches d'accompagnement. Le résultat a été beaucoup apprécié par les encadrants. Il est concluant, la documentation est importante et la prise en main est aisée, particulièrement grâce à l'utilisation d'une interface web. Le travail pourra être poursuivi, notamment en augmentant le nombre de plugins. Accroître l'optimisation du code pourrait aussi être une amélioration à apporter.
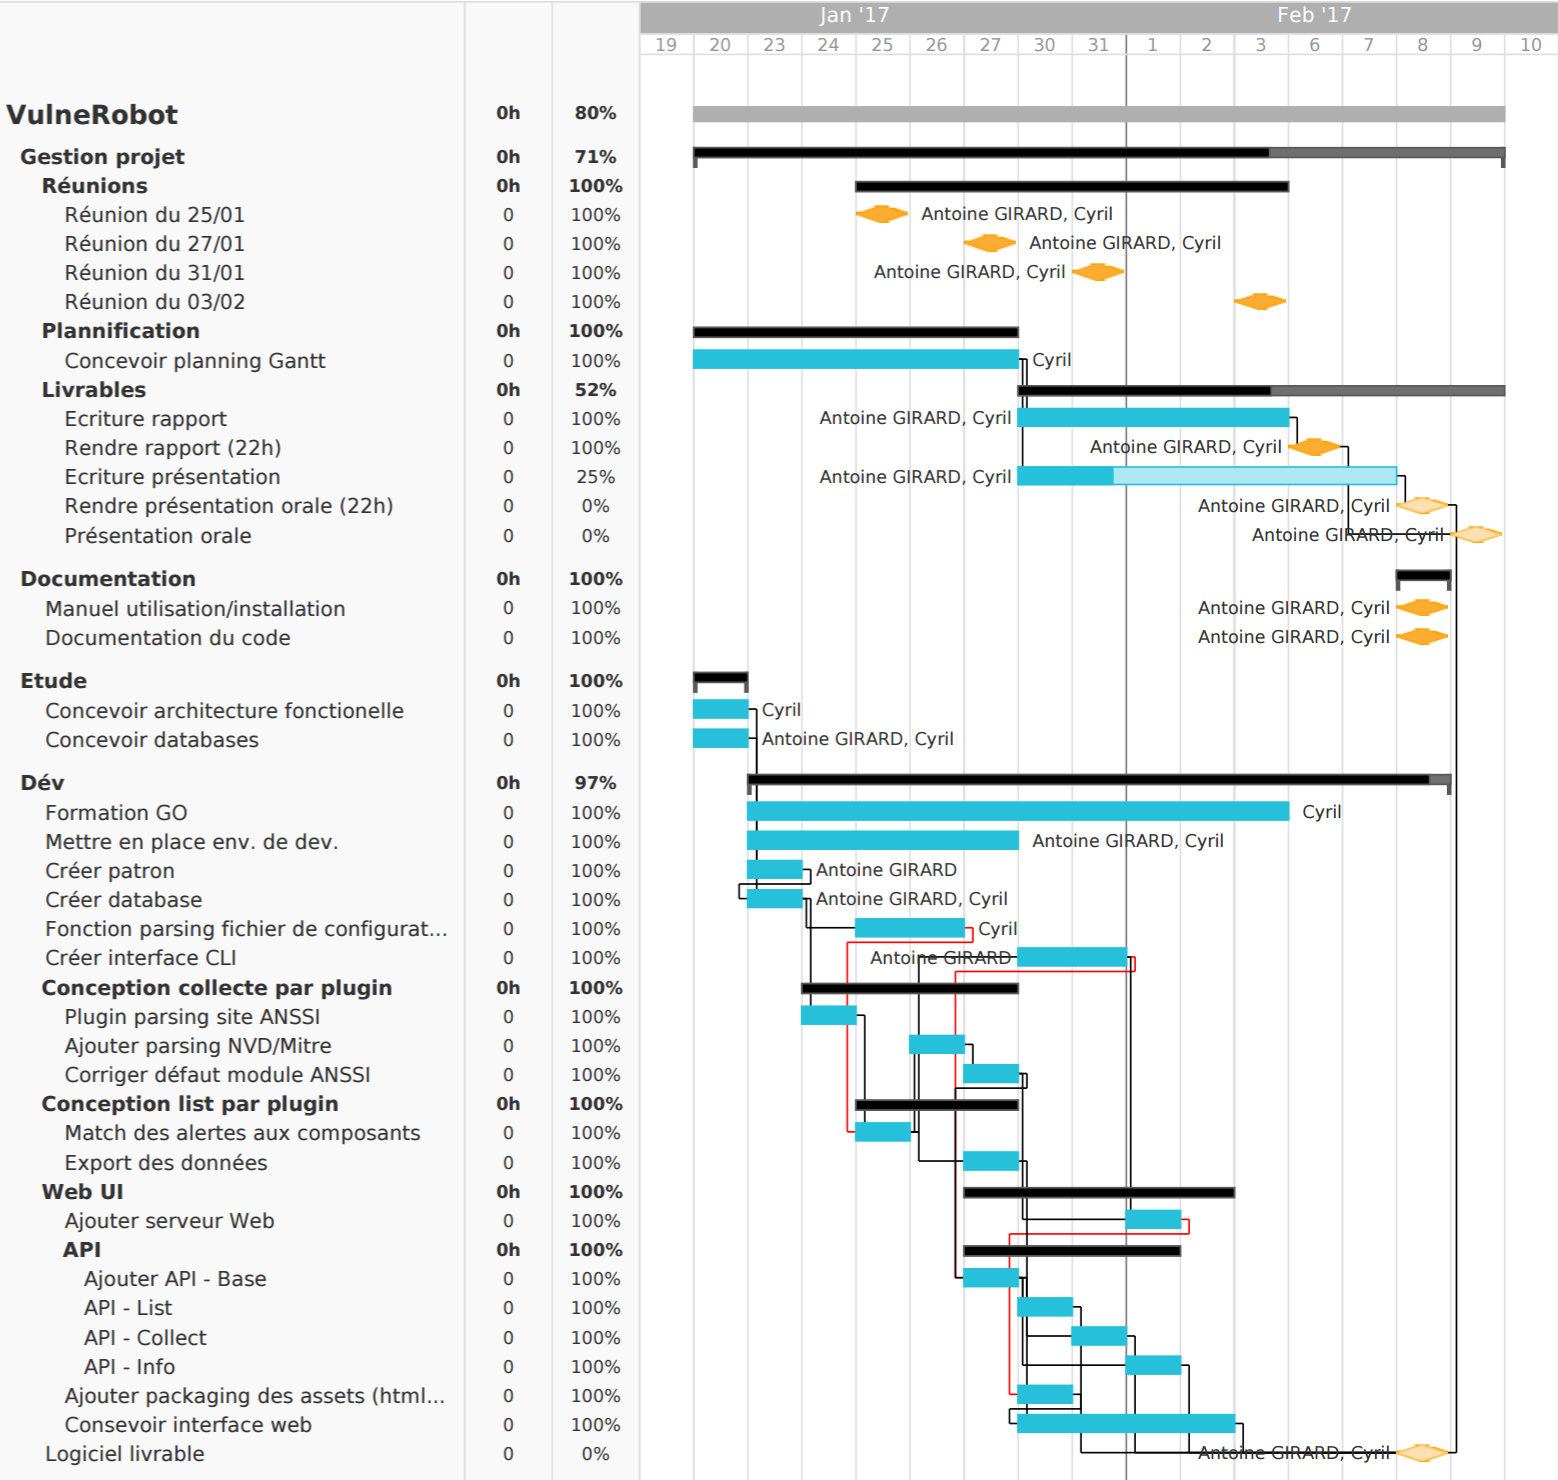 L'image précédente représente le planning Gantt à la fin de la rédaction de ce rapport. De nombreuses tâches ont été ajoutées. Par exemple, les encadrants ont demandé un affichage sur une page web. Il a fallu rajouter des tâches pour créer l'API et le site web. Certaines tâches se sont révélées plus longues que prévues car elles étaient mal appréhender. Nous aurons ainsi une idée plus juste du temps à dédier à une tâche la fois prochaine. De plus, dans le déroulement des tâches, on peut voir des flèches rouges qui relient deux tâches revenir en arrière. C'est par exemple le cas entre les tâches Fonction parsing (analyse) du fichier de configuration et match (corrélation) des alertes. Pour se faire, on utilisait des jeux de données qui suivaient une certaine syntaxe qu'il était facile de reproduire. Enfin, un défaut de ce planning est que l'unité de base est le jour, et non l'heure. C'est pour cela que certaines tâches sont indiquées durer une journée alors qu'elles ont nécessité que quelques heures.
NAME:
   Vulnerobot - Index CVE related to a list of progs

USAGE:
   vulnerobot [global options] command [command options] [arguments...]

VERSION:
   testing

COMMANDS:
     collect, c  Collect CVE from modules and add them to database
     list, l     List known CVE in database from a application list
     info, i     Display global info like the of list plugins availables
     web, w      Start a web server to display result.
     help, h     Shows a list of commands or help for one command

GLOBAL OPTIONS:
   --debug, -d                   Turns on verbose logging [$DEBUG]
   --config value, -c value      Application list to monitor (default: "data/configuration")
   --database value, --db value  Application database to use (default: "data/sqlite.db")
   --help, -h                    show help
   --version, -v                 print the version