Repository navigation
Analysis and Presentation
← Home · System Overview · InterSubMod · LongLineage · Upstream · Analysis · How to Run
部件分冊 · 第 15 頁 · Python 分析層 + HTML 呈現層
C++ 只吐檔案,把資料變成看得懂的圖與表的是這一層。這也是實驗室同學實際上花最多時間的地方。本頁挑出真正該用的入口,並誠實說明這層目前的碎片化問題。
| 數字 | 意義 |
|---|---|
| 2,144 | 全 repo 的 Python 檔 |
| 59 / 117 | |
| 182 | 🔴 硬編了別的分支路徑的腳本 |
| 1 | ✅ 最推薦的第一支腳本(見下) |
如果你只想跑一個指令來確認整套東西是活的,跑這個。
cd /big7_disk/liaoyoyo2001/InterSubMod/docs/methodology/_assets/20260627_subclone_4axis_teaching/scripts
python3 verify_pipeline_numbers.py它會做什麼:把方法說明文件裡的每一個數字重新算一次,並與文件宣稱值比對。實跑輸出摘要:
sSNV 總數 35,332(TP 30,490 / FP 4,842)      ✓
共現連上   21,554  ·  訊號不足 5,458  ·  孤立 8,320   (加總 = 35,332 ✓)
✅ 實跑 exit 0 — 這支腳本的價值在於它是可執行的文件:如果數字對不上,它會直接告訴你,而不是讓錯誤的數字悄悄流進報告。
建議的閱讀順序 先跑上面這支確認環境沒問題 → 再看 §02 挑你需要的分析腳本 → 最後用 §03 的工作站 HTML 看結果。
從 2,144 個 Python 檔中挑出真正是「入口」的那幾支。
| 腳本 | 產出什麼、回答什麼問題 |
|---|---|
verify_pipeline_numbers.py✅ 先跑這個 |
一鍵重算並驗證方法文件裡的每個數字。最適合當第一支跑的腳本。 |
sm_linkage_genomewide.py |
建立全基因組突變共現地圖 —— 這是整套方法的骨幹。對每一對距離 50 kb 內的突變,統計有幾條 read 同時看到它們、四種等位組合各幾條、判成巢狀/互斥/共連鎖/獨立哪一種關係。 實測產物 26.5 MB:53,094 對配對 + 35,332 筆位點帳本。 |
build_strict_ps_hp_regions.py |
用嚴格規則切出可建樹的區域:同一定相組、同一 germline 單倍型內、至少 3 條分子同時確定兩端 —— 才連一條邊。 🔴 距離只記錄、不參與連邊,這是刻意的方法學選擇(避免用幾何鄰近冒充分子連鎖)。 |
build_layered_per_sample.py |
產生 7 樣本的分層工作站 HTML(呈現層主成品)。 |
build_exact_ps_layered_workstation.py |
4,741 行的完整工作站建構器。支援 --verify-only —— 只驗證上游契約還成立、不重建,適合用來確認資料沒漂移。 |
build_workstation.py通用 |
317 行的通用工作站生成器:吃一份宣告式 spec,吐互動判讀 HTML。見 §03。 |
關鍵中間產物 — 想直接分析資料時該讀哪些檔
| 檔案 | 內容 |
|---|---|
per_sSNV_census.tsv |
每個突變一列的帳本:來源、正常組織的支持數、是否確認為體細胞突變、變異頻率、50 kb 內有幾個潛在夥伴、實際連上幾個、最高共讀深度、拷貝數狀態。 |
regions.tsv |
每個共現區域一列:座標、跨度、含幾個突變、重建出的樹是什麼形狀、節點數、巢狀/兄弟關係各幾對、最大深度、有沒有矛盾。 |
funnel_census_HCC1395.json |
所有百分比的分母來源。六層漏斗,每層丟了多少、為什麼丟,並自我檢查各層加總等於總數。要引用任何比例前先看這個檔。 |
產出的是零外部依賴、可離線開啟的單一 HTML 檔,可以直接寄給別人。
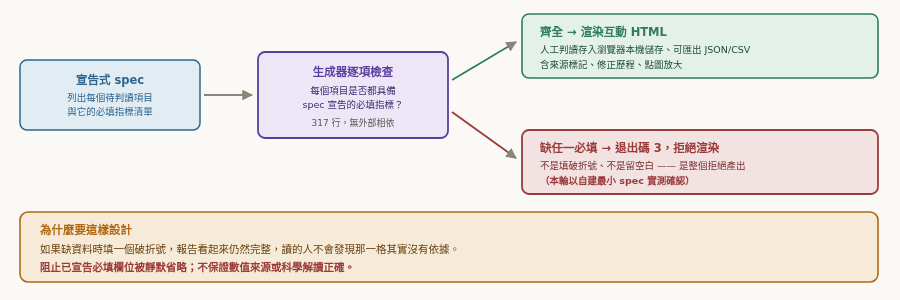
這個設計來自一次真實事故:曾有報告把「預期數字」當成真實結果寫進 HTML,而分析其實沒跑完。純文字的規則擋不住,只有讓它在構造上做不到才有效。
🔴 但目前這個通用生成器只有 2 個真正的複用者 —— 實務上大家用的是 4,741 行的專用版本。這是這一層最明顯的技術債。
圖中流程(逐字對應):
| 階段 | 內容 |
|---|---|
| 宣告式 spec | 列出每個待判讀項目與它的必填指標清單 |
| 生成器逐項檢查 | 每個項目是否都具備 spec 宣告的必填指標?(317 行,無外部相依) |
| ✅ 齊全 → 渲染互動 HTML | 人工判讀存入瀏覽器本機儲存、可匯出 JSON/CSV;含來源標記、修正歷程、點圖放大 |
| 🔴 缺任一必填 → 退出碼 3,拒絕渲染 | 不是填破折號、不是留空白 —— 是整個拒絕產出(本輪以自建最小 spec 實測確認) |
| 檔案 | 大小 | 備註 |
|---|---|---|
HCC1937.html |
14.6 MB | ✅ 示範給人看時先開這個 —— 最小、開得動 |
HCC1395.html |
35.5 MB | 主力樣本 |
COLO829.html |
41.5 MB | 有外部真值可對照 |
H1437.html |
72.3 MB | |
H2009.html |
188.2 MB | 🔴 瀏覽器開這個會很慢且吃大量記憶體 |
7 個工作站合計約 393 MB,不進 git(該目錄有自己的忽略規則)。每個頁面的 HTML 標頭內嵌了上游各收據的 SHA-256 當作防漂移印記。
| 圖種 | 怎麼看 |
|---|---|
| 雙面板熱圖 | 左邊是 read × CpG 甲基化矩陣(藍=未甲基/紅=甲基/灰=無資料),右邊是同一批 read 的兩兩距離矩陣(暗=相近/亮=相遠)。左側固定側欄依序是 群 | 單倍型 | 突變型 | 腫瘤/正常 | 正反股。 要看的是:同一群 read 是不是同時在「甲基化型態」與「帶不帶突變」上都一致。 |
| 全基因組染色體圖 | 22 條染色體橫條,用紅色深淺表示突變密度,疊上著絲點位置。 用途:目視確認密集區是不是落在已知的假象好發區。 |
這是全系統目前最碎片化的一層,以下問題都是實測確認的。
預設 python3 是 3.9.12,但部分腳本需要 3.10。照著說明打 python3 scripts/build_strict_ps_hp_regions.py 會在 import 階段就崩,而且錯誤訊息指向 dataclass 而不是版本問題 —— 極容易誤以為程式壞了。
解法:改用 /usr/bin/python3.10。
(run_layered_v4_strict.py 有自動偵測會幫你處理,但直接呼叫子腳本時沒有這層保護。)
這些腳本硬編了一個 git worktree 的絕對路徑,而那個 worktree 目前 checkout 在另一個分支上(不是主工作分支)。
也就是說這些圖與中間結果實際上是從另一個分支的檔案樹讀出來的。那個 worktree 一旦被移除或切換分支,這 182 支腳本會全部靜默讀到不同內容,或直接找不到檔案。
scripts/ism_heatmap_std.py 看起來像可執行的入口,但它沒有 main、沒有參數解析 —— 直接跑它什麼都不會發生(它只定義常數與函式)。
真正畫圖的是 import 它的那些 renderer。它是熱圖規格的單一真實來源(側欄順序、配色),有專門的稽核腳本檢查其他頁面有沒有偏離這個配色。
scripts/ 下 268 個 Python 檔中,117 個會讀 CSV/TSV,但其中 59 個(超過一半)原始碼裡沒有任何 schema 或欄位檢查。
配合 ISM 分冊提到的「significance_summary.csv 欄數跨版本不一致」,這代表拿舊資料餵新腳本時很可能靜默讀到錯的欄位。
自保做法:自己寫分析時一律用欄名取值,不要用欄號。
-
腳本可用性:主力腳本的
--help本輪實跑取 exit code;verify_pipeline_numbers.py完整跑完並讀回輸出。 - 拒絕渲染行為:以自建的最小 spec(故意缺一個必填指標)實測,確認退出碼為 3。
-
檔案大小與腳本計數:實際
ls與遞迴統計,非估計值。 -
python 版本問題:以預設
python3實跑重現崩潰,再以 3.10 實跑確認正常。
路徑:InterSubMod/docs/explain/15_python-html-layer.standalone.html · 分支 research/subclonal-reconstruction-202606 · 建立於 2026-08-06
← 上一頁:Upstream & Data · 回 System Overview · 下一頁:How to Run →