Repository navigation
InterSubMod Engine
← Home · System Overview · InterSubMod · LongLineage · Upstream · Analysis · How to Run
部件分冊 · 第 12 頁 · InterSubMod(
inter_sub_mod)
這是目前真正跑得動、也真正產出論文核心數字的那支程式。本頁把它的 3 個必填輸入、8 個處理階段、17 種輸出檔案全部攤開,每個檔案都附實際 head 出來的 header 與資料行。
給它一個腫瘤 BAM、一份參考基因組、一份體細胞突變清單(VCF),它會對每個突變位點開一個視窗,把跨過該位點的每一條 read 的甲基化狀態排成矩陣,算 read 兩兩之間的距離、做階層分群與統計檢定,全部落成檔案。
為什麼要這樣做: 一般 bulk 定序把所有細胞的訊號平均掉了。ONT 長 read 可以在單一分子上同時看到「這條分子帶的是突變型還是正常型」與「這條分子上的 CpG 甲基化型態」,因此能用 read 層級(而非樣本層級)的分群,去檢驗「帶突變的 read 是否在甲基化上自成一群」。
✅ 實測可跑 — 最小指令 2.9 秒完成、exit 0;含 normal BAM 與 LOH 標註的完整版本也 exit 0。
🔴 用之前一定要知道的一件事
目前
build/bin/inter_sub_mod這個執行檔是 STALE 的 —— 有 5 個原始碼檔的修改時間比它還新。跑之前請先重新編譯,否則你跑的不是現在的程式碼。
下表的「實際路徑」都是磁碟上真實存在的檔案,可直接拿去跑。
| 參數 | 必填 | 這是什麼、程式拿它做什麼 | 限制與實測值 |
|---|---|---|---|
--tumor-bam-t
|
必填 | 腫瘤樣本的長 read 比對檔。程式只抓跨過該突變位點的 read,並從中讀取 MM/ML 甲基化標記與 HP 單倍型標籤。 | 需 .bai 索引(缺了只印 Warning 不擋,但隨機存取實際上會失敗)。實測: data/bam/HCC1395/tumor.bam = 283 GB,同目錄有 119 MB 的 .bai。 |
--reference-r
|
必填 | 參考基因組序列。用來找出視窗內所有 CpG 的位置(要先有序列才知道哪裡是 CG),也用來決定染色體長度以裁切視窗邊界。 | 🔴 .fai 索引缺失是 Hard error,程式會直接停。實測: data/ref/hg38.fa → GRCh38(3.14 GB)。 |
--vcf-v
|
必填 | 體細胞突變清單。每一筆記錄 = 一個分析區域。VCF 裡有幾個突變,就會產生幾個 region 目錄。 | 🔴 VCF 的檔名會變成輸出目錄的第一層(取 stem)。 實測: filtered_snv_tp.vcf.gz = 1.15 MB。 |
--normal-bam-n
|
選填 | 配對正常組織。給了它才會有:germline 甲基化基準線、腫瘤對正常的殘差、跨區域分層。不給的話這些欄位一律是 NOT_APPLICABLE_TUMOR_ONLY。 |
正常 read 是用整個視窗抓(不是點抓),因為它們貢獻的是甲基化基準而非突變判讀。 原始碼註解明文:不要把 normal 的 HP 硬改成 0。 |
--loh-bed |
選填 | 雜合性缺失(LOH)區間標註。用來在結果表填三個 LOH 相關欄位,讓後續分析可以把 LOH 區域分層看待。 | 只硬性要求前 3 欄,第 4 欄之後整行當註解字串。 實測檔案 1,094 行,載入時印 Loaded 1094 LOH regions。 |
全部 29 個 CLI 選項的預設值 — 以及兩個文件與程式碼不符的陷阱
本輪把 --help 的每一行都對照 ArgParser.hpp 與 Config.hpp 逐一比對。大部分一致,但有兩個會讓你算錯資源或拿到非預期結果:
| 選項 | help 說的 | 實際的 | 後果 |
|---|---|---|---|
--threads / -j
|
Default: 1 |
實際是 16 ( Config.hpp:43) |
不給這個旗標時,程式會用 16 條執行緒。資源估算會整整差 16 倍。實跑不帶旗標時 Configuration 印 Threads: 16。 |
--distance-metric |
宣告預設 BERNOULLI( Config.hpp:40) |
實際是 NHD ( ArgParser.hpp:86,168) |
ArgParser 會無條件清空宣告的預設值再填入 NHD,所以 Config.hpp 的初值不可能存活。不明講就會拿到 NHD,且只產生 distance/NHD/ 目錄。 |
其餘經比對確認一致的預設值:--window-size 1000、--min-mapq 20、--min-read-length 1000、--min-base-quality 20、--min-common-coverage 3、--nan-distance-strategy SKIP、--methyl-high 0.8、--methyl-low 0.2、--output-dir output、--log-level info。
🔴 另外三個設定是死的(在 Config.hpp 以外零引用):min_site_coverage、pmd_gating、pmd_bed_path。也就是說「本方法有 PMD gating」「有最小位點覆蓋度過濾」是錯的敘述,不可寫進方法學章節。
🔴 --help 的 exit code 是 1 不是 0(help 與 parse error 共用同一條 return 路徑)。寫 CI smoke test 時 --help && next 這種寫法會誤判失敗。
程式內部共 20 個細部步驟,下圖濃縮成 8 個關鍵階段。每個階段標了實際生效的參數。
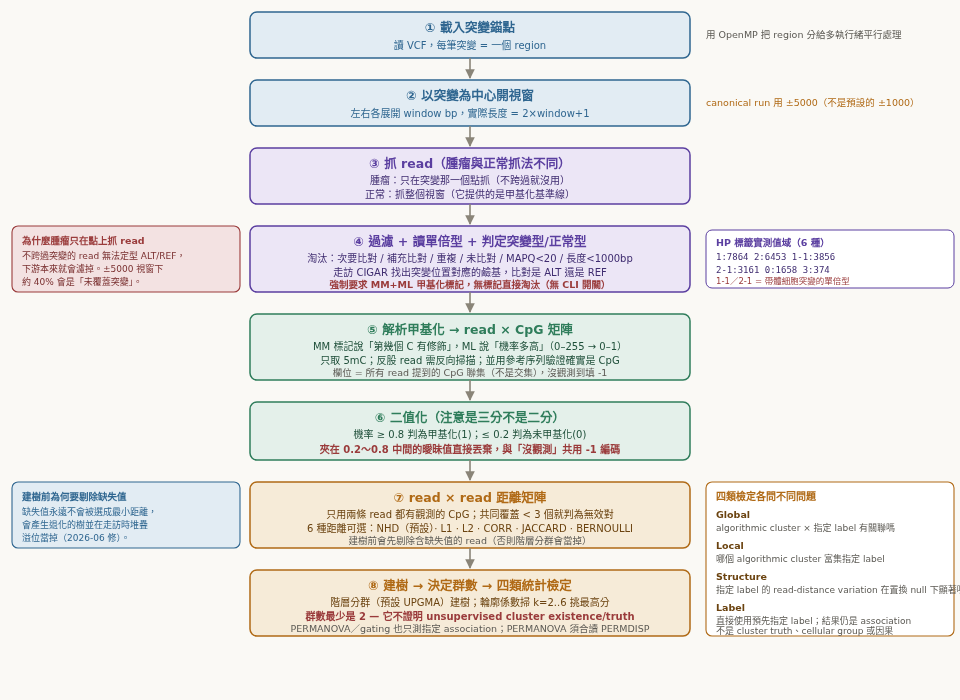
圖 1 · InterSubMod 內部處理鏈(每個方框下方是實際生效的參數,非文件宣稱值)
最容易誤解的一步是 ⑥ 二值化:它不是把機率一刀切成 0/1,而是三分 —— 中間帶(0.2~0.8)被視為「不可信」直接丟棄。這代表曖昧的甲基化訊號與「根本沒測到」在下游是同一件事,分析時要意識到這個資訊損失。
另注意:程式裡其實有三套不同的二值化門檻(主線 0.8/0.2、另一模組硬寫死的 0.5、Python 端的 128/255),同一個 CpG 會因為走哪條路而得到不同判定,跨模組的數字不可直接比較。
| # | 階段 | 實際生效的內容 |
|---|---|---|
| ① | 載入突變錨點 | 讀 VCF,每筆突變 = 一個 region。用 OpenMP 把 region 分給多執行緒平行處理。 |
| ② | 以突變為中心開視窗 | 左右各展開 window bp,實際長度 = 2×window+1。 |
| ③ | 抓 read(腫瘤與正常抓法不同) | 腫瘤:只在突變那一個點抓(不跨過就沒用)。 正常:抓整個視窗(它提供的是甲基化基準線)。 |
| ④ | 過濾 + 讀單倍型 + 判定突變型/正常型 | 淘汰:次要比對 / 補充比對 / 重複 / 未比對 / MAPQ<20 / 長度<1000bp。 走訪 CIGAR 找出突變位置對應的鹼基,比對是 ALT 還是 REF。 🔴 強制要求 MM+ML 甲基化標記,無標記直接淘汰(無 CLI 開關)。 |
| ⑤ | 解析甲基化 → read × CpG 矩陣 | MM 標記說「第幾個 C 有修飾」,ML 說「機率多高」(0–255 → 0–1)。 只取 5mC;反股 read 需反向掃描;並用參考序列驗證確實是 CpG。 欄位 = 所有 read 提到的 CpG 聯集(不是交集),沒觀測到填 -1。 |
| ⑥ | 二值化(注意是三分不是二分) | 機率 ≥ 0.8 判為甲基化(1);≤ 0.2 判為未甲基化(0)。 🔴 夾在 0.2~0.8 中間的曖昧值直接丟棄,與「沒觀測」共用 -1 編碼。 |
| ⑦ | read × read 距離矩陣 | 只用兩條 read 都有觀測的 CpG;共同覆蓋 < 3 個就判為無效對。 6 種距離可選:NHD(預設)· L1 · L2 · CORR · JACCARD · BERNOULLI。 建樹前會先剔除含缺失值的 read(否則階層分群會當掉)。 |
| ⑧ | 建樹 → 決定群數 → 四類統計檢定 | 階層分群(預設 UPGMA)建樹;輪廓係數掃 k=2..6 挑最高分。 🔴 群數最少是 2 — 它不回答「到底有沒有結構」。 有沒有結構要看 PERMANOVA 與 gating,不是看 k。 |
1:7864    2:6453    1-1:3856
2-1:3161  0:1658    3:374
🔴 1-1 / 2-1 = 帶體細胞突變的單倍型。
| 檢定 | 它在問什麼 |
|---|---|
| Global | 分群結果與生物標籤有關聯嗎 |
| Local | 哪一群特別富集某個標籤 |
| Structure | 群在距離空間真的分開了嗎 |
| Label | 直接拿已知標籤切,避開先分群再檢定的循環論證 |
- 為什麼腫瘤只在點上抓 read — 不跨過突變的 read 無法定型 ALT/REF,下游本來就會濾掉。±5000 視窗下約 40% 會是「未覆蓋突變」。
- 建樹前為何要剔除缺失值 — 缺失值永遠不會被選成最小距離,會產生退化的樹並在走訪時堆疊溢位當掉(2026-06 修)。
輸出分兩層:region 層(每個突變位點一個目錄)與 run 層(整次執行一份總表)。下面所有 header 與資料行都是實際從磁碟 head 出來的,不是照文件抄的。
reads/reads.tsv — 10 欄 — 這個位點有哪些 read
每條 read 一列:內部編號、真正的 read 名字(UUID)、座標、比對品質、單倍型標籤、支持突變型還是正常型、來自腫瘤還是正常、正反股。
read_id	read_name	chr	start	end	mapq	hp	alt_support	is_tumor	strand
0	56c0d051-1557-44af-99cc-46f5b9f48136	chr1	101290545	101347892	60	2-1	ALT	1	+
注意檔案在 reads/ 子目錄下,不在 region 根目錄。
methylation/methylation.csv — ⚠️ 核心矩陣 — read × CpG 甲基化機率
每一列一條 read,每一欄一個 CpG,欄名就是基因體座標,格子裡是甲基化機率 0–1,沒觀測到寫 NA。
read_id,101330345,101330431,101330517,101330633,101330755,101330799,...
0,NA,0.0235,0.0275,0.9922,0.0667,0.0078,...
🔴 這裡有一個會靜默出錯的陷阱
第一欄
read_id是矩陣列號(整數),不是 read 的名字。要知道第 0 列是哪條 read,必須去reads.tsv用同一個read_id查。也就是說甲基化與 read 身分的綁定完全靠列序約定,程式沒有任何 key 校驗 —— 任何一邊做了過濾或重排而沒同步,就會把甲基化配到別條 read 的單倍型上,而且不會有任何錯誤訊息。
搭配檔 methylation/cpg_sites.tsv(3 欄)把欄號對回實際座標:
cpg_id	chr	position
0	chr1	101330345
distance/<METRIC>/matrix.csv — read 兩兩距離方陣
N×N 方陣,第一欄與 header 都是 read_id,6 位小數,無法計算的填 NA。<METRIC> 是子目錄名(如 NHD、BERNOULLI),指定幾個 metric 就會有幾個子目錄。
read_id,0,1,2,3,4,5,6,7,8,...
0,0.000000,0.000000,0.142857,0.400000,0.333333,0.250000,...
同目錄另有 stats.txt(距離矩陣的體檢報告:用哪個 metric、多少對 read 有足夠共同 CpG、距離分佈)與分股版本 matrix_forward.csv / matrix_reverse.csv。
clustering/tree.nwk — 🔴 最容易誤讀 — 階層分群樹
(((((((56c0d051-1557-44af-99cc-46f5b9f48136:0.000001,15a3bad6-8744-45e2-a577-...
🔴 這棵樹的葉子是 read,不是 clone
葉節點標籤是 read 的名字(BAM 裡的 QNAME,一串 UUID)。這是一棵**「read 依甲基化相似度」的階層分群樹**,不是細胞亞群的演化譜系樹。兩者是完全不同的東西,非常容易在報告裡被誤引。
同目錄的 leaf_order.txt 是樹上葉子從左到右的順序 —— 畫熱圖時要照這個順序排 read,圖才會跟樹對得上。
🔴 clustering/linkage_matrix.csv 副檔名是 .csv,但實際內容是 TAB 分隔。用 pandas.read_csv() 預設的逗號分隔去讀,整列會變成單一欄位,而且不會報錯。必須寫 sep='\t'。
significance_summary.csv — 🔴 跨版本不相容 — 下游幾乎只吃這一份
一列一個 region,把所有統計欄位攤平。實務上絕大多數下游分析都只讀這個檔。
RegionID,Chr,Pos,Ref,Alt,NumReads,NumCpGs,GlobalP,CramersV,GlobalP_HPFamily,...
0,chr1,877772,G,C,46,17,2.990000e-01,0.0000,3.065000e-01,0.0000,...
🔴 欄數會隨 binary 版本改變,而且檔案裡沒有版本欄位
磁碟上實測到的欄數有 59 / 114 / 117 / 157 / 180 五種,而目前原始碼是 193 欄。意思是不同時期跑出來的結果,欄位位置是錯開的。任何用固定欄號(而非欄名)解析的下游腳本,會靜默讀到錯的欄位。務必用欄名讀,並記錄產生該檔的 binary 版本。
| 其他 run 層檔案 | 內容 |
|---|---|
significance_statistics.txt |
一頁摘要:總共處理幾個 region、多少個顯著、各染色體分別多少。實測開頭 === Significance Analysis Statistics ===、Total Regions Processed: 1982。 |
run.log |
這次跑用了什麼輸入與參數,開頭是 --- Configuration --- 區塊。這是回溯任何一份輸出「怎麼來的」唯一可靠依據,不要刪。 |
subclone_structure.txt |
跨 region 的分組摘要(分幾群、平均 ASM、LOH 比例)。只在部分 run 出現。 |
label_first_metrics.tsv |
36 欄,label-first 路線的精簡指標表,用 chr:pos:ref:alt 當鍵。只在 canonical 配對輸出見到。 |
⚠️ 文件與實際不符的一處
.claude/rules/output-structure.md宣稱 region 目錄會有視覺化*.png,但本輪在實際輸出目錄中找不到任何 PNG。圖是由 Python 層另外畫的(見 Analysis and Presentation),不是 C++ 產生的。
以下指令本輪全部實際執行過,exit code 皆為 0。路徑都是磁碟上真實存在的檔案。
先從 VCF 抽出單一個突變,只給三個必填參數:
# 準備一個只含單一突變的 VCF
SP=/tmp/ism_demo && mkdir -p $SP
V=/big7_disk/liaoyoyo2001/InterSubMod/data/vcf/HCC1395/pileup/filtered_snv_tp.vcf
grep '^#' $V > $SP/one_snv.vcf
grep -P '^chr19\t29283968\t' $V >> $SP/one_snv.vcf

# 跑
/big7_disk/liaoyoyo2001/InterSubMod/build/bin/inter_sub_mod \
  --tumor-bam  /big7_disk/liaoyoyo2001/InterSubMod/data/bam/HCC1395/tumor.bam \
  --reference  /big7_disk/liaoyoyo2001/InterSubMod/data/ref/hg38.fa \
  --vcf        $SP/one_snv.vcf \
--output-dir $SP/out_min預期輸出(實跑結果):
Total regions: 1 / Successful: 1 / Failed: 0
Total reads processed: 85
Forward strand (+): 40 / Reverse strand (-): 45
Total CpG sites found: 11
Metric: NHD / Total valid read pairs: 3443 / Total invalid pairs: 127
/big7_disk/liaoyoyo2001/InterSubMod/build/bin/inter_sub_mod \
  --tumor-bam  /big7_disk/liaoyoyo2001/InterSubMod/data/bam/HCC1395/tumor.bam \
  --reference  /big7_disk/liaoyoyo2001/InterSubMod/data/ref/hg38.fa \
  --vcf        $SP/one_snv.vcf \
  --output-dir $SP/out_typical \
  --window-size 1000 \
  --threads 8 \
  --distance-metric BERNOULLI \
  --distance-metric NHD \
  --min-common-coverage 3 \
  --nan-distance-strategy SKIP \
  --log-level info
Configuration 區塊會印 Threads: 8 與 Distance Metrics: BERNOULLI, NHD,每個 region 目錄下會同時出現 distance/BERNOULLI/ 與 distance/NHD/ 兩個子目錄。
⚠️ 要跑全基因組時把
--vcf換成完整的filtered_snv_tp.vcf.gz即可 —— 但那會產生數萬個 region,屬於長時間計算,請用背景執行並先確認磁碟餘量。(本輪只以單一突變驗證同樣的參數組合可以跑通,未實跑全量。)
/big7_disk/liaoyoyo2001/InterSubMod/build/bin/inter_sub_mod \
  --tumor-bam  /big7_disk/liaoyoyo2001/InterSubMod/data/bam/HCC1395/tumor.bam \
  --normal-bam /big7_disk/liaoyoyo2001/InterSubMod/data/bam/HCC1395/normal.bam \
  --reference  /big7_disk/liaoyoyo2001/InterSubMod/data/ref/hg38.fa \
  --vcf        $SP/one_snv.vcf \
  --loh-bed    /big7_disk/liaoyoyo2001/longphase-to-mod/output/baseline/tumor_phased_LOH.bed \
  --output-dir $SP/out_full \
  --window-size 1000 --threads 8 \
  --distance-metric BERNOULLI --distance-metric NHD
怎麼確認它真的用到了 normal 與 LOH(實跑結果):
Loaded 1094 LOH regions from BED file
Total reads processed: 110        <- 85 腫瘤 + 25 正常(不給 normal 時只有 85)

# significance_summary.csv 中:
NTumorReads=85 · NNormalReads=25 · NormalBaseline_Mean=0.0890 · SampleASM_Delta=-0.010062
這節整理「不會報錯、但結果是錯的」那類問題。每一條都有原始碼或實測依據。
| 嚴重 | 問題 | 會怎麼咬你 |
|---|---|---|
| 🔴 | 甲基化與 read 靠隱含列序綁定 |
methylation.csv 首欄是列號不是 read 名,唯一的綁定在程式內部。任何過濾或重排不同步 → 甲基化配到別條 read 的單倍型,無任何 assert 會抓到。 |
| 🔴 | significance_summary.csv 跨 run 欄數不一致 |
實測 59/114/117/157/180 五種,原始碼 193,且無版本欄位。用固定欄號解析的腳本會靜默錯位。一律用欄名讀。 |
| 二值化門檻有三套 | 主線 0.8/0.2 三分法、另一模組硬寫死 0.5 二分法、Python 端 128/255。同一個 CpG 因為走哪條路而甲基化判定不同,跨模組數字不可比。 | |
linkage_matrix.csv 其實是 TSV |
副檔名與分隔符不符。pandas.read_csv 預設逗號 → 整列變單欄,不會報錯。 |
|
--threads 預設是 16 不是 1 |
help 寫 Default: 1,實際 Config.hpp 是 16。資源估算差 16 倍,在共用機器上平行跑多個 job 時會嚴重超載。 |
|
--distance-metric 宣告值會被清掉 |
Config 宣告 BERNOULLI,但參數解析會無條件清空再填 NHD。不明講就是 NHD。 | |
| ℹ️ 低 | 群數最少一定是 2 | 輪廓係數從 k=2 開始掃,所以 optimal_k 永遠不會是 1 —— 它不回答「有沒有結構」。要看有沒有結構請看 PERMANOVA 與 gating 欄位。 |
| ℹ️ 低 | --help 回傳 exit code 1 |
help 與參數錯誤共用同一條 return 路徑。CI smoke test 會誤判失敗。 |
| ℹ️ 低 | 三個設定是死的 |
min_site_coverage/pmd_gating/pmd_bed_path 在 Config.hpp 以外零引用。不可在方法學章節宣稱本方法有 PMD gating 或最小位點覆蓋度過濾。
|
- ← 回系統全景
- 下一頁:LongLineage 部件 →
- 深入:ISM 方法本體(既有頁)—
InterSubMod/docs/explain/02_ism-core.standalone.html - 深入:甲基化讀取與篩選(既有頁)—
InterSubMod/docs/explain/03_methylation-read-filter.standalone.html
-
CLI 選項:
--help實跑輸出,逐行對照include/utils/ArgParser.hpp與include/core/Config.hpp。兩個「文件 vs 程式碼」落差均以原始碼行號 + 執行期輸出雙重確認。 - 三條範例指令:全部實際執行,exit code 皆 0,輸出檔案逐一讀回核對。
- 輸出檔格式:所有 header 與資料行皆為實際 head 磁碟檔案所得,非照文件抄寫。
- 內部流程:20 個階段逐一標註原始碼位置,本輪機械重驗行號有效性 100% 通過。
- 全基因組全量跑法未實跑(屬長時間計算),僅以單一突變驗證相同參數組合可跑通。
- 約 10 個較少用的旗標(如
--full-read、--germline-hp-only、--no-filter等)其執行期副作用未逐一實跑驗證;其存在、型別與預設值已由--help與原始碼確認。 -
reads/filtered_reads.tsv的實際檔案在本輪查的 4 個 region 目錄中都不存在(需開啟對應旗標且確實有 read 被濾掉才會寫出),其 header 取自原始碼字面。
來源:InterSubMod/docs/explain/12_intersubmod-io.standalone.html · 分支 research/subclonal-reconstruction-202606 · 建立於 2026-08-06