Repository navigation
Upstream and Data
← Home · System Overview · InterSubMod · LongLineage · Upstream · Analysis · How to Run
兩支 C++ 的輸入是怎麼來的?
ISM 與 LongLineage 都不是從原始訊號開始的 —— 它們吃的是已經被四個外部工具處理過的資料。這一層不是本專案寫的程式,但它決定了所有下游分析的品質上限,而且藏著幾個會讓人得出相反結論的陷阱。
| 輸入 | 產生者 | 它回答什麼 |
|---|---|---|
甲基化訊號MM/ML tag |
Dorado basecaller | 這條 read 上每個 CpG 有沒有甲基化、機率多高。資料進來時就已經在 BAM 裡了。 |
|
體細胞突變清單 VCF |
ClairS(配對模式) | 哪些位置是腫瘤才有、正常組織沒有的突變。 |
單倍型標籤HP/PS
|
LongPhase-S | 這條 read 來自父源還是母源那一套染色體。存成 sidecar 檔案,不存回 BAM。 |
|
拷貝數 CN 區段 |
SAVANA(僅 cna) | 哪些區段被複製或缺失。NOT_INTEGRATED,尚未接入主線。
|
| 指標 | 數值 |
|---|---|
| ✅ 樣本 sidecar 全部生產完成 | 7 / 7 |
| 7 樣本 sidecar 總量(壓縮後) | 5.83 GiB |
| 1.67 TiB | |
| sidecar 方案節省的倍數 | 287× |
從原始訊號到兩支 C++ 吃得下的東西。步驟 ① 通常在資料交付時就已完成。
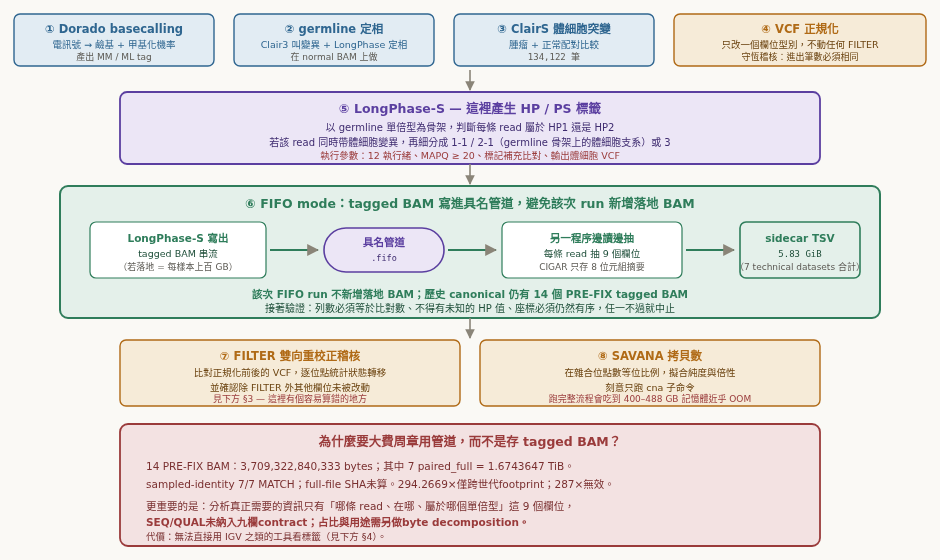
圖 1 · 上游前處理鏈,以及為什麼 tagged BAM 從不落地
這個設計是本系統最值得學習的工程決定之一 —— 它把「我需要什麼資訊」與「這些資訊被裝在什麼容器裡」分開來想,結果用 1/287 的空間保留了 100% 需要的內容。
| 步驟 | 做什麼 | 細節 |
|---|---|---|
| ① Dorado basecalling | 電訊號 → 鹼基 + 甲基化機率 | 產出 MM / ML tag |
| ② germline 定相 | Clair3 叫變異 + LongPhase 定相 | 在 normal BAM 上做 |
| ③ ClairS 體細胞突變 | 腫瘤 + 正常配對比較 |
134,122 筆 |
| ④ VCF 正規化 | 只改一個欄位型別,不動任何 FILTER | 守恆稽核:進出筆數必須相同 |
⑤ LongPhase-S — 這裡產生 HP / PS 標籤
|
以 germline 單倍型為骨架,判斷每條 read 屬於 HP1 還是 HP2;若該 read 同時帶體細胞變異,再細分成 1-1 / 2-1(germline 骨架上的體細胞支系)或 3
|
🔴 執行參數:12 執行緒、MAPQ ≥ 20、標記補充比對、輸出體細胞 VCF |
| ⑥ 關鍵設計:tagged BAM 寫進「具名管道」,從不寫到磁碟 | 見下方展開 | ✅ |
| ⑦ FILTER 雙向重校正稽核 | 比對正規化前後的 VCF,逐位點統計狀態轉移;並確認除 FILTER 外其他欄位未被改動 | |
| ⑧ SAVANA 拷貝數 | 在雜合位點數等位比例,擬合純度與倍性;刻意只跑 cna 子命令 |
🔴 跑完整流程會吃到 400–488 GB 記憶體近乎 OOM |
LongPhase-S 寫出                具名管道          另一程序邊讀邊抽              sidecar TSV
tagged BAM 串流       ───►       .fifo      ───►  每條 read 抽 9 個欄位   ───►   5.83 GiB
(若落地 = 每樣本上百 GB)                        CIGAR 只存 8 位元組摘要        (7 樣本合計)
- 跑完後工作目錄裡只剩一個空的管道檔 —— BAM 本體一個位元組都沒留在磁碟上。
- 接著驗證:列數必須等於比對數、不得有未知的
HP值、座標必須仍然有序,任一不過就中止。
- 7 個樣本的 tagged BAM 合計約 1.67 TiB,含餘裕需準備約 2.3 TB 空間。
- 而 sidecar 只有 5.83 GiB(壓縮後)/13.98 GiB(未壓縮)—— 相差約 287 倍。
- 更重要的是:分析真正需要的資訊只有「哪條 read、在哪、屬於哪個單倍型」這 9 個欄位,序列與品質字串佔了 99% 以上的體積卻完全用不到。
⚠️ 代價:無法直接用 IGV 之類的工具看標籤(見下方 §04)。
這是唯一被兩支 C++ 程式的原始碼寫死成相同格式的檔案。
#CHROM START0 END0 QNAME FLAG MAPQ CIGAR_B2 HP PS
| 欄位 | 內容 |
|---|---|
QNAME |
read 的原始名稱,實測是明文 UUID(如 ec1d98d5-5fcf-45fc-9691-7641e8731385)。 |
CIGAR_B2 |
比對形狀的 8 位元組摘要(不是完整 CIGAR)。省空間,但仍足以當比對用的鍵。 |
HP |
單倍型標籤。值域:1/2(germline)、1-1/2-1(帶體細胞變異的支系)、3、.(未定相)。 |
PS |
定相組編號 —— 同一組內的單倍型標籤才可互相比較。 |
| 資料集 | sidecar 列數 | 備註 |
|---|---|---|
| HCC1395 | 40,859,727 |
主力樣本,1.43 GB(壓縮後) |
| HCC1395_DORADO | 40,033,094 |
同一個生物樣本的另一次 basecalling,不是生物學重複 |
| COLO829 | 8,255,461 |
有外部真值可對照 |
| H1437 | 14,434,968 |
純度 0.95 |
| H2009 | 21,690,297 |
純度 0.95 |
| HCC1937 · HCC1954 | — |
HCC1937 的 BAM 是最大的(416 GiB) |
✅ 7/7 PASS — 全部生產完成並通過驗證(2026-07-11 起跑,隔日 01:31 全部驗證通過)。7 個生產資料集 = 6 個生物樣本(HCC1395 有兩套 basecalling)。
LongPhase-S 不只把「原本不合格」的位點救回來,也會把原本合格的降級。如果誤以為重校正只是「加分」,就會把重校正後的合格集當成原本合格集的超集 —— 那是錯的。
HCC1395 實測:救回 4,592 個、降級 5,528 個 → 淨變化 −936(113,997 → 113,061)。 用錯集合,骨幹突變數就會對不上。七個樣本的救回/降級數各不相同。
同樣叫 HP 的欄位:LongPhase-S 寫的是字串(HP:Z:1-1),另一個工具寫的是整數(HP:i:11),而且整數編碼是 11↔"1-1"、21↔"2-1"、33↔"3" 這種非直覺的映射。
用錯 parser 不會報錯 —— 只會讓所有「帶體細胞變異的支系」read 消失在分組之外,看起來就像**「這個樣本沒有亞群訊號」**。這是最容易得出相反結論的一個坑。
這兩個標籤的定義本身就是用體細胞變異切出來的 —— 它們是「在 germline 骨架上再被體細胞證據細分出來的 read 群」。
因此拿它去「驗證」體細胞變異的分群,就是循環論證。ISM 甚至內建一個開關,專門把這些標籤降級成「未定相」來避免這個循環。
正確用法:HP 是鑑別器(幫忙排除「其實只是來自不同那套染色體」的假象),不是確認器。
另外兩個較次要但值得知道的限制
這是被問最多的需求之一,答案有點反直覺。
現況
🔴 兩支 C++ 程式都沒有寫 BAM 的能力(寫入 API 在整個 repo 出現 0 次,所有開檔都是唯讀模式)。現存的 tagged BAM 全部由外部工具 LongPhase-S 產生。而 LongLineage 更在架構層明文禁止輸出 BAM —— 這是寫進格式規範裡的硬性限制,不是可調參數。
✅ 好消息是技術上完全可行,因為比對用的鍵是確定性的正向計算:
- sidecar 裡的
QNAME是明文的 UUID - LongLineage 的
read_id是它的 SHA-256 雜湊 - 所以讀 BAM 時對每條 read 名重算一次雜湊就能對上,不需要任何反查表
可行的做法是寫一個獨立的匯出工具(讀凍結結果 + 原始 BAM,重算雜湊做比對),放在正式流程之外。這不違反上述任何限制,因為它不是流程本身的產物。
🔴 ● 但要先解決磁碟問題:目前該磁碟只剩約 617 GB,而全量 tagged BAM 需要 1.67 TiB。實務上建議只針對感興趣的區間產生子集。
- sidecar 格式:實際 zcat 取得表頭與資料行,與 LongLineage 原始碼中的常數逐位元組比對一致。
- 7 樣本狀態:實際讀取生產狀態表,7/7 皆為 PASS。
- FILTER 轉移數:取自稽核 JSON,並驗算 4,592 − 5,528 = −936 與前後總數相符。
- 磁碟數字:實際檔案位元組數加總。
⚠️ 步驟 ① basecalling 不是本專案執行的,資料進來時已完成,本頁描述取自資料集的來源記錄。⚠️ SAVANA 的拷貝數結果目前狀態為NOT_INTEGRATED—— 尚未接入主線分析,因此所有現有結論都是「未經拷貝數校正」的。
來源:InterSubMod/docs/explain/14_upstream-data.standalone.html · 分支 research/subclonal-reconstruction-202606 · 建立於 2026-08-06