Repository navigation
System Overview
← Home · System Overview · InterSubMod · LongLineage · Upstream · Analysis · How to Run
這套系統由哪些部件組成,各自做什麼? 本頁回答四個問題:目標是什麼、有哪些部件、每個部件吃什麼吐什麼、現在哪些真的能跑。 每個部件的細節在各自分冊頁,本頁只給地圖與狀態。
受眾:指導教授 + 實驗室同學(第一次接觸這套系統的人)
這套系統要解決的問題是:一顆腫瘤裡混著好幾群帶不同突變的細胞,我們想知道哪個突變先發生、哪些突變住在同一群細胞裡。
傳統做法用短讀長測序,只能看到每個位點各自的變異頻率,再回頭猜組合 —— 這在數學上被證明是無解的(non-identifiable 反卷積)。本系統改用 ONT 長讀長:一條 DNA 分子動輒數萬鹼基,可以同時跨過好幾個突變位點,於是「這兩個突變在不在同一群細胞裡」從「用頻率推論」變成直接看得到的觀測。
系統由 兩支 C++ 主程式(InterSubMod、LongLineage)+ 一層上游工具鏈 + 一層 Python 分析與 HTML 呈現組成。其中只有一部分現在真的跑得動 —— 下面的狀態表會誠實標出來。
✅ 本系統最值得注意的設計 它在機器欄位的層級把「技術跑通」和「科學可用」分開:canonical 輸出裡
technical_all_pass = true但validation_evidence_eligible = false。 程式全過、雜湊全對、265 個測試全綠 —— 但系統自己宣告這批結果還不能當作驗證證據。 這種「不確定就明講不確定」的紀律,貫穿整份設計。
由下而上共五層。方框顏色 = 現在的可用狀態:✅ 可跑 ·
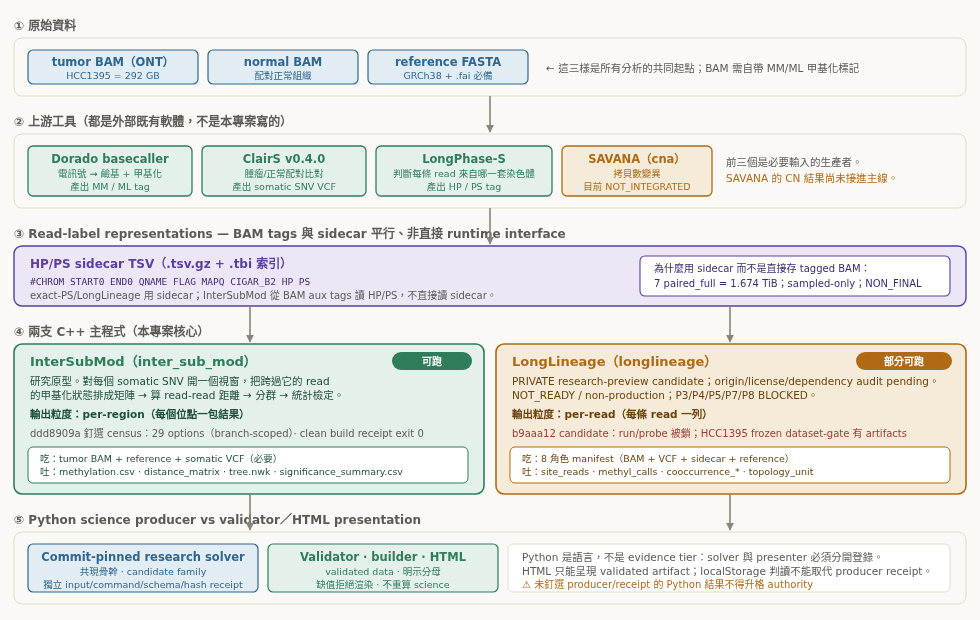
圖 1 · 五層全景與資料流
怎麼讀這張圖: 由下往上是資料流方向。第 ③ 層的 sidecar TSV 是全系統的樞紐 —— 它是唯一被兩支 C++ 程式的原始碼寫死成相同格式的檔案,也是把「一條 read 屬於哪個單倍型」這件事持久化的地方。
數字出處: 292 GB tumor BAM 與 40,859,727 列 sidecar 皆為實測檔案大小與行數;1.67 TiB 為 7 個 tagged BAM 的位元組加總。
| 部件 | 說明 |
|---|---|
tumor BAM(ONT) |
HCC1395 = 292 GB |
normal BAM |
配對正常組織 |
reference FASTA |
GRCh38 + .fai 必備 |
← 這三樣是所有分析的共同起點;BAM 需自帶 MM/ML 甲基化標記。
| 工具 | 狀態 | 做什麼 | 產出 |
|---|---|---|---|
| Dorado basecaller | ✅ | 電訊號 → 鹼基 + 甲基化 |
MM / ML tag |
| ClairS v0.4.0 | ✅ | 腫瘤/正常配對比對 | somatic SNV VCF |
| LongPhase-S | ✅ | 判斷每條 read 來自哪一套染色體 |
HP / PS tag |
| SAVANA(cna) | 拷貝數變異 | 目前 NOT_INTEGRATED
|
前三個是必要輸入的生產者。
HP/PS sidecar TSV(.tsv.gz + .tbi 索引)
#CHROM START0 END0 QNAME FLAG MAPQ CIGAR_B2 HP PS
每條 read 一列,記錄它落在哪、屬於哪個單倍型。HCC1395 這一份有 40,859,727 列、1.43 GB。
為什麼用 sidecar 而不是直接存 tagged BAM:7 個樣本的 tagged BAM 合計 1.67 TiB,磁碟放不下。
InterSubMod(inter_sub_mod) ✅ 可跑 |
LongLineage(longlineage) |
|
|---|---|---|
| 定位 | 研究原型。對每個 somatic SNV 開一個視窗,把跨過它的 read 的甲基化狀態排成矩陣 → 算 read-read 距離 → 分群 → 統計檢定。 | 工業化重寫版(clean-room,不是 fork)。強制 fail-closed:每個輸出都有 schema 與 SHA-256 收據,證據不足就拒絕出結果。 |
| 輸出粒度 | per-region(每個位點一包結果) | per-read(每條 read 一列) |
| 現況 | 29 個 CLI 選項 · 最小指令 2.9 秒跑完 · exit 0 | 🔴 run / probe 子命令被鎖 · 只有 dataset-gate 能出科學結果 |
| 吃 | tumor BAM + reference + somatic VCF(必要) | 8 角色 manifest(BAM + VCF + sidecar + reference) |
| 吐 |
methylation.csv · distance_matrix · tree.nwk · significance_summary.csv
|
site_reads · methyl_calls · cooccurrence_* · topology_unit
|
| 部件 | 說明 |
|---|---|
| Python 分析腳本 | 共現骨幹建構 · 分層樹枚舉 · funnel 普查 · 熱圖繪製 |
| standalone HTML 工作站 | 離線可開 · 逐項人工判讀 · 缺必填值就拒絕渲染 |
這層是「人真正看的東西」。C++ 只吐檔案,Python 把它變成可以用眼睛檢查的圖與表,並把人工判讀結果存回 localStorage 匯出。
最容易誤會的一點:LongLineage 不是 InterSubMod 的新版本,也不是它的分支。
| InterSubMod(ISM) | LongLineage(LL) | |
|---|---|---|
| 定位 | 研究原型:C++ 核心 + 大量 Python 探索腳本 | 工業化重寫:truth-isolated、fail-closed |
| git 起源 | 71ce312e |
7a8f75e8 — 完全不同的根 commit
|
| 血緣 | — |
clean-room 重建,不是 fork。靠 ORIGIN.md 的 21 條對照與 17 條 authority 把 ISM 的某個 commit 釘死當規格 |
| 輸出粒度 | per-region(每個 SNV 位點一包) | per-read(每條 read 一列) |
| 單倍型來源 | 直接從 BAM 的 aux tag 讀 | 明文禁止讀 BAM tag,只認 sidecar TSV |
| 對「甲基化能不能參與重建」的立場 | 🔴 絕不參與 — 只做事後關聯描述 |
🔴 兩系統的科學立場直接衝突 ISM 的既有結論是「甲基化絕不進入重建的 likelihood」,因為會產生循環論證(見下方 §04)。 但 LL 現行程式碼把「甲基化有沒有分出群」當成拓撲單元的前置關卡。 後果:在 LL 裡,甲基化沒分出群的位點永遠不會有拓撲解 —— 這是一個選擇性偏誤來源。 任何跨系統的比較都必須明講這點,否則會得出與 ISM 既有結論矛盾的敘述。
這張表是本頁最實用的部分。所有狀態都是本輪實際執行過或讀原始碼確認的結果,不是文件宣稱。
| 部件 | 狀態 | 實測依據與限制 |
|---|---|---|
inter_sub_modISM 主程式 |
✅ 可跑 | 最小指令實跑 2.9 秒完成、exit 0;含 normal BAM + LOH BED 的完整版本也 exit 0。 |
longlineage preflight |
✅ 可跑 | 驗證 8 個角色的 manifest 完整性。 |
longlineage dataset-gate |
唯一能產出科學結果的路徑,已在真實 HCC1395 資料上完整跑完並產出 8 個 artifact。 🔴 但 樣本名稱硬寫死在原始碼裡 —— 換一個樣本就會失敗,必須改 C++ 重新編譯。 |
|
longlineage run / probe |
🔴 被鎖 | 即使所有閘門都通過,仍被無條件擋下(KernelBlocked, exit 6)。關鍵區辨:這不是「程式沒寫」 —— M1/M2/topology 的核心都已實作,也被 dataset-gate 實際執行過。被鎖的原因是對照驗證(parity)的證據還不存在。 |
longlineage 的 topology 產出 |
🔴 目前為 0 | HCC1395 全 autosome 唯一一次完整跑的結果:79,687 個位點 → 通過甲基化關卡的只剩 5 個 → 最終拓撲單元 0 個。 134,278 個配對中有 134,276 個被標記為不合格。repo 自己的決策紀錄也承認這點。 |
longlineage-query / export-legacy |
🔴 未實作 | 仍是 fail-closed 的空殼。 |
|
ISM 的分層樹枚舉 solver Python + C++ |
✅ 可跑 | 這才是目前實際產出論文核心數字的路徑,7 個樣本全跑完(見下方 §05 的 funnel)。 |
| 7 個樣本的 sidecar 資料 | ✅ 齊全 | 實測 run_status.tsv 顯示 7/7 全部 PASS,可立即使用。 |
| 輸出帶標籤的 BAM | 🔴 做不到 | 兩支程式都沒有寫 BAM 的能力(寫入 API 在整個 repo 出現 0 次)。現存的 tagged BAM 全部是外部工具 LongPhase-S 產生的。LL 更在架構層明文禁止輸出 BAM。 |
| 兩支程式串起來跑 | 🔴 無 | 沒有任何腳本同時執行兩個 binary(雙向搜尋皆無命中)。目前是兩條各自獨立的線。 |
🔴 給教授看的三句重點
- 能跑的那條線,是 InterSubMod + 它的 Python 分層 solver,不是 LongLineage 主線。論文核心數字出自前者。
- LongLineage 被鎖的原因是「證據不足」不是「程式沒寫」 —— 這是它刻意的 fail-closed 設計,不是 bug。
- 沒有一條打通兩支程式的路。零件很齊、契約很嚴,但接縫還沒建。
這是整套方法論最核心、也最常被外部讀者質疑的設計決定,值得單獨解釋。
直覺上會想:既然甲基化模式在不同細胞群之間有差異,那用甲基化把 read 分群,不就能找出亞群了嗎? 不行 —— 因為會產生循環論證。
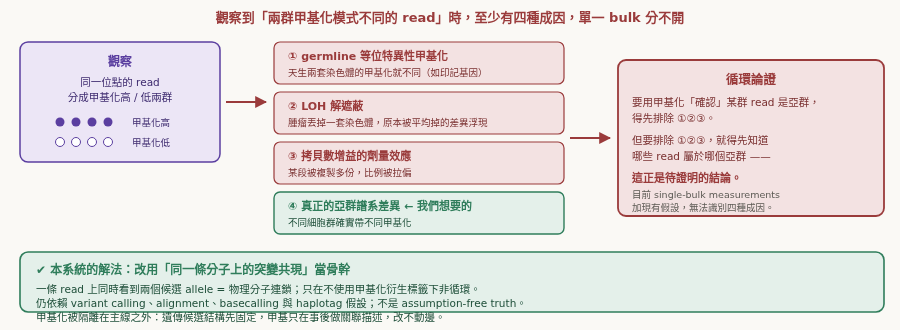
圖 2 · cis-ASM 循環:為什麼「用甲基化確認亞群」證明不了東西
這個設計的代價與收穫: 代價是甲基化這個資訊量很大的軸被降級成輔助;收穫是重建結果不會被審稿人以循環論證擊倒。 實際數字上,甲基化輔助層共 1,045 個正式單元、811 個可評估、最終只有 3 個(0.37%)達到穩健關聯 —— 這也印證了把它當骨幹會很危險。
觀察:同一位點的 read 分成甲基化高 / 低兩群。
| # | 成因 | 說明 |
|---|---|---|
| ① | germline 等位特異性甲基化 | 天生兩套染色體的甲基化就不同(如印記基因) |
| ② | LOH 解遮蔽 | 腫瘤丟掉一套染色體,原本被平均掉的差異浮現 |
| ③ | 拷貝數增益的劑量效應 | 某段被複製多份,比例被拉偏 |
| ④ | 真正的亞群譜系差異 ← 我們想要的 | 不同細胞群確實帶不同甲基化 |
🔴 循環論證:要用甲基化「確認」某群 read 是亞群,得先排除 ①②③。但要排除 ①②③,就得先知道哪些 read 屬於哪個亞群 —— 這正是待證明的結論。 單一 bulk 樣本無法打破這個循環。
✔ 本系統的解法:改用「同一條分子上的突變共現」當骨幹 一條 read 上同時看到兩個突變 = 物理上的分子連鎖,不依賴任何「待推論的標籤」,因此非循環。 甲基化被結構性地隔離在主線之外:樹先由遺傳證據定好,甲基化只在事後做關聯描述,改不動任何一條邊。
這是目前的 canonical 結果(2026-08-01 凍結,7 個樣本、chr1–22)。每一層的數字都能在 denominator_registry.tsv 或 all7_summary.json 裡查到。
| 指標 | 數值 |
|---|---|
| sSNV 資料列(全 7 樣本) | 469,849 |
| 單點無共現,無法建樹 | |
| 有拓撲解且可排序的單元 | ✅ 71,955 |
| confirmed 細胞亞群 | 🔴 0 |
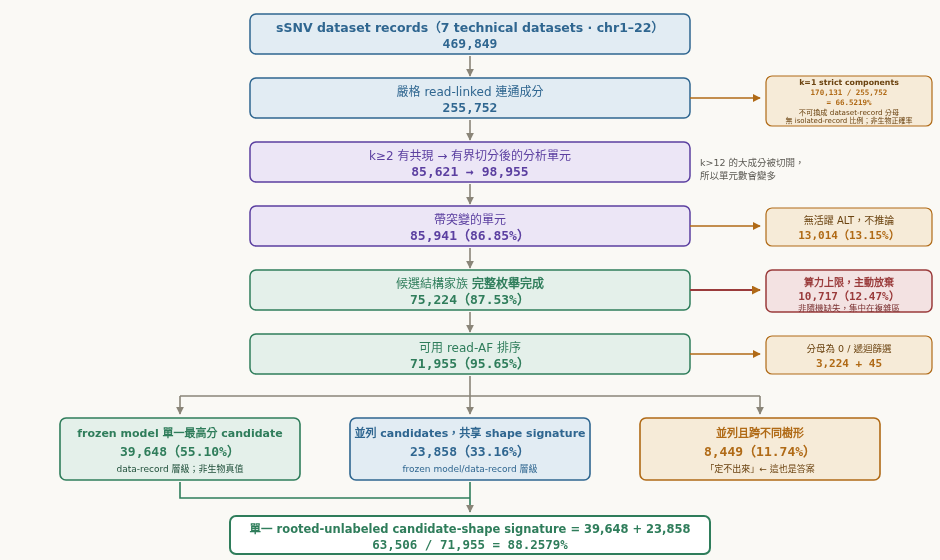
圖 3 · 從 469,849 個突變到 63,506 個單一拓撲:每一層流失到哪裡去了
算術自洽性已驗證: 39,648 + 23,858 = 63,506;+ 8,449 = 71,955;+ 3,224 + 45 = 75,224;+ 10,717 = 85,941;+ 13,014 = 98,955。每一層加總都對得起來。
🔴 最常被誤引的數字就是那個 88.26%。 它的正確讀法是:「在已經可排序的 71,955 個單元中,有 88.26% 收斂到單一樹形」—— 這是 model-conditional 的圖形統計,不是「腫瘤裡 88% 的演化關係已經解出來了」。分母不是全部突變,前面已經流失了 66.5% 的單點與 12.47% 的算力放棄。
| 層 | 內容 | 數值 | 該層流失 |
|---|---|---|---|
| L1 | sSNV 資料列(7 樣本 · chr1–22) | 469,849 | — |
| L2 | 嚴格 read-linked 連通成分 | 255,752 | |
| L3 | k≥2 有共現 → 有界切分後的分析單元 | 85,621 → 98,955 | k>12 的大成分被切開,所以單元數會變多 |
| L4 | 帶突變的單元 | 85,941(86.85%) | |
| L5 | 候選樹家族完整枚舉完成 | 75,224(87.53%) | 🔴 算力上限,主動放棄:10,717(12.47%) 非隨機缺失,集中在複雜區 |
| L6 | 可用 read-AF 排序 | 71,955(95.65%) |
| 分支 | 數值 | 說明 |
|---|---|---|
| ✅ 唯一最佳樹 | 39,648(55.10%) | AF 算術上唯一勝出 |
| 並列,但樹形相同 | 23,858(33.16%) | 拓撲確定,只是標籤可換 |
| 8,449(11.74%) | 「定不出來」← 這也是答案 |
單一 rooted-unlabeled 拓撲 = 39,648 + 23,858 → 63,506 / 71,955 = 88.26%
🔴 排序器同時也是篩選器 — 一個容易被忽略的細節 read-AF 不只用來「排序」候選樹,它在同分的候選集合裡取最大值並丟掉其餘,因此它實際上也改變了候選集合本身(實測丟棄 30.03%)。 後果:純 parsimony(不靠 AF)的單一拓撲率只能說是一個區間,不能報單一數字。
⚠️ 本輪查證發現:該區間的上界 88.26% 有 registry 佐證,但下界 64.89% 在本 repo 內未 grep 到原始出處,僅存在於工作記憶索引 —— 對外引用前必須先補上出處。
這節直接取自 authority_manifest.json 的 claim_boundary 欄位 —— 是機器可讀的宣稱邊界,不是散文。
- 嚴格 read-linked 的局部區域結構
- 家族完整時,完整的最小 read-相容突變狀態候選家族
- 允許遞迴的 Hamming-1 父子樹候選
- 未經 CN/LOH 校正的 deterministic read-AF 排序
- 全域 AF-best 數學樹的 exact rooted-unlabeled 拓撲普查
- pattern-conditioned 的區域甲基化關聯(非因果)
- confirmed 細胞層級的 clone / subclone
- CN/LOH 校正過的 CCF
- 校準過的 likelihood 或 posterior
- 把 read cluster 當成 cell clone
- 用甲基化差異重排拓撲
- 把 HCC1395 與其 DORADO 重跑當成生物學重複
| 方向 | 為什麼不行 |
|---|---|
| 對整棵樹做機率排序 | 候選樹在 likelihood 下等機率,posterior 只會吐 P=1/N。換成連續 posterior「只是換個記法,變不出 reads 裡不存在的資訊」。 |
| 用甲基化排序拓撲 | 三個理由全否:cis 構造對稱、四配子最常見成因是拷貝數多重性而非二次突變、等機率區沒有遺傳真值可校驗(等於拿甲基驗甲基)。 |
| 甲基化非監督分群確認亞群 | 單一位點的四種成因不可拆(見 §04),屬已判 NEGATIVE 的 tumor-only double-dip。 |
| 甲基化當變異 TP/FP 過濾器 | DEAD,「方向已窮盡,勿再開」。 |
| 用舊的 50 kb 鄰近取代嚴格 read linkage | 幾何鄰近不等於同分子連鎖。已被 read-linked 方法取代。 |
證據等級的天花板 單一 bulk 樣本只能做 characterize(描述),不能做 confirm(確認),因此封頂 ★3。 要突破需要 single-cell 或 multi-region 資料。 這不是能力不足,而是資訊論上的界限 —— Steiner 節點會被誠實標成
inferred。
依你的目的挑一頁進去。
| 分冊 | 狀態 | 一句話 | 吃 → 吐 |
|---|---|---|---|
| ISM 部件與輸入輸出 | ✅ 可跑 | 主程式的 29 個選項、內部 8 個處理階段、每個輸出檔的真實欄位與範例行。 | tumor BAM + reference + somatic VCF → methylation.csv · distance_matrix · tree.nwk
|
| LongLineage 部件與契約 | 4 個子命令的真實狀態、M1→M2→topology 科學鏈、artifact schema 與 read_id 的算法。 |
8 角色 manifest → site_reads · cooccurrence_* · topology_unit
|
|
| 上游工具鏈與資料 | ✅ 齊全 | sSNV / HP-PS / 甲基化 / CN 各自從哪個工具來、7 個樣本的實體資料在哪。 | Dorado · ClairS · LongPhase-S · SAVANA · sidecar TSV |
| Python 分析層與 HTML 呈現層 | 主力腳本各自做什麼、工作站 HTML 怎麼生成、這層目前的碎片化問題。 | 分析腳本 → workstation spec → standalone HTML | |
| 怎麼跑 — 操作手冊 | 可複製指令 | 從編譯到跑出第一個結果的完整步驟,每條指令都已實際執行驗證過。 | build → 最小跑法 → 完整跑法 → 看結果 |
| 科學方法細節 | 既有頁面 | 名詞定義、ISM 方法本體、甲基化讀取與篩選、chr2:18M 真實案例逐步拆解。 | 解釋中心第 01–10 頁 |
本頁所有數字、狀態、檔案格式,來自 2026-08-06 對兩個 repo 的一次系統性實測收集(9 個維度並行,每個維度獨立收集後再做對抗式驗證)。
- 驗證覆蓋:334 個「檔案:行號」宣稱 + 111 個路徑宣稱,全部經機械重驗 —— 0 個捏造、0 個行號越界;28 個初判找不到者,經修正路徑寫法後 100% 定位到實體檔案。
- 可跑狀態:所有標示「可跑」的部件,均為本輪實際執行並檢查 exit code 的結果。
-
科學數字:funnel 各層取自
denominator_registry.tsv與all7_summary.json(2026-08-01 凍結的 canonical 輸出),並已驗證各層加總自洽。
- 「純 parsimony 單一拓撲率」的下界 64.89% 在 repo 內未找到原始出處,對外引用前需補齊;上界 88.26% 有 registry 佐證。
- LongLineage 7 樣本的總執行時間與記憶體上界無實測證據,且其文件明文禁止由單樣本外推。
- 拷貝數(CN/LOH)目前狀態為
NOT_INTEGRATED,尚未接入主線。
來源:InterSubMod/docs/explain/11_system-map-overview.standalone.html · 分支 research/subclonal-reconstruction-202606 · 建立於 2026-08-06