Repository navigation
LongLineage Engine
← Home · System Overview · InterSubMod · LongLineage · Upstream · Analysis · How to Run
部件分冊 · 第 13 頁 · LongLineage LongLineage:契約很嚴、程式都在,但目前輸出 0 棵樹
這是同一套科學想法的工業化重寫版。它的設計品質很高(每個輸出都有 schema 與 SHA-256 收據),但目前主線被鎖住,而且在真實資料上的拓撲產出是 0。本頁解釋為什麼是 0 —— 這不是 bug,理解原因比理解程式碼更重要。
LongLineage 把 ONT 資料算成「哪些體細胞突變共同出現在同一條 read 上」的證據表,再用最少隱藏節點的超立方體解出這些突變之間的譜系關係。
它與 InterSubMod 的根本差異:ISM 輸出是 per-region(每個位點一包結果),LL 輸出是 per-read(每條 read 一列);ISM 從 BAM 直接讀單倍型標籤,LL 明文禁止讀 BAM tag,只認 sidecar 檔案。
| 指標 | 數值 | 意義 |
|---|---|---|
| 輸入的體細胞突變位點 | 79,687 | 凍結的體細胞突變位點(chr1–22) |
| 通過甲基化關卡 | 12,851 | 只佔全部的 16.1% |
| 通過第二道關卡 | 5 | — |
| 最終拓撲單元 | 0 | — |
下表的狀態都是本輪實跑取得 exit code 或讀原始碼確認的。
| 子命令 | 狀態 | 實測依據 |
|---|---|---|
preflight |
✅ 可跑 | 驗證 8 個角色的 manifest 完整性。 |
dataset-gate |
唯一能真的算出科學結果的入口,已在真實 HCC1395 資料上完整跑完,產出 8 個 artifact。 | |
run |
🔴 被鎖 | 回 KernelBlocked(exit 6)。實測 message="release attestation is NOT_READY"。 |
probe |
🔴 被鎖 | 同上。且其輸出依設計「永遠是 PARTIAL,不能成為驗證證據」。 |
🔴 一個很容易踩的誤解 很多人會想:「把
release_attestation.json改成 READY 就能跑正式流程了吧?」 不行。 就算通過 attestation 這道閘門,控制流走到函式最後一段,仍會對run與probe無條件回傳 KernelBlocked。正式入口與科學核心之間根本沒有接線。
ℹ️ 但請注意這個關鍵區辨 「BLOCKED」指的是「對照驗證的證據不存在」,不是「程式碼沒寫」。 M1/M2/topology 的計算核心都已經實作完成,而且被
dataset-gate實際執行過。這是刻意的 fail-closed 設計 —— 在證明結果與參考實作一致之前,拒絕讓任何人拿它當正式結論。 (目前 4 條 blocker:M1 對照未驗證、M2 共現對照未驗證、拓撲對照未驗證、拓撲排序未驗證。)
longlineage-query、longlineage-export-legacy、longlineage-evaluate 這三支是真的空殼 —— 不是「跑不動」而是「沒寫」。證據:它們在建置設定裡根本沒有連結科學程式庫,二進位檔裡不存在任何讀取或轉換資料的程式碼。就算給它一個完美的凍結 run,也只會回 not implemented。
🔴 另外 longlineage-query 只接受狀態為 VALIDATED_FROZEN 的 run,但 HCC1395 那個 run 的狀態是 VALIDATED_FROZEN_DATASET_GATE —— 實測回 exit 8 拒絕。要讀資料目前只能自己 zcat。
這是本頁最重要的一節。答案不在程式效能或資料量,而在科學設計的一個前提。
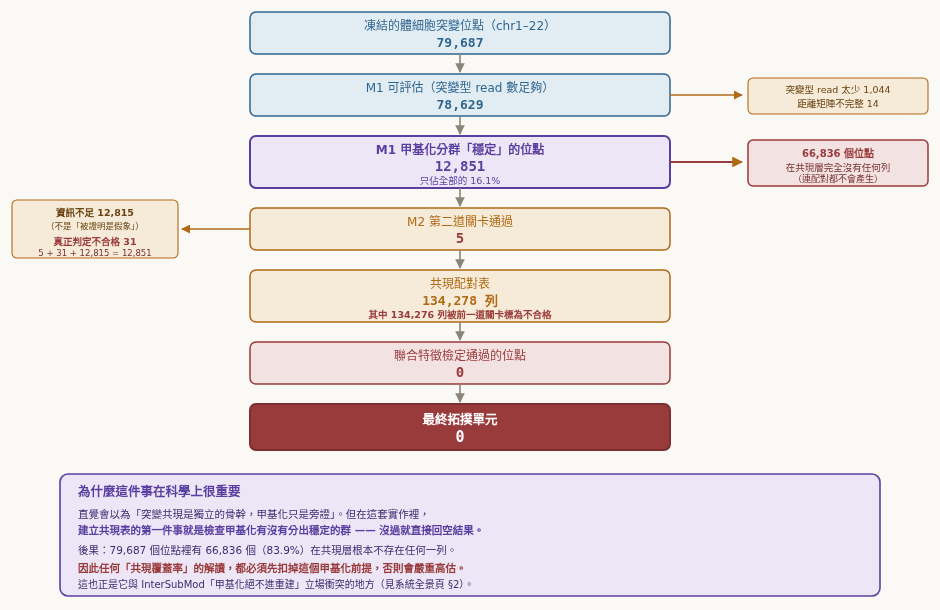
圖 1 · HCC1395 全 autosome 唯一一次完整跑:79,687 個位點如何流失到 0
數字已驗算:5 + 31 + 12,815 = 12,851,與 M1 穩定位點數完全相符。
🔴 一個極易誤讀的統計:M2 沒通過的最大宗是 12,815 個「資訊不足以判斷」(佔 99.7%),這不是「99.7% 的甲基化分群都被證明是技術假象」。前者是「測不出來」,後者是「測出來是假的」—— 真正被判定為確實不合格的只有 31 個。在報告裡把這兩者混為一談,會得出完全相反的結論。
| 層 | 數值 | 被擋掉的部分 |
|---|---|---|
| 凍結的體細胞突變位點(chr1–22) | 79,687 | — |
| M1 可評估(突變型 read 數足夠) | 78,629 | 突變型 read 太少 1,044;距離矩陣不完整 14 |
| M1 甲基化分群「穩定」的位點 | 12,851(只佔全部的 16.1%) | 66,836 個位點在共現層完全沒有任何列(連配對都不會產生) |
| M2 第二道關卡通過 | 5 | 資訊不足 12,815(不是「被證明是假象」);真正判定不合格 31 —— 5 + 31 + 12,815 = 12,851 |
| 共現配對表 | 134,278 列 | 其中 134,276 列被前一道關卡標為不合格 |
| 聯合特徵檢定通過的位點 | 0 | — |
| 最終拓撲單元 | 0 | — |
直覺會以為「突變共現是獨立的骨幹,甲基化只是旁證」。但在這套實作裡,建立共現表的第一件事就是檢查甲基化有沒有分出穩定的群 —— 沒過就直接回空結果。
後果:79,687 個位點裡有 66,836 個(83.9%)在共現層根本不存在任何一列。
🔴 因此任何「共現覆蓋率」的解讀,都必須先扣掉這個甲基化前提,否則會嚴重高估。
這也正是它與 InterSubMod「甲基化絕不進重建」立場衝突的地方(見系統全景頁 §2)。
🔴 「LongLineage 能算出樹」目前沒有 run 層級的實證 現存三個完整科學 run 的拓撲輸出檔都是 28 bytes(僅檔案結尾標記,零筆資料)。如果直接拿 LL 當「已經算出亞群樹」的證據,會落空。 真正跑出區域樹的是另一條 descriptive-only 的相容路徑,但該路徑的規格文件明文禁止它宣稱 clone/祖先/時序/正式拓撲發現。
即使拓撲是 0,前面幾層的 artifact 都有實體資料,而且格式被 schema 鎖死、每個檔都有 SHA-256 收據。這些資料是可以拿來用的。
| artifact | 欄數 | 實測列數 | 回答什麼問題 |
|---|---|---|---|
site_reads |
23 | 7,578,727 (620 MB) |
每條 read 在每個位點的觀測:read 識別碼、單倍型、定相組、以及該 read 在此位點是正常型/突變型/其他/未覆蓋。不受甲基化關卡影響 —— 每個位點都無條件寫出,所以它是最完整、最可用的一份。 |
methyl_calls |
17 | 261,130,339 (4.56 GB) |
每條 read 每個 CpG 的甲基化判讀。 |
m1_sites |
30 | 79,687 | 每個位點的甲基化分群結果與穩定性判定。 |
m1_assignments |
— | 78,629 | 哪些 read 被分到哪一群。注意:這是甲基化的群,不是亞群譜系標籤。 |
cooccurrence_pairs |
74 | 134,278 | 兩個位點在同一條 read 上的共現統計。 |
cooccurrence_sites |
24 | 79,687 | 每個位點的共現彙總。 |
topology_units |
34 必填鍵 |
0 (28 bytes) |
本來要放拓撲解的地方。目前是空的。 |
一個設計上的亮點值得學習
topology_unit的 schema 把「解到什麼程度」拆成四個獨立狀態欄位(用哪條求解路徑/目標函數狀態/候選家族狀態/排序狀態),並且每種放棄都有具名的理由。這讓「沒解出來」不會被誤讀成「解出來是空的」—— 值得在自己的輸出格式裡沿用。
read_id 是怎麼算的 — 想把結果對回 BAM 時必看
read_id 是 SHA-256 雜湊,設計上是不可逆的(schema 的型別名稱就叫 opaque_sha256)。
🔴 但它不是 SHA-256(原始 QNAME),而是 SHA-256(投影後的 QNAME):當 FLAG 顯示這是配對定序時,會先依 READ1/READ2 補上 /1 或 /2 再做雜湊。
ONT 是單端資料通常沒差別,但如果你想拿 read_id 回去 BAM 對回原始 read,直接 sha256(QNAME) 在配對資料上會對不上。
好消息:因為是確定性的正向計算,讀 BAM 時對每條 QNAME 重算一次雜湊就能 join,不需要任何反查表。
這些會讓你「以為程式壞了」或「得到假結論」。
| 嚴重 | 陷阱 | 說明 |
|---|---|---|
| 🔴 | dataset-gate 硬編碼只認 HCC1395 |
不只樣本名稱要字面相符,連 VCF 記錄數都必須剛好是 113,061/79,687/33,374,授權識別碼也要完全一致。想拿 COLO829 或 H1437 跑是不可能的,會直接被拒。換樣本必須改 C++ 重新編譯。 |
| 🔴 | repo 裡有 17 個 build 目錄,拿錯就得到假結論 | 各目錄的執行檔來自不同 commit。實測其中一個跑整合測試會 FAIL(回報 schema 識別碼不符),另一個跑就 PASS。隨手挑一個 build 目錄,很容易把「執行檔過期」誤判成「程式壞掉」。 |
| 🔴 | 從 tarball 編出來的版本直接拒跑 | 編譯時若沒有 .git(下載 tarball 或 CI 淺複製),內嵌的 commit 會是 40 個 0,dataset-gate 第一件事就是檢查這個並拒絕執行。 |
| 🔴 | 契約檔已經和凍結的 run 漂移 | 拿今天 repo 的 schema 去驗 2026-07-20 的 run 會不通過(catalog 與參數檔的 SHA 都已不同)。而且 summary 的 schema 有版本斷層:catalog 指向 2.0.0,真實 run 產出的是 1.0.0。照新版 schema 描述欄位,會描述到檔案裡根本沒有的東西。 |
| sidecar 表頭必須一個位元組都不差 | 第一行必須逐位元組相符,而且必須是 BGZF 壓縮(不是普通 gzip)。實測連 repo 自己的測試 fixture 拿去跑 preflight 都會被打回。 | |
| schema 列了但程式不會產出的狀態值 | schema 列舉了四種求解路徑,但程式只會產出三種;另有兩個狀態值在整個原始碼裡搜不到。照 schema 寫方法學章節,會多寫出實際不存在的分支。 |
🔴 最重要的語意警告:一條 read 對應到哪個節點,沒有唯一解 至少六種情況會讓一條 read 同時相容於多個候選節點(部分覆蓋的 read、並列的候選集合、父節點映射並列……)。這是模型本身的性質,不是 bug,程式從頭到尾都刻意不做硬指派。
任何下游把「這條 read 屬於哪個亞群」當成確定值來統計,都是把「放棄判定」讀成了「已判定」。 輸出格式必須用狀態列舉來表達這件事,不可強制給唯一標籤 —— 否則就是 overclaim。
- 子命令狀態:實跑取 exit code,並讀原始碼確認 fail-closed 的判斷位置。
- funnel 數字:取自 2026-07-20 的完整科學運算與對照報告 JSON,並已驗算 5 + 31 + 12,815 = 12,851 自洽。
- artifact 列數與大小:實際讀取 run 的摘要檔與檔案位元組數。
- 三個相關單元測試本輪實跑,全部 PASS。
- 本頁所有 funnel 數字僅來自 HCC1395 這一個樣本。LongLineage 的文件明文禁止由單樣本外推到其他樣本。
- 7 樣本的總執行時間與記憶體上界無任何實測證據;最大樣本(BAM 為 HCC1395 的 1.62 倍)完全沒有跑過。
- 本輪在磁碟上找不到部分 artifact 的實體檔案(以搜尋確認),相關列數取自 run 的摘要檔而非直接讀檔。
來源頁:InterSubMod/docs/explain/13_longlineage-io.standalone.html · 分支 research/subclonal-reconstruction-202606 · 建立於 2026-08-06