Repository navigation
Pipeline Behavior
対象読者:管理者・上級者・開発者 目的:講義動画から英語字幕(SRT)が出来るまでの処理を、設定を判断できる粒度で説明する。 各処理には「📎 コード参照」としてソースコードの位置を添える(いずれも リポジトリ の
mainブランチ)。設定を変えたいときは 上級設定リファレンス と往復して読むこと。
名前の表記について:本文には2種類の名前が出てきます。
- 「何を変えると効くか」を示す表(§5.3 の違反コード表、末尾の早見表)では、設定画面の表示名を「かぎ括弧」で示します。例:「最大CPS(文字/秒)」。設定画面でこの名前を探せば変更できます。
- 本文中の
splitJaModelのようなコード体裁の名前は内部名です。これには「設定キー」(enMaxCps等=管理者が変えられる)と「処理名」(translateEn・correctionEngine等=パイプラインの段の呼び名で、設定ではない)の両方があります。設定キーの「表示名 ↔ 内部キー ↔ 既定値」の対応は 上級設定リファレンス が正本です。本文で内部キーを見かけたら、そこで設定画面の表示名を引けます。
字幕生成が通常の文章生成と決定的に違うのは、具体的な文章量そのものが品質に直結することです。1行の文字数、行数、表示時間あたりの文字数(CPS: Characters Per Second)には「視聴者が読み切れる」ための上限があり、Netflix のガイドラインをはじめ、最適な値・比率はベストプラクティスとして研究・確立されています。つまり字幕では「良い訳文」であっても、定められた文字量・時間枠に収まらなければ品質要件を満たしません。
一方、今日のLLMは正確な文字数のカウントを苦手としています。トークン単位で文章を生成する仕組み上、「この時間枠なら何文字まで」という空間的・時間的な文字数の把握も不正確で、「○文字以内で」と指示しても守られる保証がありません。この問題への対処は様々なアプローチが考案されていますが、本パイプラインではそもそもLLMに文字数をカウントさせること自体をやめるという設計を選びました。
LLMに文字数を数えさせない。 短く/長く/自然に、という「方向」だけLLMに任せ、CPS・行長・行数・表示時間といった「形の制限」の判定とリトライ制御は、ルールベースの決定的なコードが行う。
LLMの出力が制限を超えていれば、コードがそれを検出し、リトライさせ、最良の結果を採用し、最終的に解決できなければ違反フラグを立てて人間のレビューへ回します。そのため処理は次の2系統が交互に現れます。
- LLMノード:翻訳・補正・短縮・展開・分割など、意味を作る/変える処理。失敗してもパイプラインは止めず、「原文をそのまま使う」「違反フラグを付けて人間レビューに回す」といった代替手段で次へ進む。
- 決定的ノード:CPS違反検査・整形・再配分・タイミング詰め・カバレッジ検証など、コードだけで動く処理(LLM不要)。
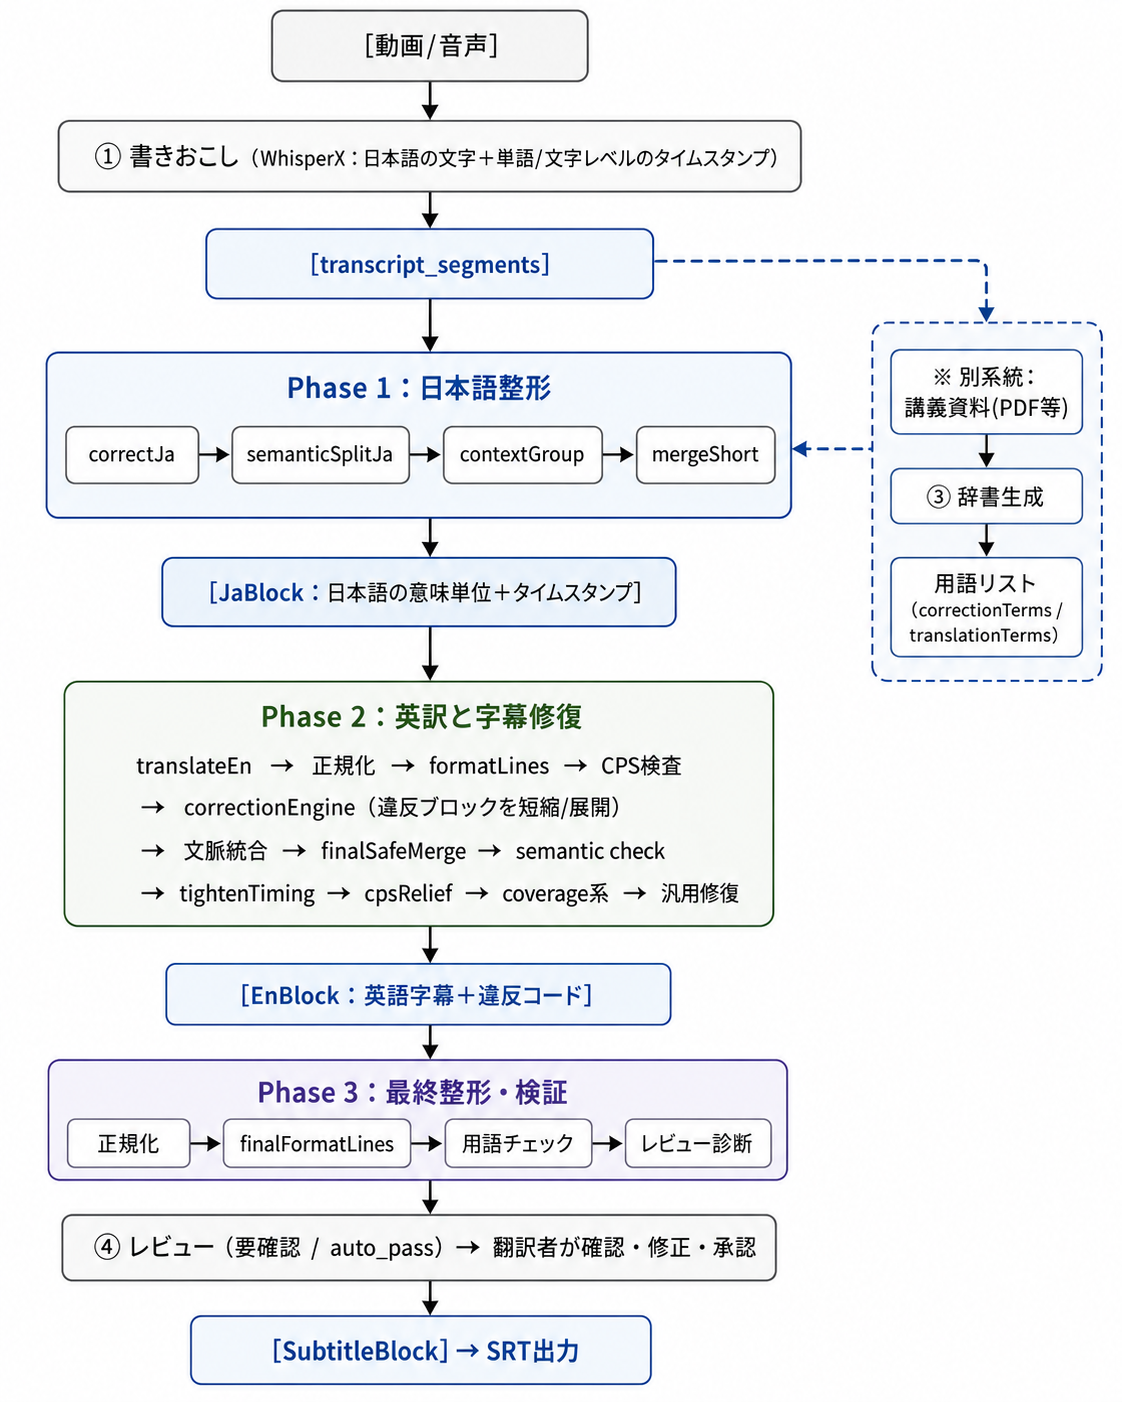
図の各工程(書きおこし → Phase 1〜3 → レビュー → SRT出力)は以降の §2〜§7 で順に説明します。右上の別系統(講義資料からの辞書生成)は §3 を参照してください。
実行の入口は runLocalPostPipeline() で、Phase1→2→3 を順に呼びます。各ノードの実行は、実行記録(trace)と各段階の中間結果(スナップショット)として保存され、成功/失敗・所要時間・出力が監査レポート(PipelineAuditReport)に残ります。失敗調査のときはこれが「字幕生成」タブの処理ログとして見えるものです。
字幕ブロックのテキストフィールドは、subtitle=字幕(SRTに出力される本文)、transcript=書きおこし(元音声のテキスト。翻訳の入力・参照) の2つです。データモデルは言語固有でなくこの役割(ロール)ベースで設計されており、UI表示もラベル定数 SUBTITLE_FIELD_LABELS(字幕/書きおこし)を経由します。
言語について:本書は既定構成(書きおこし=日本語、字幕=英語)を前提に説明します。図や節名の「日本語整形」「英訳」は既定構成での呼び名です。他の言語構成にする方法と現状の制約は 上級設定リファレンスの「言語構成(多言語対応)」 を参照してください。
📎 コード参照
frontend/src/lib/pipeline/localPipeline.tsのrunLocalPostPipeline()・runNode()。frontend/src/types/subtitle.tsのSubtitleBlock・SUBTITLE_FIELD_LABELS。
🔧 この段で詰まったら:書きおこしが失敗する・接続できない → チューニング:接続・実行のトラブル
動画/音声から 日本語テキスト+タイムスタンプ を作ります。WhisperX は通常の音声認識に加えて、単語・文字レベルのタイムスタンプ(アライメント)を返すのが特徴で、これが後段の「日本語を意味単位に切ってもタイムスタンプを保てる」基盤になります。
書きおこしノードの動作:
- 音声ファイルから WhisperX を実行して書きおこします(通常運用ではこれが唯一の経路です)。
- WhisperX のバックエンドは2種類:
-
docker:
jim60105/docker-whisperXをdocker run --gpus allで実行。既定イメージghcr.io/jim60105/whisperx:large-v3-ja。--output_format json+--return_char_alignmentsで文字レベルのタイムスタンプを取得し、VADはsilero。 - embedded:同一プロセス内でWhisperXを直接実行。
-
docker:
- 主要パラメータは環境変数で制御:
WHISPERX_MODEL(既定large-v3),WHISPERX_LANGUAGE(既定ja),WHISPERX_BATCH_SIZE(既定 8),WHISPERX_COMPUTE_TYPE(既定float16),WHISPERX_DEVICE(既定cuda)。 - WhisperX が失敗した場合、その実行はエラーで終了し、字幕生成タブにエラーが表示されます(書きおこしが取れていないまま後段の翻訳へ進むことはありません)。
出力1件は { id, start, end, text, ja, words[] }。words[] には各単語の start/end/score が入り、アライメント失敗した単語は除外されます。
書きおこし・パイプラインを このPCで動かすか・リモート(AWS)で動かすか はバックエンド側の話です。本ドキュメントでは深入りせず、次を参照してください。
- AWS実行(構築手順・アーキテクチャ・コスト):AWS バックエンド設定マニュアル
- ローカルDocker実行:ローカルWhisperXセットアップ
実行先の選択は設定の serviceMode(このPC=legacy_pipeline / リモート=managed_service)と serviceUrl で決まります(→ 上級設定リファレンス)。
📎 コード参照:
backend/pipeline/nodes/transcribe.pyのTranscribeNode.run()・_run_docker_whisperx()・_parse_whisperx_json()。
講義資料(PDF・CSV・XLSX)から 専門用語の対応リスト を作り、パイプラインに渡します。用語は2系統に分かれます。
- correctionTerms:日本語補正(correctJa)に渡す。ASRが聞き間違えた専門用語を正しい表記へ直すために使う。
-
translationTerms:英訳(translateEn)に渡す。日本語用語→公式英語表記を固定するために使う(プロンプトに
PROJECT GLOSSARYとして注入)。
PDF辞書生成は、テキスト抽出に加えてページ画像を使ったVision抽出を選べます。
-
pdfExtractionUseVision:ページ画像をVisionモデルに渡して用語抽出する(数式・図中文字に強い)。 -
pdfExtractionParallel:ページ並列で抽出を高速化する。 -
pdfExtractionVisionModel:Vision抽出に使うモデル(既定 nano クラス)。 -
pdfFormulaMiniModel:数式/画像文字の追加確認モデル。 -
glossaryMaxOutputTokens:辞書生成の出力トークン上限。
これらは辞書タブ側のUIで扱うのが自然な設定です(→ 上級設定リファレンス)。
📎 コード参照
- 用語の受け渡しは
localPipeline.tsのLocalPipelineGlossary→ correctJa はcorrect.ts、translateEn はtranslateEn.ts(PROJECT GLOSSARY)。frontend/src/lib/glossary/documentGlossaryGenerator.ts,frontend/src/lib/glossary/pdfExtractor.ts。
WhisperXの生テキストを、字幕に載せられる日本語の意味単位(JaBlock) に整えます。まだ翻訳はしません。
実行順:correctJa → semanticSplitJa → contextGroupCueBlocks → mergeShort。
🔧 この段の出力で困ったら:字幕が細切れ/長すぎる・文の途中で切れて英訳があふれる → チューニング:字幕の分割・結合
ASR由来の誤りを直し、字幕に出せる日本語へ整えます。
- フィラー語除去(「えー」「あの」等)、専門用語の誤認識修正(correctionTerms使用)、口語→書き言葉、同音異義語・変換ミスの修正。
- 意味・情報量は変えない(要約・追加は禁止)。入力と出力のセグメント数は必ず一致させる。
- バッチ単位でLLMに送り、失敗したらバッチを半分に分割して再試行。単一セグメントまで分割しても失敗したら最大2回リトライし、それでも駄目なら原文をそのまま返す(止めない)。
- 補正で文章がどれだけ書き換わったかを編集距離(Levenshtein距離=何文字分の挿入・削除・置換があったか)で測り、しきい値
qualityCorrectionThreshold(既定 0.15)を超えたブロックには「大きく変えた」目印(correctionFlagged)が付く。デバッグ・レビューの材料になる。
設定との対応:補正の方向性は correctionAdditionalInstructions(追加指示)と correctionFewShotJson(手本例)で調整できる。モデルは correctionModel。
校正済み日本語を、字幕キューに向く意味のまとまりへ分割します。ここでも翻訳・タイムスタンプ生成はしません。
- LLMは「意味単位の区切り」だけを返す(単語1語だけ・フィラーだけの断片は避ける、専門語・カタカナは割らない、という指示)。
-
タイムスタンプはコードが付ける:WhisperXの単語タイムスタンプと意味単位を文字列マッチで対応付け(
exact)、合わなければ文字数比例で按分(proportional)、単語情報が無ければ区間按分(no_words)。proportional/no_wordsは後段で「タイミング不確実」として扱われる。 - 長すぎる単位(
mergedLongDurationSec超)は、専門語・カタカナ・英数字を割らない安全な位置で再分割。 - LLMの分割結果が元の文章を取りこぼしていないかをコードが検査する(分割結果と原文の共通部分=LCSを比べ、原文の9割をカバーしていなければ取りこぼしと判定)。取りこぼしがあった場合、そのセグメントは分割せず原文1単位のままにする。
設定との対応:分割モデルは splitJaModel(既定 nano)。長さ上限は pipelineMergedLongDurationSec。
表示キューは結合しませんが、「文脈上ひとまとまりで扱うべきキュー」にグループのタグを付けます。これにより後段の翻訳が前後の意味を踏まえられます。
この前処理に 未完結文の結合(mergeContinuation)が含まれます。semanticSplitJa が「〜が」「〜の」「〜まで」のような継続助詞で途中で切れたブロックを作ると、後段の翻訳が隣の内容を取り込んで英文があふれCPS違反になりがちです。これを未然に防ぐため、未完結末尾を持つブロックを次と結合します。
設定との対応(→ 上級設定リファレンス):
-
pipelineMergeContinuationEnabled:この結合のON/OFF。 -
pipelineMergeContinuationMaxGapSec/MaxDurationSec/MaxTranscriptChars:結合してよい条件(間隔・結合後の長さ・日本語文字数の上限)。 -
incompleteEndDetectionModel/incompleteEndDetectionBatchSize:未完結末尾を判定するモデル(空欄ならsplitJaModel)とバッチサイズ。
短すぎるブロックを隣と結合し、文脈グループのインデックスを振り直します。短さの判定は pipelineShortDurationSec。
📎 コード参照
frontend/src/lib/pipeline/phase1.ts。frontend/src/lib/pipeline/correct.tsのcorrectSegments()(SYSTEM_PROMPT・バッチ分割フォールバック含む)。frontend/src/lib/pipeline/semanticSplitJa.tsのsemanticSplitJa()(被覆率判定・アライメント含む)。frontend/src/lib/pipeline/mergeContinuation.ts,frontend/src/lib/pipeline/contextGrouping.ts。
Phase 2 が最も長い工程です。英訳した上で、字幕として成立する形(CPS・行長・行数・表示時間・原文カバレッジ)に収まるまで、決定的処理とLLM修復を段階的にかけます。
JaBlock を英語字幕へ翻訳します。
- 出力のランダム性を最小にする設定(温度0)で実行し、訳し方の手本(few-shot例
translationFewShotJson)・追加指示(translationAdditionalInstructions)・用語リスト(translationTerms)をあわせて与える。 - 文脈グループの配分翻訳:未完結末尾でグループ化された複数ブロックは、グループ全体をまず訳し、その意味を各ブロックへ「配分」する(同じ主語・定義を全ブロックに繰り返さない)。
- バッチ翻訳が件数不一致等で失敗したら半分に分割して再試行。
-
未翻訳検出:出力が原文と同じ、または日本語が35%以上残っている場合は「翻訳されていない」とみなし、そのブロックだけ最大2回まで翻訳をやり直す。ただし、AI側が翻訳を拒否して返してきた場合(APIがコンテンツポリシーによるブロック=
content_filter、または回答拒否=refusalを返した場合)は、何度試しても結果が変わらないためやり直しせず、すぐに「未翻訳」として人間レビューに回す。 - 最終的に訳せなかったブロックがあってもパイプラインは止めない。字幕本文に
[UNTRANSLATED: 理由]+原文をそのまま書き込み、「未翻訳」の違反フラグを付けて次の工程へ流す。このフラグはエディタの要確認バッジにつながるので、人間のレビューで確実に見つけられる。
設定との対応:モデルは translationModel。プロンプト内の言語名(翻訳元・翻訳先)は言語構成から組み立てられます(→ 言語構成)。
-
テキスト正規化(
textNormalizationEnabled/textNormalizationRulesJson):表記ゆれ等をルールで整える。修復前に一度かける。 - formatLines:行折り返しを行い、行長・行数の形を作る。
- checkCpsViolations:各ブロックの違反コードを判定(後述の分類)。
各ブロックは決定的に1つの違反コードへ分類されます。判定は上から順で、最初に当たったものが採用されます。「違反コード」は字幕生成タブの処理ログ・診断に出る内部コードです。「効く設定(設定画面の項目)」を調整すると、各判定の基準が変わります。
| 順 | 違反コード | どういうときに付くか | 効く設定(設定画面の項目) |
|---|---|---|---|
| 1 | proportional_ts |
タイムスタンプを正確に取れず、文字数比で按分した(タイミングが不確実) | 設定では変えられない(書きおこしのアライメント結果に依存) |
| 2 | short_duration |
表示時間が短すぎる | 「短い字幕を結合するしきい値(秒)」 |
| 3 | merged_long |
結合された字幕の表示時間が長すぎる | 「結合後の字幕の最長表示時間(秒)」 |
| 4 | long_segment |
表示時間が長すぎる | 「長い字幕を分割するしきい値(秒)」 |
| 5 | over_compressed |
訳が短く詰め込みすぎで、情報が落ちている疑い(字幕が原文に比べ短い・読む速さも遅い・元の日本語は十分長い、が同時に成立) | 「過圧縮と判定する英日文字比(下限)」「低速発話と判定するCPS(下限)」「過圧縮判定の最小日本語文字数」 |
| 6 | verbose_en |
訳が長すぎる、または読む速さ(CPS)が速すぎる | 「冗長と判定する英日文字比(上限)」「最大CPS(文字/秒)」 |
| 7 | line_length_only |
1行が長すぎる | 「1行の最大文字数」(折り返し行数は「最大行数」) |
| 8 | slow_speech |
表示時間に対して文字が少なく間延びしている(読む速さが遅い) | 「低速発話と判定するCPS(下限)」 |
| 9 | ok |
上記いずれにも該当しない(問題なし) | — |
読む速さ(CPS)の上限は「最大CPS(文字/秒)」(既定 16.9)です。この表が「設定値を上げ下げすると何が起きるか」の正本です。各項目の正確な数式・内部キー・既定値・場所は 上級設定リファレンス を参照してください(条件の厳密な不等式は本節末尾の 📎 コード参照 classifyViolation にあります)。
verbose_en / line_length_only / long_segment / merged_long のブロックを対象に、短縮(compress)・展開(expand)・分割を判断して違反解消を試みます。
- 判断ノード(decisionNode)が、各ブロックに対しどの戦略を取るか決め、結果が改善しなければ別戦略へ。
- per-block の試行上限:
pipelineMaxCompressPerBlock(既定5)/pipelineMaxExpandPerBlock(既定3)。 - 使うモデル:短縮
compressModel、軽量短縮microModel、展開expandModel。短縮/展開プロンプトはcompressPromptOverride/expandPromptOverrideで完全上書き可能。
ここから後半は、LLM修復で直しきれない/直すべきでない部分を決定的処理で整えます。
-
mergeContextFragments:文脈依存の短い断片を前後どちらへ統合するか判断(
contextMergeModel)。このノードは言語非依存に作られており、プロンプトへの言語名の注入と「字幕欄に書きおこし言語が紛れ込む」役割反転ガードに、設定の言語ラベル・言語プロファイルJSONを使う(→ 言語構成)。 - finalSafeMerge:安全に結合できるブロックを最終結合(決定的)。
-
semantic check:短縮の前後で文の意味が変わっていないかを、文章を数値ベクトル化して意味の近さを測れる Embedding モデルで計測する。
semanticCheckModeで「オフ/記録だけ取る(log_only)/意味が離れすぎたら短縮を差し戻す(enforce)」を選べる。使うモデルはembeddingModel。オフのときは一切動かない。 -
tightenTiming:隣接キューの隙間が短すぎる場合に、境界を動かさず・最小表示時間を侵さずに詰める(決定的・LLM不要)。最小表示時間は
subtitleMinDurationSec。 - checkCpsAfterTighten → cpsReliefRebalance:タイミング詰めで生じたCPS違反を、隣接ペアの時刻を決定的に再配分して解消(LLM不要)。後段LLM修復の負荷を減らす。
最終的な字幕が元の日本語を十分カバーしているか(話された内容の取りこぼしがないか)を検証し、足りなければ修復します。比較の基準となる補正済み書きおこし(correctedSegments)が手元にある場合のみ動きます(通常のパイプライン実行では常にあります)。
🔧 この段の挙動を調整したい:「要確認」が多い → 要確認の量/コスト・速度が気になる(修復エージェントのON/OFF・effort)→ コストと速度
- coverageValidator:字幕と元の日本語の共通部分を比べ、カバーしきれていない箇所を検出する(コードのみの決定的処理。検出してもパイプラインは止めない)。
- redistributeJaSpan:ブロック境界での取りこぼしを、時間の比率に応じた振り直しで機械的に救済する(やってみて改善しなければ自動で元に戻す)。
-
coverageRepairAgent:それでも残った「意味の欠落」をAIに修復させる。コストを抑えるため軽量モデル(mini級)を、推論の深さ(reasoning effort)を低めにして使う。
coverageRepairEnabledをOFFにするとこの段は実行されず、次段(汎用修復 or 人間の確認)へ進む。モデルはcoverageRepairModel、推論の深さはcoverageRepairEffortで変更可。 -
generalRepairAgent:最後の救済役。形式違反とカバレッジ違反の両方を見て修復を試み、失敗するたびに推論の深さを低→中→高と一段ずつ上げて再挑戦する。改善できた時点で打ち切り、最後まで直せなかったブロックは「人間の確認が必要」(
manual_review)として確定し、エディタの要確認バッジにつながる。generalRepairEnabledをOFFにすると、残った違反は即「人間の確認が必要」扱いになる。モデルはgeneralRepairModel、推論の深さの上限はgeneralRepairMaxEffort。
📎 コード参照
frontend/src/lib/pipeline/phase2.tsのrunPhase2()(本章の各ノードの呼び出し順の正本)。frontend/src/lib/pipeline/translateEn.tsのtranslateEn()(未翻訳判定・文脈グループ配分翻訳含む)。frontend/src/lib/pipeline/metrics.tsのclassifyViolation()。閾値マッピングはlocalPipeline.tsのbuildPipelineThresholds()。frontend/src/lib/pipeline/correctionAgent/loop.ts,correctionAgent/decisionNode.ts。
英語字幕を最終形に整え、レビュー材料を作ります。実行順:正規化 → finalFormatLines → terminologyCheck → レビュー診断 → toSubtitleBlocks。
-
正規化(finalize):
textNormalizationEnabledのとき最終正規化。ルールJSONが不正なら正規化をスキップし「要確認」を1件出す(止めない)。 - finalFormatLines:最終的な行折り返し。
- terminologyCheck:用語辞書の期待表記が字幕に含まれるか検査。欠落は「用語が欠落の可能性」レビュー項目として残す(自動置換はしない)。
- レビュー診断(reviewDiagnostics):各ブロックのレビュー項目を作る。
-
toSubtitleBlocks:内部表現を UI の
SubtitleBlockに変換。
📎 コード参照:
frontend/src/lib/pipeline/phase3.tsのrunPhase3()。
パイプラインは各ブロックにレビュー優先度を付け、集計します。
-
must_review(要確認)/should_review/auto_passの3段階+用語欠落カウント。 - エディタのバッジは「自動補正後も残る決定的な形式違反(+翻訳失敗)」だけを「要確認」として出す方針です。意味の良し悪しのような不確実な推測でバッジを出すと、翻訳者が機械の推測の検証に時間を取られるためです。
- 翻訳者は要確認ブロックを中心に確認・修正し、承認して SRT出力します。
具体的な画面操作は 操作マニュアル を参照。
📎 コード参照:
frontend/src/lib/pipeline/localPipeline.ts(must/should/auto 集計),frontend/src/lib/pipeline/reviewDiagnostics.ts。
すべてのLLM呼び出しは AI Gateway を経由します。これにより、OpenAI / Gemini / ローカルOpenAI互換サーバー(LM Studio・Ollama等)を、同じパイプラインコードのまま切り替えられます。
Gatewayは2つのプロファイルで「接続先の差」と「モデルの差」を吸収します。
-
API Compatibility Profile:APIサーバーの方言。
max_tokens/max_completion_tokensの違い、response_formatの扱い、APIキー要否など。設定apiCompatibilityProfilePreset(auto/openai/lmstudio/ollama/gemini_openai_compatible/user)。 -
Model Profile:モデルごとのふるまいの差。推論(reasoning)の扱い方、出力形式、画像入力(Vision)や意味ベクトル(Embedding)への対応差など。設定
chatTextProfile*/chatVisionProfile*/embeddingProfile*。
これらは普段は auto でよく、OSS互換サーバーで不具合が出たときに調整する診断寄りの設定です。詳細は 上級設定リファレンス と 設定ファイルリファレンス。
並列リクエスト数(apiRequestConcurrency)は全LLMノード共通で、APIのレート制限でエラーが出るときに下げます。
📎 コード参照:
frontend/src/lib/aiGateway/,frontend/src/lib/pipeline/aiProvider.ts。プロファイルはaiGateway/apiCompatibilityProfile.ts/pipeline/modelProfile.ts。
各処理に効く設定は 上級設定リファレンス に設定画面のグループ順でまとめています(表示名・内部キー・既定値の対応もそちら)。代表的な対応:
| 変えたい挙動 | 設定画面の項目 | 効く工程 |
|---|---|---|
| 1行の長さ・行数 | 「1行の最大文字数」「最大行数」 | 5.2-5.3, 6 |
| 読む速さ(CPS) | 「最大CPS(文字/秒)」「低速発話と判定するCPS(下限)」 | 5.3 |
| 長い/短い字幕の分割・結合 | 「長い字幕を分割するしきい値(秒)」「結合後の字幕の最長表示時間(秒)」「短い字幕を結合するしきい値(秒)」 | 4.2-4.4, 5.3 |
| 修復の強さ・コスト | 「カバレッジ修復エージェント」「汎用修復エージェント」の有効化と reasoning effort | 5.6 |
| 翻訳・補正の方向性 | 各「追加指示」「例文JSON(few-shot)」 | 4.1, 5.1 |
| 使うモデル | 「補正モデル」「翻訳モデル」ほかモデル設定 | 各LLMノード |
| 接続先・並列数 | 「実行先」「接続先AIプロバイダ」「並列リクエスト数」 | 全体 |