Repository navigation
FR lab 05
Index des ateliers | English | Infrastructure préalable | Suite : Foundry IQ
Construisez une chaîne de génération augmentée par récupération (RAG) : ingérez des documents, découpez-les en passages, produisez leurs vecteurs, retrouvez les passages pertinents, puis fondez la réponse sur ceux-ci. Prévoyez 90 à 120 minutes une fois l'infrastructure disponible. La recherche et la génération sont deux étapes distinctes ; une réponse plausible ne prouve pas que la recherche a fonctionné.
Important
Une exécution réelle Search Free complète désormais la revue initiale.
Les trois PDF ont été indexés et testés par recherche lexicale, filtres, facettes,
recherche sémantique, contrat vectoriel, hybride et cas négatifs. Les 17 contrôles
d'hôtels ont réussi après suppression du paramètre queryLanguage non pris en
charge par l'API actuelle. Ces vecteurs Free étaient des caractéristiques de ville.
Une exécution payante approuvée a ensuite réussi 14 contrôles sans clé, avec
vrais embeddings de 1 536 dimensions, vectorisation des requêtes par identité
managée et recherche hybride sémantique. Ce premier découpage restait local.
Un autre test privé Search Basic a réussi 25 contrôles : trois PDF originaux,
indexeur Blob privé, neuf projections enfants, embeddings intégrés et recherche
hybride sémantique. Ces exécutions n'ont pas testé la connexion Copilot. Consultez la procédure
privée détaillée, le nettoyage et les résultats réels.
Ces consignes pédagogiques originales ne reproduisent ni le texte ni le code du support protégé. Les trois PDF de démonstration existent localement, mais ne sont pas redistribués. Aucune capture d'écran protégée n'est incluse.
Le nouvel environnement isolé sans clé a indexé les trois documents hôteliers d'origine et réussi une vraie requête avec vectorisation en langage naturel. La connexion Entra Copilot a été bloquée avant authentification par le navigateur hôte ; aucune question connectée exécutée. Les URL sources hôtelières restent aussi indisponibles : leur navigation exige une preuve distincte même après reprise. Voir le registre de connexion.
L'exécution récente du jeu fictif
réussit S5-03, S5-05 et S5-06 avec le texte Harbor/Forest exact ci-dessous.
Les recherches lexicale, vectorielle en langage naturel, hybride et hybride
sémantique placent toutes Harbor en premier. Le filtre du parent ne renvoie que
Harbor; le champ non filtrable produit HTTP 400 identifiant chunk.
Les index jetables des deux essais sont supprimés; les trois schémas d'origine
sont vérifiés inchangés. Aucune route, aucun rôle ni paramètre d'authentification modifié.
Le premier essai charge les deux documents mais s'arrête quand les statistiques restent à zéro. Le deuxième essai explicite vérifie la disponibilité par comptage de recherche réelle, en réutilisant les plongements des mêmes entrées sans les régénérer. Il s'agit d'un chargement direct, pas d'une exécution Blob/indexeur ni d'un agent connecté. Ses sources sont des URN, pas des citations navigables.
L'essai d'ingestion par réseau public
confirme que la stratégie Storage désactive le réseau public. Le RBAC limité
au conteneur ne peut contourner cette frontière : chargement HTTP 403.
Aucune exception de stratégie ni authentification par clé; compte et rôles
temporaires supprimés.
Le chargement privé
utilise un travail à identité managée sans IP publique, un point de terminaison
privé et un DNS privé. Exactement forest.txt et harbor.txt sont relus avec
les mêmes empreintes, ce qui ferme S5-01. La reprise interrompue de l'indexeur
échoue avant sa création. Une course de suppression asynchrone du lien DNS
est conservée; nettoyage ultérieur de la zone possédée et retour aux quatre
ressources initiales vérifiés indépendamment. Ce chargement ne prouve ni S5-02,
ni réponse connectée, ni navigation des citations.
La nouvelle tentative privée à garde distincte exécute bien l'indexeur Blob via un lien privé partagé Search approuvé : deux fichiers traités avec succès, aucun échec ni avertissement. La relecture renvoie HTTP 400 car le champ vectoriel sélectionné n'était pas explicitement récupérable. Cet échec est conservé sans assimiler succès de l'indexeur et acceptation des passages lisibles. Ressources, rôles et liens partagés temporaires supprimés; objets Search et inventaire ARM initiaux vérifiés inchangés.
L'exécution privée avec relecture corrigée rend explicitement le champ vectoriel jetable récupérable. Après récupération d'authentification Azure CLI prise en charge, elle reprend sans redéploiement ni rechargement. L'échec initial de jeton expiré et les erreurs initiales de nettoyage restent dans les preuves privées. Indexation privée réussie : deux fichiers traités, aucun échec ni avertissement. Les deux passages projetés correspondent exactement aux entrées fictives, avec métadonnées parent/source et vecteurs réels de 1 536 dimensions : S5-02 réussit. Infrastructure, rôles et liens partagés jetables supprimés; objets Search, rôles d'identité, liens et inventaire ARM initial de quatre ressources vérifiés inchangés. Réseau public, clés et accès anonyme Storage restent désactivés. À ce point de l'ingestion, cinq critères de connexion, navigation, français et identité refusée ainsi que la certification restaient ouverts.
L'exécution connectée native
rétablit la connexion Entra formelle réelle sans clé ni exception de stratégie.
Le format ai:// documenté échoue au test natif sans sauvegarde de connexion;
un essai HTTPS réel distinct réussit. Un brouillon Standard isolé non publié
associe seulement l'index fictif exact de deux documents, avec un vrai permalien
du corpus publié immuable, pas des URL PDF inventées. Connaissances Ready;
les clones officiels confirment web et connaissances générales désactivés.
Première cohorte figée 3/4 : la question française reçoit une réponse anglaise.
Aucune langue secondaire n'était configurée; l'échec reste conservé.
Après ajout et sélection du français dans le panneau, une cohorte figée
distincte réussit 4/4 : ouverture Harbor 07:00, fermeture Forest 21:00,
abstention explicite sur le prix et réponse française avec citations séparées.
Traces Search natives et passages cités correspondent à la source prévue.
L'abstention cite le vrai document Forest consulté, pas une preuve de prix.
Aucune détection automatique de langue ni réussite fusionnant les configurations.
Huit instantanés officiels restent privés. Celui du vélo a une configuration
vide; les trois autres configurations de reprise concordent et les clones
officiels avant/après confirment les 17 fichiers d'auteur inchangés.
L'erreur Cannot find module '@azure/msal-node-extensions' du validateur reste
ouverte, sans modification de bundle ni validation de schéma YAML prétendue.
Un vrai clic natif ouvre la source fictive publique immuable exacte avec
les deux faits visibles, mais sans fragment de section. Brouillon, connexion
formelle et index temporaires supprimés; objets et empreintes initiaux préservés.
Quatre critères fictifs natifs sont clos, pas la navigation PDF hôtelière originale,
le refus réel d'identité, l'acceptation du corpus original ou le lab complet.
L'observation native contrôlée distincte
pose une seule question de fermeture après retrait Reader confirmé indépendamment,
600,002 secondes avant nouvelle connexion, connexion neuve réelle du connecteur et
contrôle public réussi. Search direct renvoie 403; la source native signale
ConnectorRequestFailure / AzureAISearchClientError, zéro document renvoyé/vérifié
et zéro citation. Sa trace n'expose aucun statut HTTP natif.
Le parent demande génériquement de reformuler, avec un avis supplémentaire
d'absence d'information. Aucun fait source n'est renvoyé dans cette unique réponse.
C'est une référence directe autorisée puis un refus natif dès le premier usage, pas un test natif autorisé puis révoqué apparié, une identité indépendante non privilégiée ou une gestion parent spécifique aux permissions vérifiée. S5-10/T014 restent ouverts. Les résultats antérieurs d'échec et de blocage sont conservés séparément. Configuration officielle inchangée; nettoyage possédé et agents/connexions/schémas/compte/rôles initiaux vérifiés indépendamment, avec navigateur possédé fermé normalement.
Le test isolé de retrait d'autorisation échoue au contrôle S5-10 sans divulgation. Un nouveau service Search sans clé contient seulement les deux documents fictifs. Le même administrateur approuvé reçoit un nouveau rôle Reader limité à cet index; aucun droit de travail initial n'est retiré. Ce n'est pas un test d'utilisateur indépendant non privilégié.
Une question native autorisée renvoie Harbor 07:00 avec sa vraie citation.
Après retrait du seul rôle Reader possédé, les requêtes documentaires directes
renvoient HTTP 403 avec les deux demandes de jeton. Le CLI retourne le même JWT
en cache, pas la preuve d'un jeton nouvellement émis. Dans une conversation
native distincte, l'unique question de la phase refusée renvoie pourtant 07:00
et la citation Harbor. La trace Search officielle contient les deux documents
réels du jeu fictif, sans erreur Search. Le refus direct ne prouve donc pas
l'isolation native. Principal natif effectif et cause restent non établis;
aucune explication par cache, propagation ou privilège n'est affirmée.
La lecture après envoi expire. La reprise exporte cette conversation existante sans rejouer la question. Les deux configurations officielles concordent; le clone indépendant après essai préserve les 17 fichiers d'auteur. Brouillon, connexion, quatre rôles, service/index Search et groupe vérifié vide sont supprimés. Le CLI refuse d'abord une divergence route/filtre d'environnement pour la connexion; une requête de première partie correctement limitée réussit, avec absence vérifiée. Inventaires, compte d'embedding, rôles et trois schémas initiaux sont préservés. Navigateur possédé fermé normalement. Coût réel non finalisé. S5-10, T014 et acceptation complète restent ouverts.
La connexion AccessKey formelle ultérieure a exécuté deux vraies questions sur les hôtels isolés. Qatar correspondait au champ de localisation source ; la question de navette interplanétaire a provoqué une abstention. L'attente de ville a été corrigée en localisation source, sans réécriture du corpus. Les résultats connectés prouvent l'ancrage source, non la navigation vers un PDF hôtelier original.
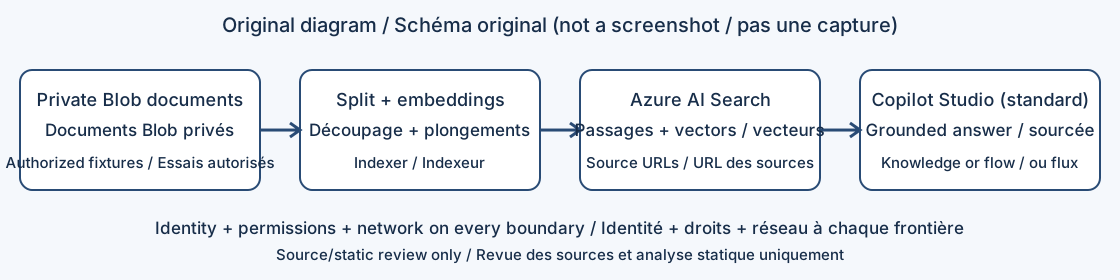
Figure 1. Schéma explicatif nouvellement créé, et non capture d'écran ou preuve d'un système déployé.
Vous devez disposer des éléments suivants :
- Un abonnement Azure autorisé, un groupe de ressources, une région, un budget et un quota de modèle de plongement disponibles
- Azure AI Search, de préférence au niveau Basic ou supérieur pour l'identité managée sortante, et un conteneur Blob privé
- Un déploiement de plongements dont le modèle et les dimensions correspondent à l'indexation et à la vectorisation des requêtes
- Search Service Contributor pour gérer les objets, Search Index Data Contributor pour charger les documents et Search Index Data Reader pour les requêtes, selon les opérations
- Storage Blob Data Contributor pour l'identité qui téléverse ; Storage Blob Data Reader pour l'identité Search qui lit les objets blob
- Un agent Copilot Studio utilisant le harnais standard, l'accès à l'environnement, les licences et les autorisations de connexion ou de flux nécessaires
- L'atelier 5.1 terminé, ou une infrastructure équivalente fournie par un administrateur
Le rôle Contributor sur un groupe de ressources ne donne pas, à lui seul, accès aux documents Search. Les rôles, le réseau et l'authentification sont des contrôles indépendants. Consultez les définitions des rôles Search au lieu de choisir un rôle dont le nom semble proche.
Ouvrez l'expérience des agents standard pour les étapes Rubriques, Connaissances et flux ci-dessous. Le harnais est l'environnement d'exécution ; l'orchestration générative ou classique est un réglage distinct de l'agent standard. Préférez l'orchestration générative pour sélectionner automatiquement un outil ; appelez explicitement un flux depuis une rubrique pour un routage déterministe.
-
Dressez l'inventaire des fichiers autorisés, de leurs titres attendus, de leur langue et des droits de lecture prévus. N'utilisez pas de données de clients réels ni de documents dont la redistribution est interdite.
-
Pour un exercice débutant prévisible, créez deux fichiers texte UTF-8 avec les contenus fictifs originaux ci-dessous. Ces établissements inventés sont des jeux d'essai, pas des recommandations hôtelières.
-
Nommez le premier fichier
harbor.txt:Harbor Training Hotel City: Harbor City The training hotel has a rooftop garden and bicycle storage. The bicycle desk opens at 07:00. -
Nommez le second fichier
forest.txt:Forest Training Lodge City: Pine Town The training lodge has a reading room and indoor pool. The reading room closes at 21:00. -
Dans le portail Azure, ouvrez le compte de stockage autorisé, sélectionnez Conteneurs et créez
training-documentssans accès anonyme. -
Téléversez seulement ces deux fichiers pour le test contrôlé. La liste doit contenir exactement
harbor.txtetforest.txt. Utilisez un autre conteneur pour évaluer ultérieurement les PDF autorisés de l'atelier.
Conservez les mêmes textes anglais dans les deux versions du guide pour comparer les tests multilingues. Deux fichiers d'entrée ne signifient pas exactement deux passages indexés : le nombre dépend du découpage et de l'extraction.
- Ouvrez le service Azure AI Search et lancez l'assistant actuel Import data. D'anciens supports utilisent Import and vectorize data. Choisissez un parcours de vectorisation/RAG, pas une importation limitée aux mots-clés.
- Sélectionnez Azure Blob Storage et le conteneur privé. Préférez l'identité managée du service Search pour lire le stockage. Configurez son identité et ses rôles avant de lancer l'assistant.
- Sélectionnez l'extraction et le découpage du texte. Pour commencer, essayez 1 000 caractères par passage avec un chevauchement de 200 caractères. Notez l'unité réellement choisie : caractères et jetons ne sont pas interchangeables.
- Choisissez un déploiement de plongements autorisé. Vérifiez le nom du modèle, celui du déploiement et le nombre réel de dimensions. Le déploiement examiné utilise
text-embedding-ada-002sur 1 536 dimensions. Un autre modèle convient seulement si l'index, la compétence de plongement et le vectoriseur des requêtes concordent. - Nommez l'index
training-raget notez les noms générés pour la source de données, l'ensemble de compétences et l'indexeur. Ne supposez pas qu'ils reprennent les noms d'un ancien atelier. - Examinez le schéma avant création. Conservez du texte et des métadonnées récupérables, un champ vectoriel interrogeable et une configuration sémantique donnant priorité au titre et au passage.
- Préservez une URL de citation récupérable, telle que
metadata_storage_path, qui pointe vers un document accessible aux utilisateurs autorisés. Un titre n'est pas un lien exploitable et l'URL d'un objet blob privé n'est pas automatiquement accessible à tous. - Créez les objets et lancez l'indexeur. Attendez son état final ; examinez chaque avertissement et erreur au lieu de vous contenter d'un indicateur vert.
- Dans Search explorer, récupérez quelques documents. Vérifiez que le texte et le titre ou l'identité de source sont renseignés, ainsi que le champ vectoriel s'il est récupérable.
Le démarrage rapide du portail actuel constitue le point de départ recommandé. L'assistant peut produire d'autres noms de champs ; les exemples suivants supposent que vous les adaptez à chunk, title et text_vector.
Pour comprendre les objets individuels, suivez la procédure de vectorisation intégrée plutôt que de recopier un ancien schéma JSON.
- Créez la source Blob, puis un index avec une clé
Edm.Stringpar passage, un champparent_idfiltrable, du texte interrogeable et un vecteurCollection(Edm.Single). - Dans l'ensemble de compétences, découpez le contenu et vectorisez chaque passage enfant. Configurez les projections un-à-plusieurs depuis le contexte des passages.
- Projetez texte, vecteurs, titre et métadonnées de citation dans l'index enfant. Laissez les projections gérer l'association parent au lieu de mapper manuellement cette clé.
- Utilisez
projectionModeavecskipIndexingParentDocumentspour un index contenant uniquement des passages. Vérifiez que la projection et l'indexeur ciblent le même index. - Associez l'ensemble de compétences à l'indexeur. Créer seulement une source et un index ne charge ni texte ni vecteurs.
Consultez les projections d'index. Le schéma initial de passages ne fournit pas de métadonnées de citation complètes : ajoutez explicitement l'URL de source aux champs titre, texte et vecteur pour obtenir des citations cliquables.
-
Ouvrez Search explorer en mode JSON. Confirmez l'index sélectionné et utilisez les noms de son schéma réel.
-
Exécutez une recherche lexicale de référence :
{ "search": "rooftop garden", "select": "title,chunk,parent_id", "top": 3, "count": true } -
Exécutez une requête purement vectorielle avec un vectoriseur configuré pour les requêtes :
{ "vectorQueries": [ { "kind": "text", "text": "Where can I store a bicycle?", "fields": "text_vector", "k": 50 } ], "select": "title,chunk,parent_id", "top": 3 } -
Ajoutez
"search": "bicycle storage"à cet objet pour la recherche hybride. Celle-ci fusionne les résultats lexicaux et vectoriels par fusion réciproque des rangs, et non par addition de scores bruts différents. -
Pour tester le reclassement sémantique, ajoutez
"queryType": "semantic"et"semanticConfiguration": "YOUR_CONFIGURATION_NAME"à l'objet hybride. Remplacez ce dernier nom par celui de votre configuration. Conservez un texte de recherche significatif et assez de candidats. -
Testez un filtre sur un champ déclaré filtrable. Copiez un
parent_idrenvoyé et utilisez"filter": "parent_id eq 'COPIED_PARENT_ID'". Doublez une apostrophe présente dans la valeur. Tous les résultats doivent appartenir à ce parent. -
Comme test négatif, filtrez sur
chunks'il n'est pas filtrable. Attendez une erreur HTTP 400 indiquant un champ invalide, et non une réponse réussie vide. -
Conservez la requête, la méthode, les premiers résultats, la latence et le passage attendu. Rejouez le même ensemble après chaque modification.
Pour REST ou un flux HTTP, 2025-09-01 reste une version stable de l'API de recherche de documents ; 2026-04-01 est la dernière version stable de la référence des versions. Utilisez une version prise en charge de manière cohérente. N'introduisez pas de propriétés réservées à une préversion dans une requête stable.
L'index du support examiné déclare une liste vide de profils de score. Cela ne constitue pas un exercice de pondération terminé.
- Dans un index d'essai distinct ou une mise à jour de schéma revue, ajoutez un profil donnant plus de poids à
titlequ'àchunk. - Exécutez la même requête lexicale avec et sans
scoringProfile. Notez la définition et le changement d'ordre. - Comparez la pertinence, pas les valeurs de scores entre BM25, hybride et sémantique. Ne gardez le profil que si le jeu de questions annotées s'améliore.
Les conseils sur les requêtes hybrides décrivent la sélection des candidats et le reclassement. Ajouter des réplicas ne corrige ni une dimension vectorielle erronée ni une citation inutilisable.
- Ouvrez l'environnement et l'agent standard prévus. Vérifiez qu'il s'agit d'un agent de formation jetable, pas d'un agent de production.
- Sélectionnez Connaissances, Ajouter des connaissances, À la une, puis Azure AI Search. Créez une connexion de données formelle avec une authentification autorisée dans votre environnement.
- Préférez Microsoft Entra ID lorsqu'il est disponible. Ne collez jamais d'identifiants dans les instructions, les descriptions d'index, les captures ou ce dépôt.
- Sélectionnez l'unique index vectoriel prévu et ajoutez-le à l'agent. Attendez l'état
Ready. - Rédigez vos propres instructions : répondre uniquement à partir des documents de formation, identifier la source et indiquer l'absence d'information lorsqu'aucun document n'étaye une affirmation.
- Désactivez la recherche web et Allow ungrounded responses, puis écartez les connaissances sans rapport pendant l'évaluation contrôlée. Vérifiez indépendamment la sauvegarde; des instructions seules ne prouvent pas la configuration.
- Posez les questions du tableau de tests. Examinez la trace d'activité et les citations : une réponse seule ne révèle pas le chemin emprunté.
- Pour le français, ajoutez French (France) dans Settings, Languages, puis choisissez cette langue via More, Language dans le panneau de test et démarrez une nouvelle conversation. Saisir du français seul n'a pas changé le brouillon uniquement anglophone. Revenez à la langue principale avant de modifier l'agent. Suivez le guide multilingue; la locale cliente enregistrée ne prouve pas la langue de conversation choisie.
Le guide officiel de connexion contient actuellement des exemples avec clé et des consignes de récupération fondées sur Entra. Utilisez son parcours formel et l'option autorisée par votre locataire. Ne contournez pas le problème avec une connexion de connaissances non prise en charge.
Choisissez ce parcours pour imposer des filtres ou des paramètres de requête. Évaluez-le séparément du parcours Connaissances pour identifier celui qui répond.
- Créez un flux d'agent standard avec le déclencheur de demande de l'agent et une entrée texte
question. - Ajoutez une action HTTP envoyant un POST à l'opération de recherche de documents de votre index. Conservez l'adresse et les identifiants dans une connexion ou une configuration autorisée ; activez la sécurisation des entrées et sorties si disponible.
- Déclarez le type de contenu JSON. Utilisez une connexion Entra et un parcours de jeton approuvés, ou une clé de requête si cette authentification est explicitement autorisée. N'exposez pas de clé d'administration aux utilisateurs.
- Construisez un objet JSON contenant la question comme valeur, sans concaténer du texte utilisateur non échappé. Fixez côté serveur
top,selectet les filtres d'autorisation. - Analysez le tableau
valuede la réponse et renvoyez un volume borné de passages, de titres et d'URL de citation. Renvoyez un état explicite « aucun résultat » si le tableau est vide. - Ajoutez le flux comme outil de l'agent. Décrivez quand l'appeler et imposez une réponse fondée sur ses passages. Un succès HTTP ne prouve pas qu'une réponse est étayée.
- Pour un test déterministe, appelez le flux depuis une rubrique et inspectez son exécution. En routage génératif, vérifiez l'outil choisi dans la trace.
- Si un connecteur personnalisé est nécessaire, déclarez la même opération POST, une connexion authentifiée, une entrée typée et une réponse bornée. Importer une opération ne crée pas à lui seul une source de connaissances en temps réel.
Les actions HTTP, les connecteurs personnalisés et les types de connexion peuvent avoir des licences et des contraintes de prévention des pertes de données distinctes. Aucun flux ni connecteur n'a été créé pendant cette revue.
Pour S5-10, utilisez une identité de connexion jetable, pas les rôles existants de l'administrateur. L'identité utilisée par Search peut différer de la personne qui dialogue avec l'agent : une connexion du créateur n'usurpe pas automatiquement l'identité de chaque utilisateur final.
- Relevez le principal réel de connexion et son affectation Search Index Data Reader approuvée, limitée à l'index. Le guide RBAC documente cette portée. N'accordez pas d'accès aux index non concernés.
- Établissez une réussite autorisée sur le jeu fictif, par requête directe et par la route connectée prévue.
- Retirez uniquement cette affectation de test. Attendez une propagation bornée, renouvelez l'authentification de test et démarrez une nouvelle conversation sans contenu récupéré auparavant.
- Vérifiez le refus direct et le chemin d'erreur connecté. Aucun texte du jeu ne doit provenir du contexte en cache, d'une autre source ou d'un repli. HTTP 403 direct ne prouve pas l'isolation de l'agent; une autorisation refusée ne doit pas être traitée silencieusement comme une recherche vide.
- Supprimez ou restaurez seulement les ressources jetables approuvées. Relevez les rôles finaux sans modifier les permissions de l'administrateur.
Les valeurs exactes concernent uniquement le jeu fictif original. La formulation naturelle et les scores générés ne sont pas des contrats de correspondance exacte.
| ID | Action | Assertion attendue | Résultat actuel |
|---|---|---|---|
| S5-01 | Examiner le conteneur d'essai | Exactement les deux fichiers nommés | Réussi : liste privée et deux empreintes relues |
| S5-02 | Examiner la dernière exécution de l'indexeur |
status vaut success ; itemsFailed vaut 0 ; passages lisibles présents |
Réussi : indexeur privé, deux passages exacts |
| S5-03 | Rechercher rooftop garden
|
Un passage Harbor pertinent figure parmi les trois premiers | Réussi : Harbor premier |
| S5-04 | Demander l'heure d'ouverture du service vélos | Réponse avec 07:00 et citation Harbor |
Réussi : jeu fictif natif |
| S5-05 | Appliquer le filtre du parent copié | Chaque résultat porte exactement le parent_id retenu |
Réussi : Harbor seul |
| S5-06 | Filtrer sur chunk non filtrable |
HTTP 400 et erreur de champ exploitable |
Réussi : erreur de champ |
| S5-07 | Demander le prix de la navette aéroport du lodge | Absence de source explicitement signalée ; aucun prix inventé | Réussi : abstention native explicite |
| S5-08 | Examiner la trace connaissances/flux | Source ou outil prévu invoqué ; citation accessible au testeur autorisé | Réussi : trace native et clic source fictive |
| S5-09 | Répéter en français | Faits 07:00 et 21:00 conservés ; sources correctes |
Réussi : cohorte française distincte |
| S5-10 | Retirer l'autorisation du testeur dans un test approuvé | Accès refusé ; aucune fuite par un chemin de repli | Échec : fait/citation natifs après 403 direct |
Pour au moins dix questions annotées, notez les identifiants de documents pertinents avant les essais. Calculez hit@3 comme le nombre de questions avec un passage pertinent parmi les trois premiers, divisé par le nombre testé. La justesse des citations est le nombre d'affirmations citées étayées divisé par les affirmations citées examinées. Publiez médiane/p95 seulement avec assez de mesures, en précisant leur nombre. Ne produisez pas de pourcentage pour un test non exécuté.
| Symptôme | Vérification et action sûre |
|---|---|
| Téléversement Blob refusé | Vérifiez le rôle de données de votre identité ; renouvelez la session après propagation |
| Lecture du stockage impossible pour l'indexeur | Contrôlez séparément le rôle de lecteur de l'identité Search et le réseau |
| Longueur vectorielle incorrecte | Comparez sortie du modèle, compétence et index ; réindexez dans un index compatible |
| Aucun résultat | Contrôlez erreurs d'indexation, texte extrait, nom d'index, filtre et langue avant les instructions |
| Erreur sémantique ou limitation | Vérifiez configuration, quota, niveau et limites ; réduisez la concurrence |
| Citations inaccessibles | Corrigez URL et droits de lecture ; n'activez pas l'accès Blob anonyme |
| Échec du dialogue de connaissances | Appliquez le parcours officiel de récupération avec l'administrateur d'environnement |
| Réponse fluide mais non étayée | Isolez les sources, désactivez le web, inspectez la recherche et imposez l'abstention |
- Exportez uniquement des preuves assainies : méthode, assertion, résultat, libellé de source anonymisé et horodatages. Excluez clés, jetons, texte protégé et URL privées.
- Supprimez le flux/connecteur d'essai ou son association, puis les connaissances de formation de l'agent jetable.
- Supprimez seulement l'indexeur, l'ensemble de compétences, la source, l'index et les objets blob de cette session après avoir confirmé qu'ils ne sont pas partagés.
- Si l'infrastructure relève de l'atelier 5.1, suivez son plan Terraform de nettoyage revu. Supprimer un index ne met pas fin à la facturation du service Search.
Les anciens résultats de sous-systèmes valident S5-01/S5-02/S5-03/S5-05/S5-06. L'exécution fictive native distincte valide S5-04/S5-07/S5-08/S5-09. Ces essais délimités ne constituent ni une cohorte unique de bout en bout sur le corpus original ni l'atelier complet. URL/corpus hôteliers originaux et S5-10 via le parcours natif authentifié prévu restent ouverts. Les objets d'ingestion et de connexion jetables sont supprimés; ne les redéployez pas pour répéter des réussites. Aucune préparation à la production, économie ou amélioration de pertinence n'est affirmée.