Repository navigation
zh articles langbot v490 rag plugin architecture
本文同步自 LangBot Blog。 阅读 Blog 原文.
发布于 2026-03-10 · 作者:LangBot Team
LangBot v4.9.0 代号 "Knowledge Without Borders"(知识无边界),这个命名精准地概括了本次版本的核心变化:知识库能力从内置实现全面重构为插件化架构。
这不是一次小修小补——它重新定义了 LangBot 中"知识"的边界。
在 v4.9.0 之前,LangBot 的知识库分为两套体系:
- 内置知识库:使用 Chroma 作为向量数据库,嵌入模型由 LangBot 直接调用,文档解析、分块、索引全部内置。
-
外部知识库:通过
KnowledgeRetriever插件组件桥接 Dify、RAGFlow、FastGPT 等外部服务,只做检索,不管文档摄取。
这两套体系在 UI 上以 Tab 切换的方式呈现,数据模型和管理逻辑完全割裂。
问题在于:
- 扩展性差:想换一个向量数据库?想用自己的分块策略?对不起,内置实现写死了。
- 维护成本高:每次 RAG 能力迭代,都需要改 LangBot 核心代码,发版才能生效。
- 体验割裂:内置和外部两种知识库的管理方式完全不同,用户学习成本高。
v4.9.0 的解决方案很直接:把 RAG 能力从 LangBot 核心中抽出来,交给插件。
移除 internal / external 的区分。所有知识库统一管理,通过 rag_engine_plugin_id 区分背后使用的 RAG 引擎。UI 上不再有两个 Tab,只有一个知识库列表,创建时选择引擎即可。
这是本次最核心的新增。KnowledgeEngine(知识引擎)替代了旧的 KnowledgeRetriever,承担完整的知识库生命周期管理:
- 文档摄取(Ingest):从文件解析到向量索引的完整流程
- 知识检索(Retrieve):查询时返回相关知识块
- 文档删除(Delete):清理文档及关联的向量数据
- 生命周期钩子:知识库创建/删除时的回调
换句话说,一个 KnowledgeEngine 插件可以完全控制知识库的索引和检索策略,而不仅仅是做检索。
文档解析也被独立为插件组件。Parser 负责将 PDF、Word、Markdown 等二进制文件转换为结构化文本,然后交给 RAG 引擎做分块和索引。
Parser 和 KnowledgeEngine 的关系:
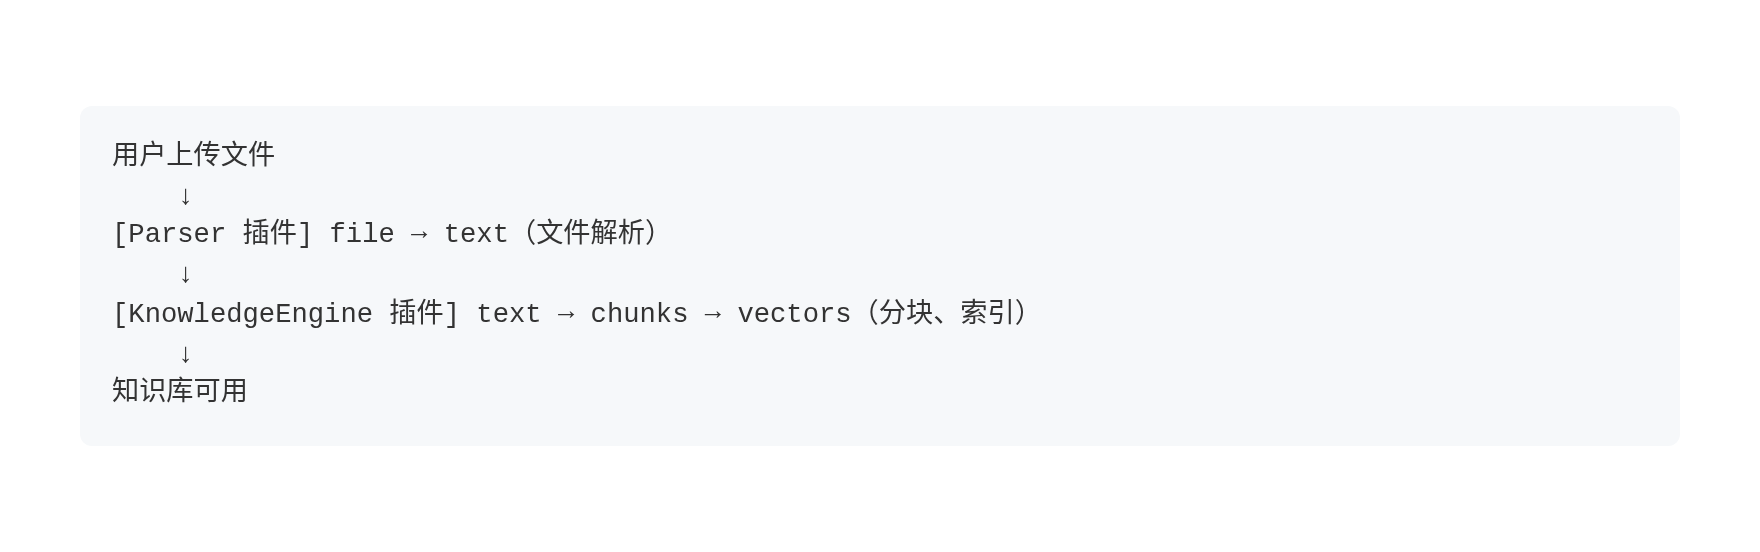
如果 RAG 引擎自身声明了 DOC_PARSING 能力,也可以跳过外部 Parser,自行处理文档解析。
LangBot 核心不再直接执行 RAG 操作,但仍然提供了关键的基础设施,封装在 RAGRuntimeService 中供插件通过 RPC 调用:
-
嵌入模型调用:
invoke_embedding()—— 插件无需自己管理模型连接 -
向量数据库操作:
vector_upsert()/vector_search()/vector_delete()—— 写入、搜索、删除 -
文件读取:
get_knowledge_file_stream()—— 从存储中获取原始文件
这意味着插件可以专注于 RAG 策略(分块方式、检索算法、重排序逻辑),而把向量存储和嵌入模型这些"重"操作交给宿主。
旧的 KnowledgeRetriever 组件已被移除。如果你之前开发过外部知识库插件,需要迁移到 KnowledgeEngine。好消息是 KnowledgeEngine 的 API 更清晰,迁移并不复杂。
以下是开发自定义 RAG 引擎的完整流程。
lbp comp KnowledgeEngine按提示输入引擎名称和描述,SDK 会自动生成目录结构:
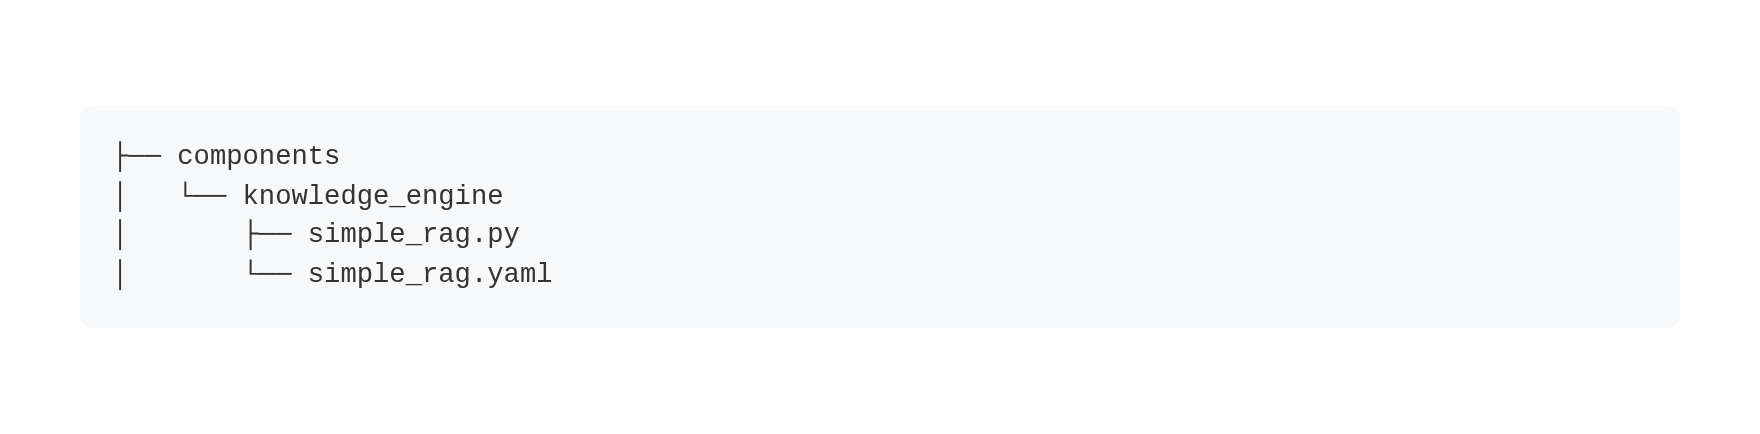
在 .yaml 清单文件中定义两类配置:
-
creation_schema:用户创建知识库时填写的参数(如分块大小、嵌入模型) -
retrieval_schema:检索时可调整的参数(如分数阈值、Top-K)
spec:
  creation_schema:
    - name: chunk_size
      label:
        zh_Hans: 分块大小
      type: integer
      default: 500
    - name: chunk_overlap
      label:
        zh_Hans: 分块重叠
      type: integer
      default: 50
  retrieval_schema:
    - name: score_threshold
      label:
        zh_Hans: 分数阈值
      type: float
      default: 0.5
LangBot 会根据这些 Schema 动态渲染创建和检索的配置表单,不同的 RAG 引擎展示不同的配置项。
class SimpleRag(KnowledgeEngine):

    @classmethod
    def get_capabilities(cls) -> list[str]:
        return [
            KnowledgeEngineCapability.DOC_INGESTION,   # 支持文档上传
            # KnowledgeEngineCapability.DOC_PARSING,   # 可选:支持内置文档解析
]| 能力 | 说明 |
|---|---|
DOC_INGESTION |
支持文档上传和处理。声明后 UI 显示"文档"标签页 |
DOC_PARSING |
支持内置文档解析。未声明则必须安装外部 Parser 插件 |
最关键的三个方法:
文档摄取:
async def ingest(self, context: IngestionContext) -> IngestionResult:
    # 1. 获取文件内容(或使用 Parser 的预解析结果)
    if context.parsed_content:
        text = context.parsed_content.text
    else:
        file_bytes = await self.plugin.get_knowledge_file_stream(
            context.file_object.storage_path
        )
        text = file_bytes.decode('utf-8')

    # 2. 分块
    chunks = self._split_text(text, chunk_size=500)

    # 3. 调用宿主嵌入模型
    vectors = await self.plugin.invoke_embedding(
        embedding_model_uuid, chunks
    )

    # 4. 写入宿主向量数据库
    await self.plugin.vector_upsert(
        collection_id, vectors, ids, metadata
    )

    return IngestionResult(
        document_id=context.file_object.metadata.document_id,
        status=DocumentStatus.COMPLETED,
        chunks_created=len(chunks),
    )
知识检索:
async def retrieve(self, context: RetrievalContext) -> RetrievalResponse:
    # 1. 生成查询向量
    query_vectors = await self.plugin.invoke_embedding(
        embedding_model_uuid, [context.query]
    )

    # 2. 向量搜索
    results = await self.plugin.vector_search(
        collection_id, query_vectors[0], top_k=5
    )

    # 3. 转换并返回
    return RetrievalResponse(results=entries, total_found=len(entries))
文档删除:
async def delete_document(self, kb_id: str, document_id: str) -> bool:
    deleted = await self.plugin.vector_delete(
        collection_id=kb_id, file_ids=[document_id]
    )
return deleted > 0如果你的目标不是自建 RAG 流程,而是桥接 Dify、RAGFlow、FastGPT 等外部服务,实现方式更简单——不需要声明 DOC_INGESTION 能力,只实现 retrieve 方法即可:
class DifyRAGEngine(KnowledgeEngine):

    @classmethod
    def get_capabilities(cls) -> list[str]:
        return []  # 不支持文档上传,由外部服务管理

    async def retrieve(self, context: RetrievalContext) -> RetrievalResponse:
        # 调用 Dify/RAGFlow/FastGPT 的检索 API
        ...
这样在 LangBot 中创建知识库时选择该引擎,不会显示"文档"标签页,知识的管理完全在外部服务中进行。
Parser 的开发更加简洁:
lbp comp Parser在清单文件中声明支持的 MIME 类型:
spec:
  supported_mime_types:
    - application/pdf
    - application/vnd.openxmlformats-officedocument.wordprocessingml.document
实现 parse 方法:
class PdfParser(Parser):

    async def parse(self, context: ParseContext) -> ParseResult:
        # context.file_content: 原始文件字节
        # context.mime_type: 文件 MIME 类型
        # context.filename: 原始文件名

        text = extract_text_from_pdf(context.file_content)

        return ParseResult(
            text=text,
            sections=[
                TextSection(content=page_text, heading=f"Page {i}", page=i)
                for i, page_text in enumerate(pages)
            ],
        )
Parser 和 KnowledgeEngine 之间还支持跨插件调用——一个 RAG 引擎插件可以主动调用另一个插件提供的 Parser:
result = await self.plugin.invoke_parser(
    plugin_author="author_name",
    plugin_name="plugin_name",
    storage_path=context.file_object.storage_path,
    mime_type=context.file_object.metadata.mime_type,
    filename=context.file_object.metadata.filename,
)- 旧版本中创建的内置知识库和外部知识库会由迁移工具自动迁移,更新后到知识库页面确认即可。
-
KnowledgeRetriever组件已废弃,旧插件需要迁移到KnowledgeEngine。 - 在插件市场可以找到已有的 RAG 引擎插件。
v4.9.0 的知识库插件化是 LangBot 插件系统的又一次扩展。从 v4.0 的事件处理器和工具,到知识检索器,再到现在的 RAG 引擎和解析器——LangBot 的核心能力正在逐步从"内置"走向"可插拔"。
这个方向的终局是:LangBot 核心只提供流水线编排和基础设施,所有业务能力都由插件驱动。
想要自定义分块策略?写个 KnowledgeEngine 插件。想支持 PDF 解析?写个 Parser 插件。想桥接企业内部的知识库服务?同样是一个插件。
知识,不再有边界。
相关链接: