Repository navigation
Media
把 视频(动画、动态漫画、影视、实况等)或 纯音频(ASMR、同人音声、广播剧、有声书等)直接交给 AGENT,从语音识别、画面文字定位到翻译成片一站搞定。
| 素材类型 | 识别内容 | 默认交付物 |
|---|---|---|
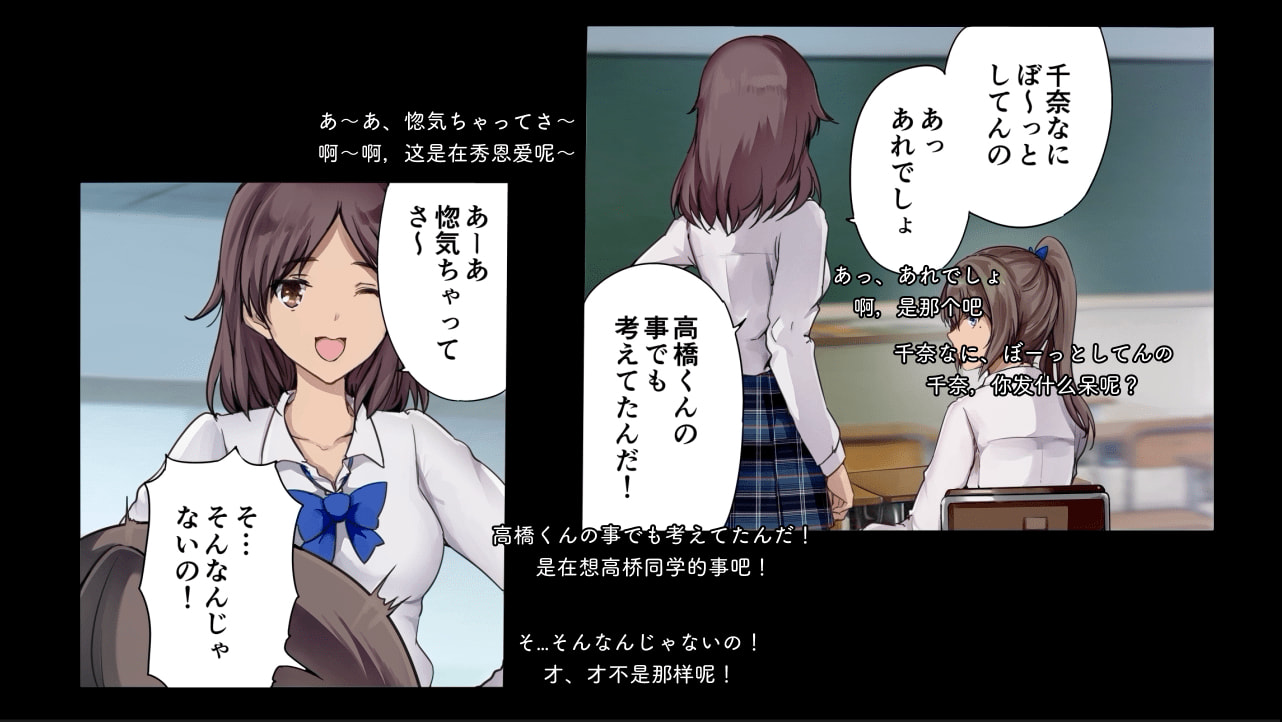
| 视频 / 动态漫画 | 语音对白 + 画面文字(气泡、旁白、招牌、拟声词、硬字幕) | 译文 .ass + 双语 .ass
|
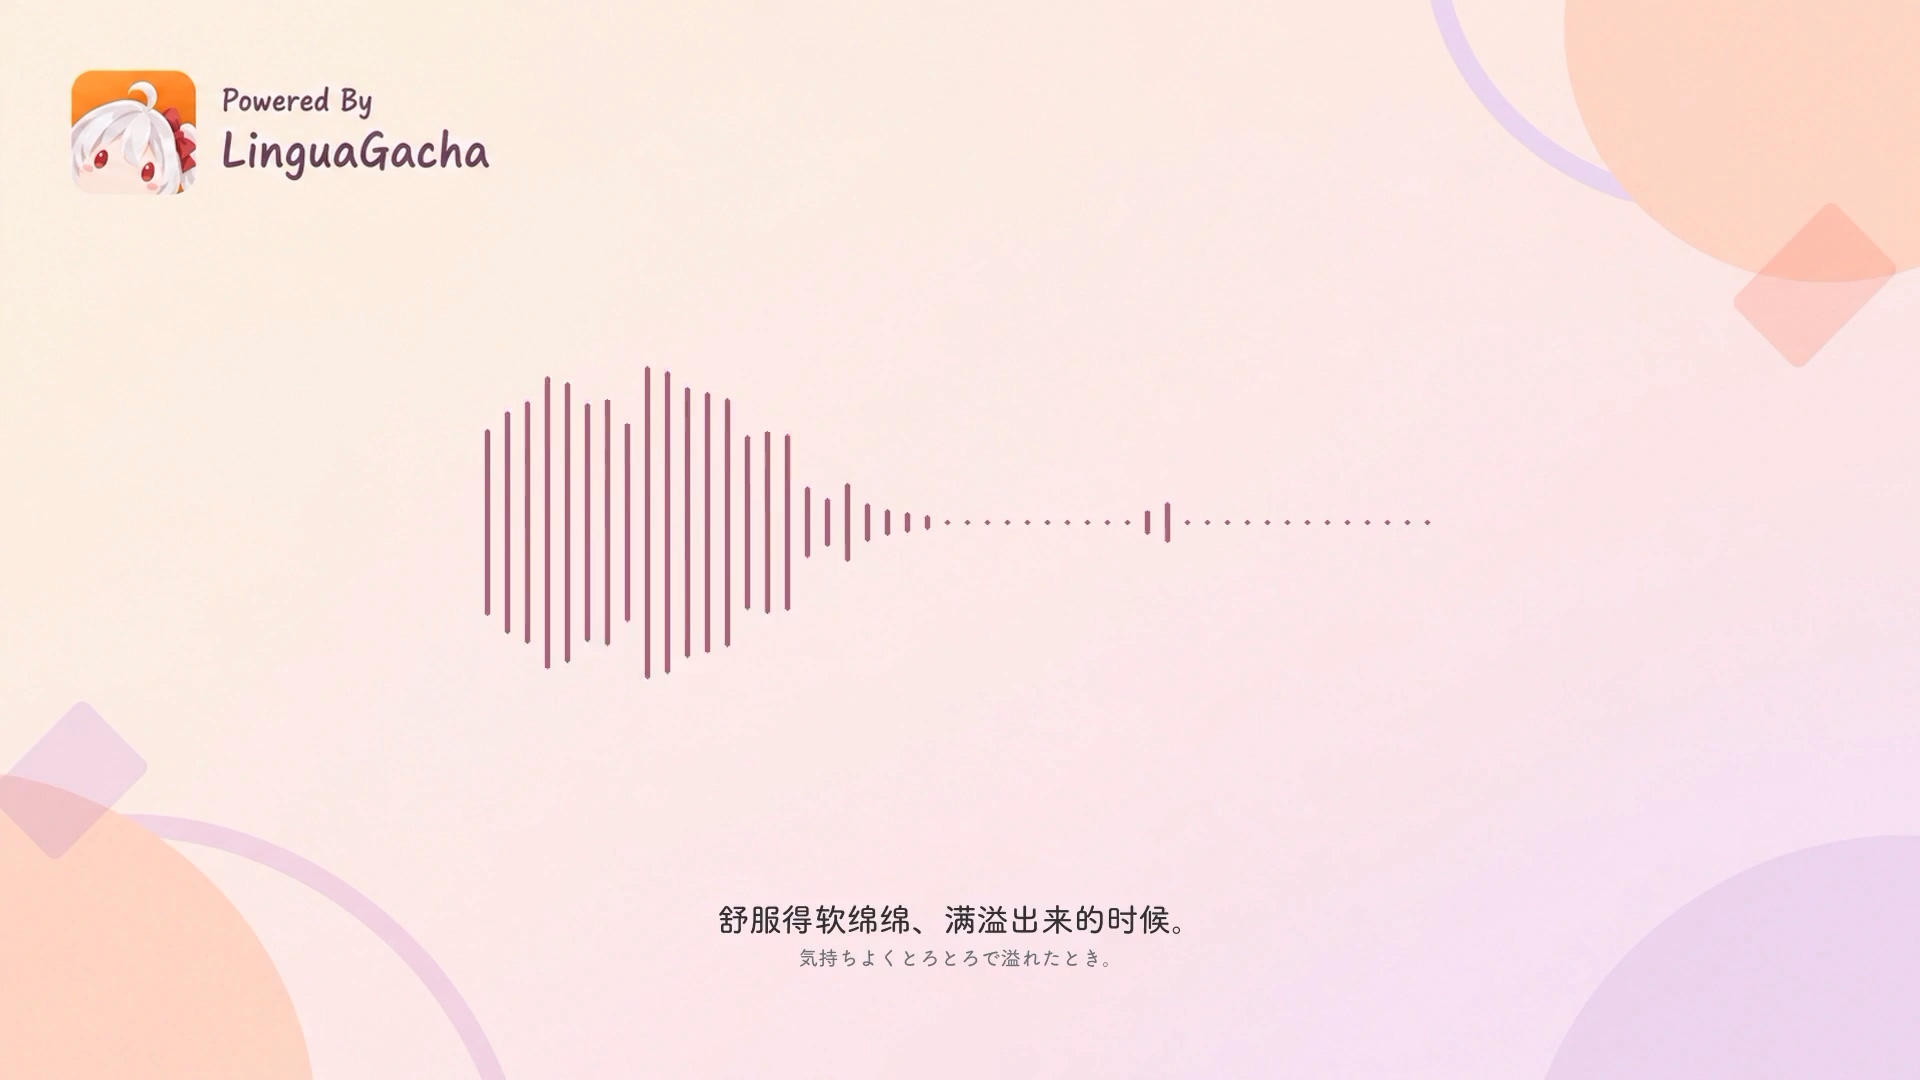
| 纯音频 / 带封面音频 | 语音对白(跳过画面步骤) | 译文 .ass + 双语 .ass + 烧录双语字幕的 1920×1080 频谱可视化 .mp4
|
💡 只要文件没有视频画面流(哪怕音频文件内嵌了封面图),应用都会自动按 纯音频 处理,不依赖扩展名猜测
- 动态漫画 / 视频双语字幕:贴合原文字或气泡就近摆放,自动避开人脸与原文区域,减少遮挡
- 纯音频频谱可视化双语成片:固定亮色品牌背景 + 实时声波频谱 + 双语字幕直接烧录
- 完成一次 [模型管理] 配置(至少设好
主控模型) - 两种方式任选其一:
-
直接拖入(推荐):在未打开工程的
AGENT页,直接把音频或视频文件(或文件夹)拖进输入框,确认原文语言/译文语言与.lg保存位置,按下回车即可开跑 -
空工程后拖入:在
AGENT点击创建工程(不选文件直接创建空工程),再把素材拖进输入框并说明需求(例如识别并翻译)
-
直接拖入(推荐):在未打开工程的
💡 目前对白语音识别支持 中 / 英 / 日 / 韩 以及
ALL自动识别
- 首次运行音视频任务时,
AGENT会提示安装本地依赖并下载约550 MB的语音识别与画面检测模型(支持断点续传,后续任务直接复用,不重复下载) - 默认优先启用 GPU 加速;GPU 不可用时会自动切换至 CPU 模式继续处理
- 耗时提示:一小时左右的素材在 GPU 上通常只需几分钟;使用 CPU 或 4K 视频时会明显更久
-
已有内封字幕:如果视频内嵌了文本字幕流,
AGENT会先询问你是否直接提取字幕来翻译(准确度通常高于语音识别) -
多音轨素材:存在多条音轨时,
AGENT会列出音轨信息请你指定要处理的那一条
本地语音识别遇到歌声、喊叫、多人重叠说话、极度嘈杂等难以听清的片段时,AGENT 会列出具体时间段与预估请求次数,必须经你确认后才会调用付费音视频模型补查,拒绝后也可直接保留原文或作为未决项继续后续流程。
- 无需额外配置音视频模型即可完成本地识别与翻译;如需启用疑难片段补查,请在
AGENT输入框顶部打开子模型→音视频模型,推荐配置gemini或doubao-seed-lite - 绝大多数普通模型不支持直接理解音视频片段,如无需补查保持默认
跟随主控模型即可
确认翻译结果满意后,点击 指令 → 导出翻译成果(或按 AGENT 提示完成导出)。
-
单语输出目录:生成译文.ass -
双语输出目录:生成双语.ass;纯音频任务还会额外生成一份烧录好双语字幕的.mp4成片
-
播放器双语字幕叠字:纯音频成片
.mp4已经把双语字幕烧录在画面里。如果同目录还放着同名.ass字幕文件,播放该.mp4时请关闭播放器的「自动加载外挂字幕」,避免上下叠出两层字幕 -
视频自动挂载字幕:视频交付物默认与原视频同名,将
.ass放到原视频同目录下,主流播放器即可自动加载 -
移动或重命名了原文件:复核、补查或生成音频成片需要读取原媒体文件;若路径变动,
AGENT会提示你输入新路径并自动重新关联,无需重新翻译 -
逐句修正:播放成片发现某句翻译或时间点有误,直接把对应时间点发给
AGENT让它定位调整,完成后重新导出即可