Repository navigation
Decoding and confidence RU
🌐 English · Русский
Установите 0.5.1 и скачайте примеры.
Некоторые буквы похожи друг на друга, особенно на размытых сканах. Языковая модель использует закономерности слов, чтобы помочь выбрать между возможными вариантами прочтения.
Она уже включена. Для обычной работы ничего дополнительно настраивать не нужно.
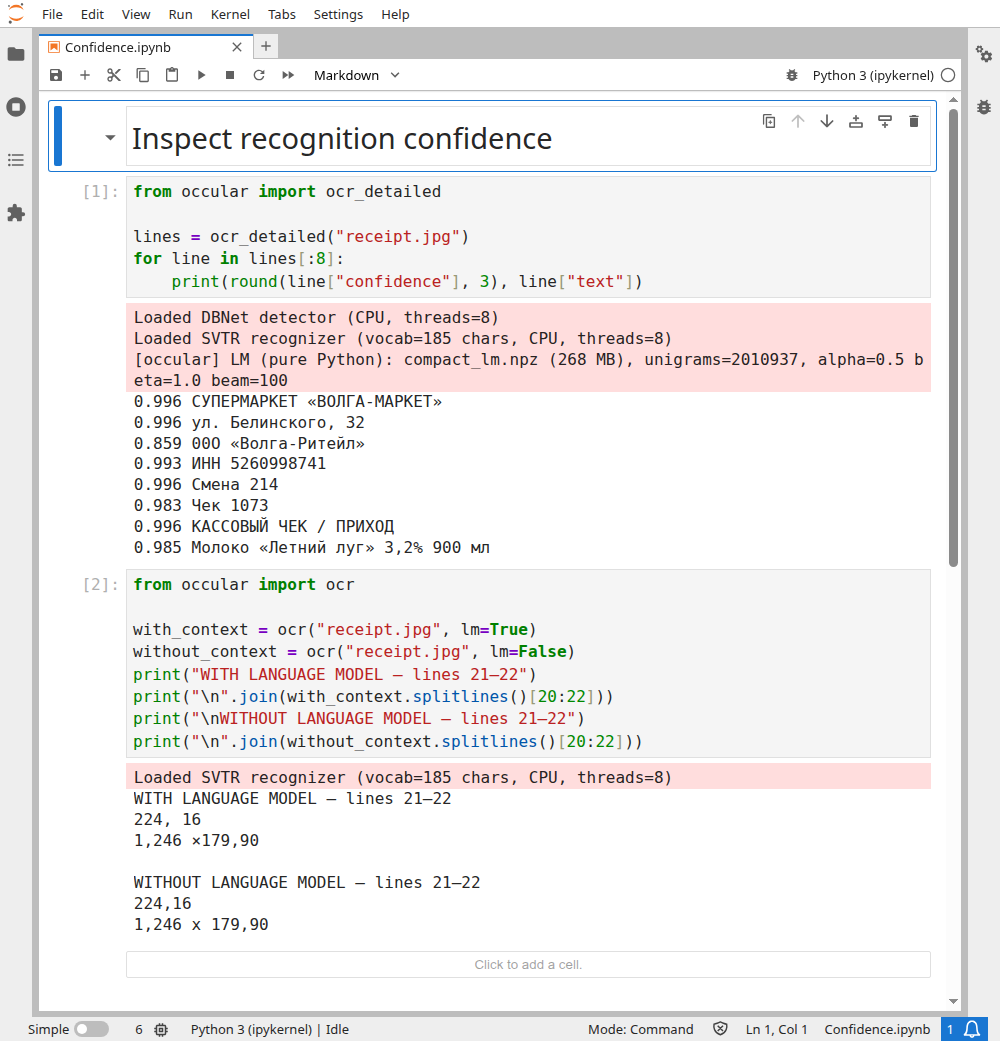
Используйте уверенность, чтобы выбрать строки для ручной проверки. Здесь явно выбраны и напечатаны оценки первых восьми строк:
from occular import ocr_detailed

lines = ocr_detailed("receipt.jpg")
for line in lines[:8]:
    print(round(line["confidence"], 3), line["text"])
Фактический вывод:
0.996 СУПЕРМАРКЕТ «ВОЛГА-МАРКЕТ»
0.996 ул. Белинского, 32
0.859 00О «Волга-Ритейл»
0.993 ИНН 5260998741
0.996 Смена 214
0.983 Чек 1073
0.996 КАССОВЫЙ ЧЕК / ПРИХОД
0.985 Молоко «Летний луг» 3,2% 900 мл
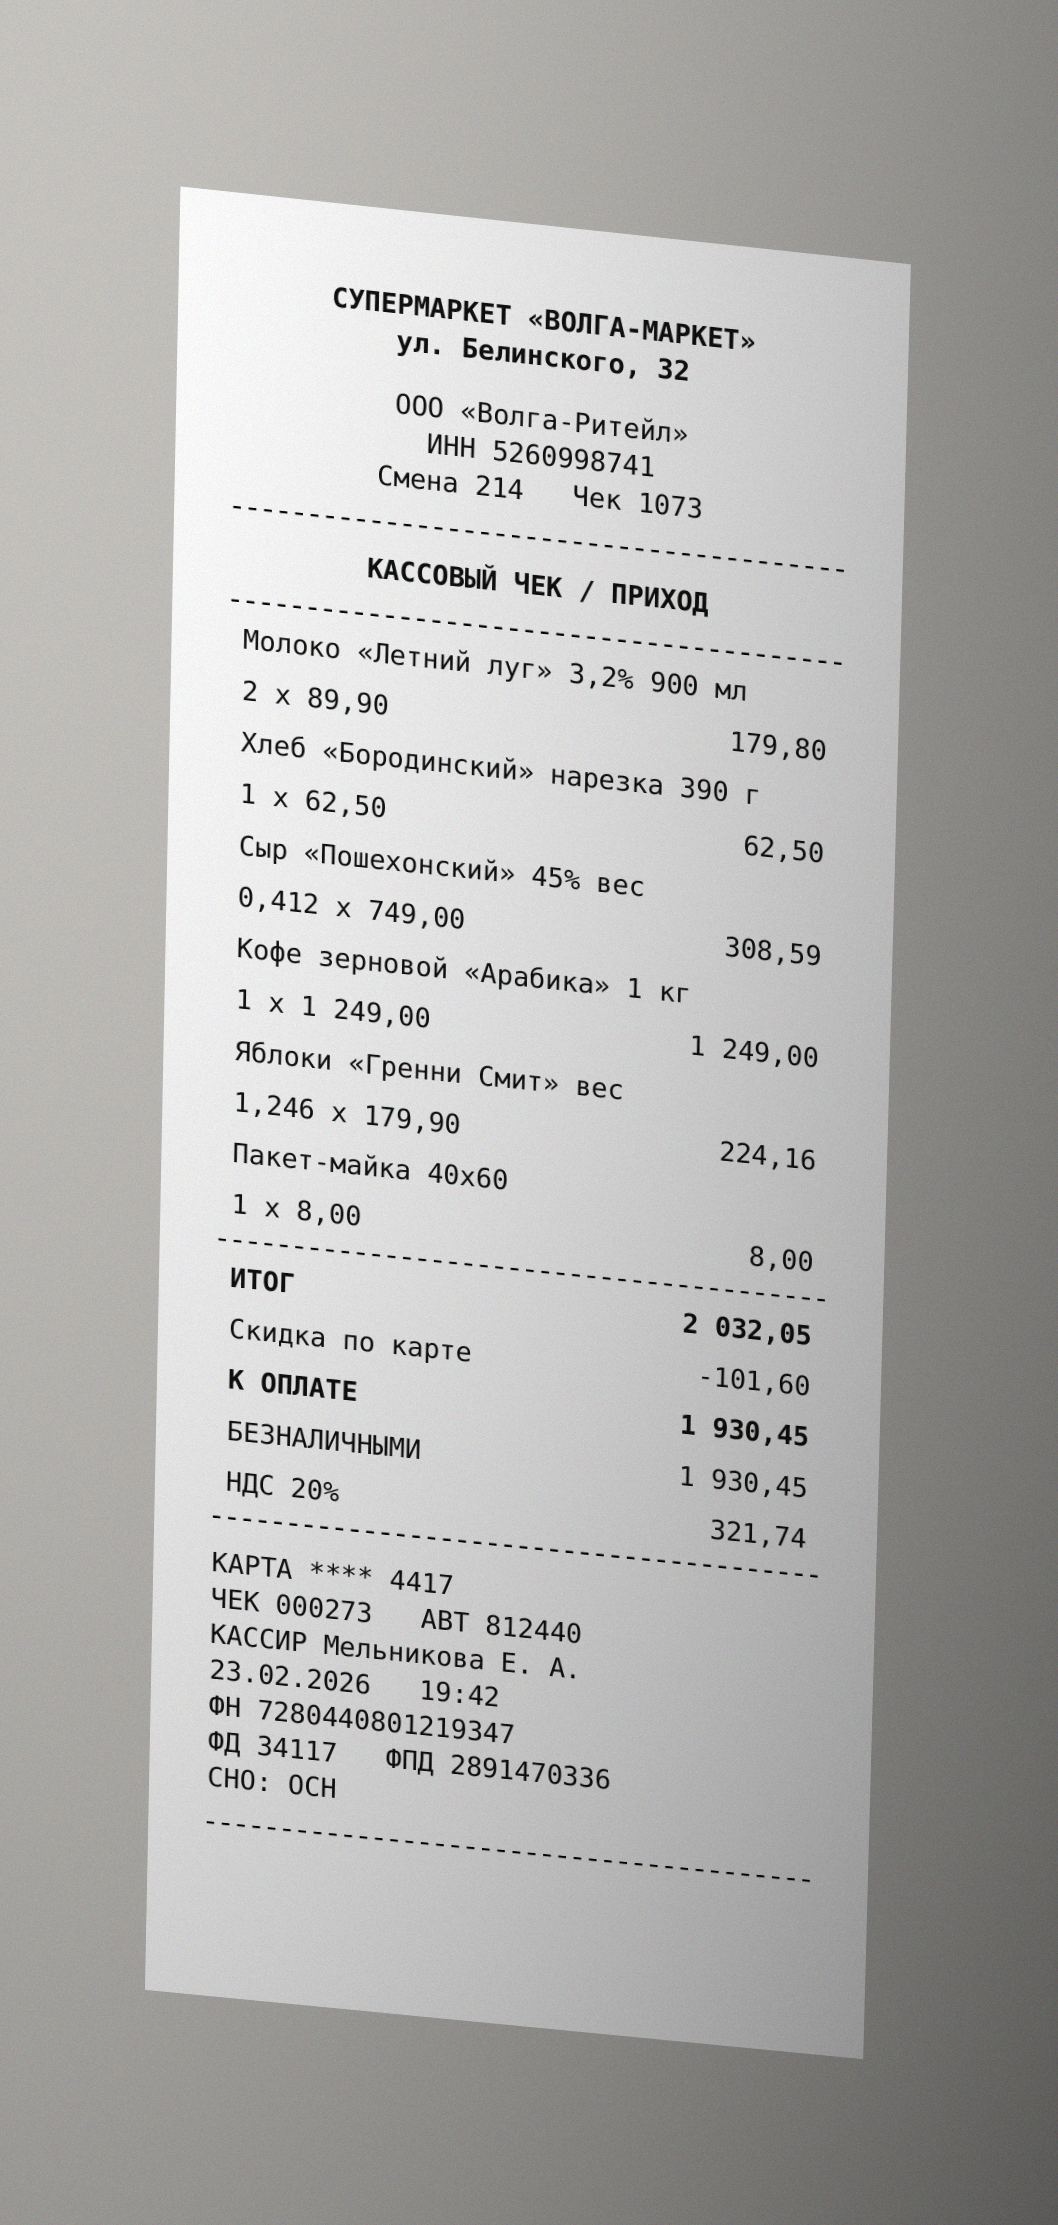
В строке с оценкой 0.859 получилось 00О, хотя на изображении написано ООО. Более высокая оценка не гарантирует правильность, а один этот пример не позволяет выбрать полезный универсальный порог.
Открыть настоящий запуск в Jupyter: весь код виден
Для необычных имён или идентификаторов сравните оба режима на своих документах.
Отключение языковой модели может ускорить работу, но привести к дополнительным ошибкам в написании. Первые пять строк чека одинаковы в обоих режимах, поэтому в блокноте явно выбраны строки 21–22, где результат меняется:
from occular import ocr

with_context = ocr("receipt.jpg", lm=True)
without_context = ocr("receipt.jpg", lm=False)
print("WITH LANGUAGE MODEL — lines 21–22")
print("\n".join(with_context.splitlines()[20:22]))
print("\nWITHOUT LANGUAGE MODEL — lines 21–22")
print("\n".join(without_context.splitlines()[20:22]))
Фактический вывод выбранного фрагмента:
WITH LANGUAGE MODEL — lines 21–22
224, 16
1,246 ×179,90

WITHOUT LANGUAGE MODEL — lines 21–22
224,16
1,246 x 179,90
Для этой позиции языковая модель меняет пробелы и x на ×. Само изменение не доказывает роста точности: на исходном изображении между количеством и ценой стоит ×, но оба результата всё ещё отличаются расстановкой пробелов. В любом режиме сверяйте идентификаторы и важные числа с изображением.
Эта оценка показывает, насколько уверенно распознаватель выбрал текст строки. Она помогает решить, что проверить в первую очередь:
from occular import ocr_detailed

for line in ocr_detailed("receipt.jpg"):
    if line["confidence"] < 0.8:
        print("Check this:", line["text"])
Здесь 0.8 — лишь пример порога. Оценка 0.95 не означает, что 95% символов распознаны правильно. Даже строка с высокой уверенностью может содержать неверную цифру.
Почему у всех строк PDF уверенность 1.0?
Готовый текст PDF извлекается, а не распознаётся. Его оценка — условное значение. Прежде чем расставлять приоритеты проверки по уверенности, посмотрите, равно ли поле страницы method значению "text".