Repository navigation
Home RU
🌐 English · Русский
Occular-OCR — это OCR-комбайн, созданный специально для работы с документами.
Превращайте сканы и фотографии документов в текст для дальнейшей работы; при необходимости восстанавливайте порядок чтения и ячейки таблиц.
Установите 0.5.1 и скачайте примеры.
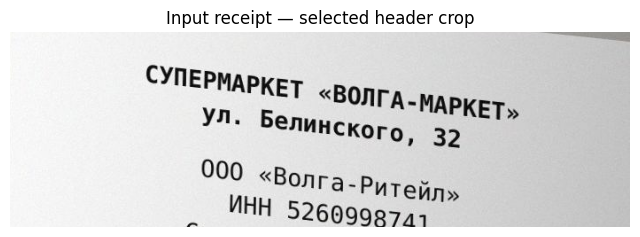
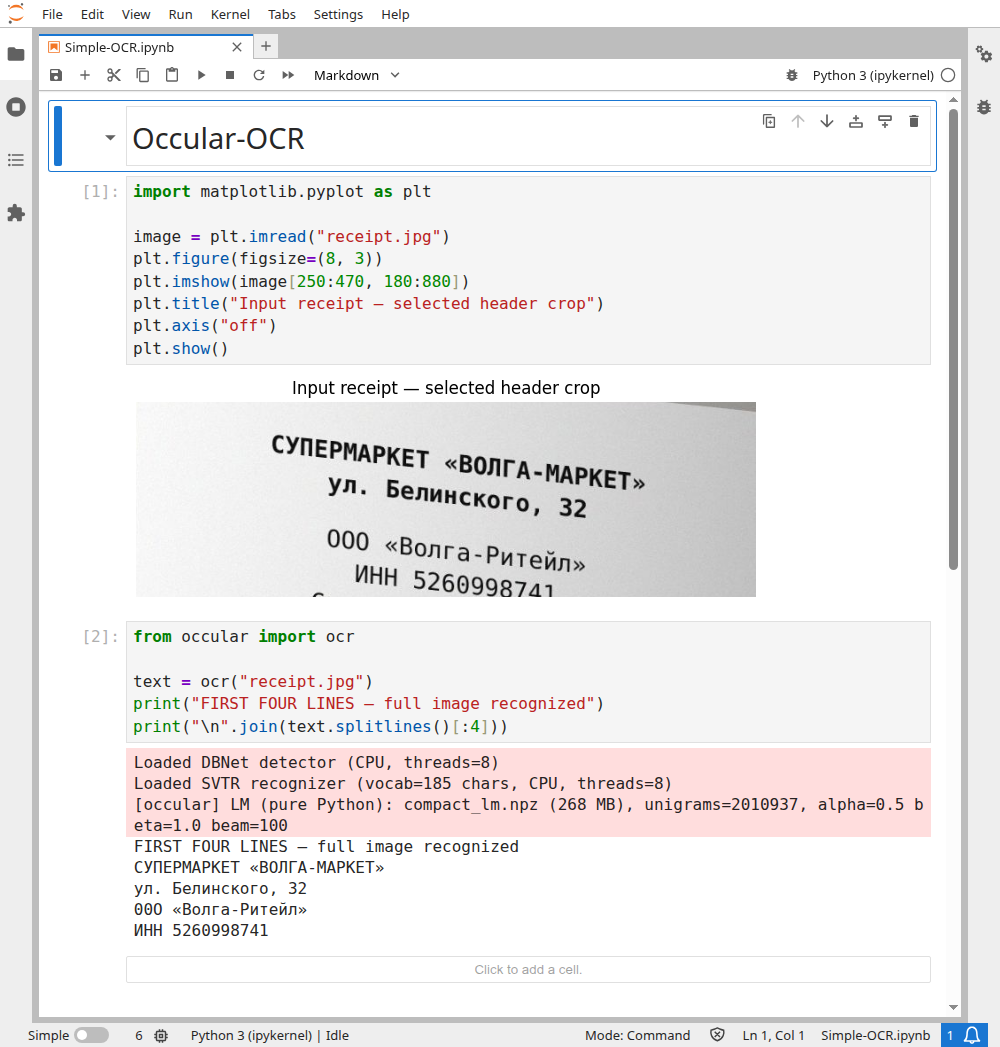
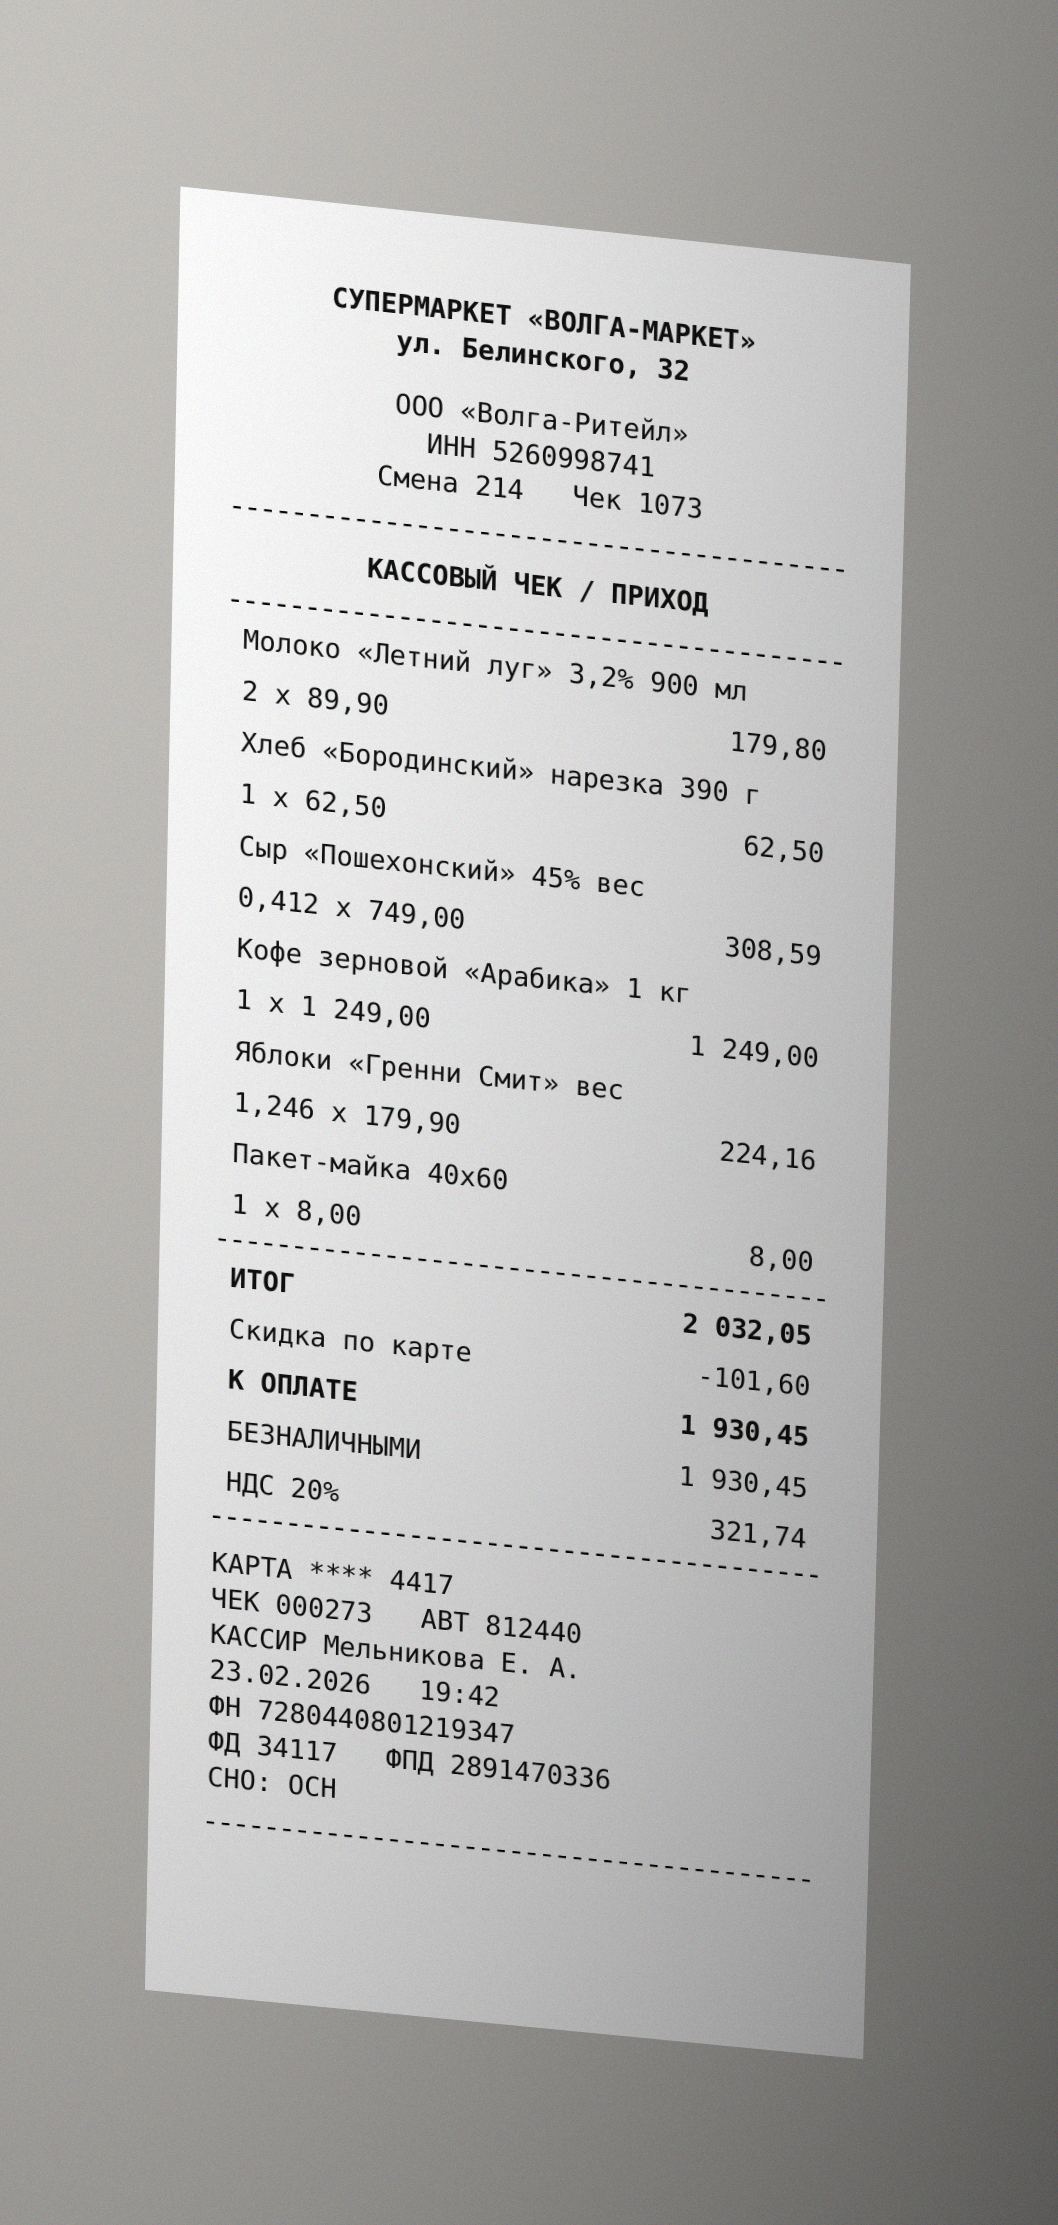
Блокнот распознаёт весь синтетический чек. Чтобы результат было удобно сравнить с оригиналом, Matplotlib показывает только шапку, а print() выбирает первые четыре строки OCR:
from occular import ocr

text = ocr("receipt.jpg")
print("FIRST FOUR LINES — full image recognized")
print("\n".join(text.splitlines()[:4]))
Фактический выбранный текст; блокнот также печатает подпись фрагмента:
СУПЕРМАРКЕТ «ВОЛГА-МАРКЕТ»
ул. Белинского, 32
00О «Волга-Ритейл»
ИНН 5260998741
В третьей строке получилось 00О вместо ООО: результат OCR нужно проверять. Запустите полный пример получения текста из изображения или откройте блокнот с чеком ниже.
Открыть настоящий запуск в Jupyter: весь код виден
Скачать блокнот · Изображение чека
Выполните эти команды в терминале.
Установите один раз:
python -m pip install "occular-ocr==0.5.1"Распознайте документ:
ocr scan.png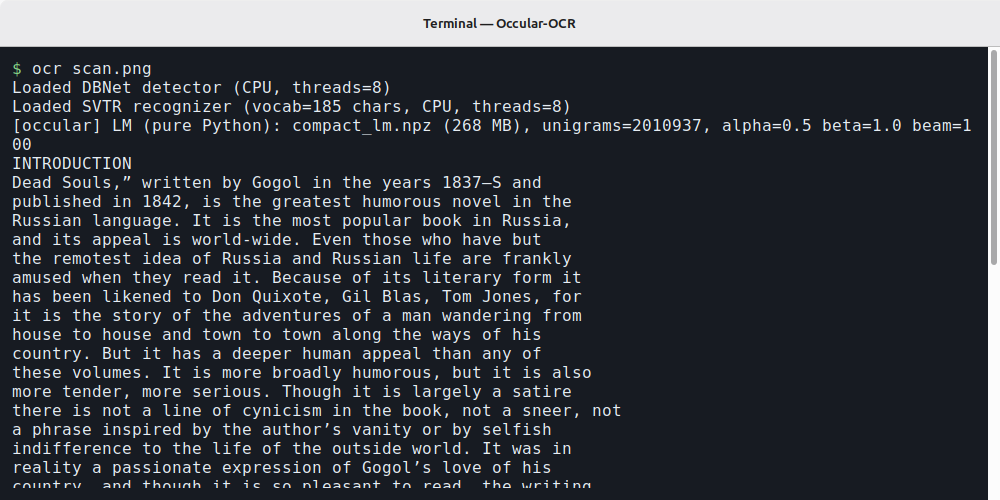
Текст появится в терминале. Вместо изображения можно передать scan.pdf. Первый запуск скачивает модели, поэтому занимает больше времени.
Работаете в Python или Jupyter? Начните с примера в три строки →
- Исправить наклон или поворот фотографии → Выровнять страницу
- Прочитать страницу с двумя колонками → Сохранить правильный порядок чтения
- Извлечь таблицу из счёта → Распознать таблицы
- Прочитать PDF со старым или повреждённым текстовым слоем → Работать с PDF
- Прочитать текст на украинском, казахском или другом поддерживаемом языке → Выбрать язык
- Обработать папку сканов → Использовать командную строку
Что-то не так? Найдите свой случай →