Repository navigation
Technical notes RU
🌐 English · Русский
Установите 0.5.1 и скачайте примеры.
Эти подробности нужны для интеграций и поиска ошибок. Для обычного распознавания начните с короткого руководства.
Геометрия, пороги и выравнивание изгиба
Коррекция наклона страницы использует геометрию линий OpenCV, порог согласованности и диапазон углов примерно 0.7–20°. Размеры изображения сохраняются, поэтому содержимое у краёв может пострадать. Эта настройка также управляет обработкой ориентации отдельных строк в обычном пути детектора.
Ориентацию всей страницы определяет отдельная модель. Ненулевой поворот применяется только при уверенности выше 0.8. Страницы с малым количеством текста или необычным содержимым могут остаться без изменений или получить неверный прогноз.
UVDoc с проверкой сравнивает sum(len(text) * confidence) для исходного и распрямлённого вариантов. Распрямлённый выбирается, только если его оценка больше исходной более чем в 1.05 раза. Это эвристика, а не точность относительно эталонного текста. Инициализация модели может завершиться ошибкой. Возврат к исходному варианту предусмотрен при сбое последующей попытки распрямить и обработать изображение.
unwarp="always" пропускает сравнение. Другая строка выбирает локальный файл ONNX, папку с model.onnx или идентификатор модели в Hub. Настроек unwarp_gate и unwarp_margin в 0.5.1 нет.
Путь OCR для PDF применяет deskew, но не вызывает ориентацию и UVDoc из обработки изображений. Для них используйте рецепт отрисовки в изображения.
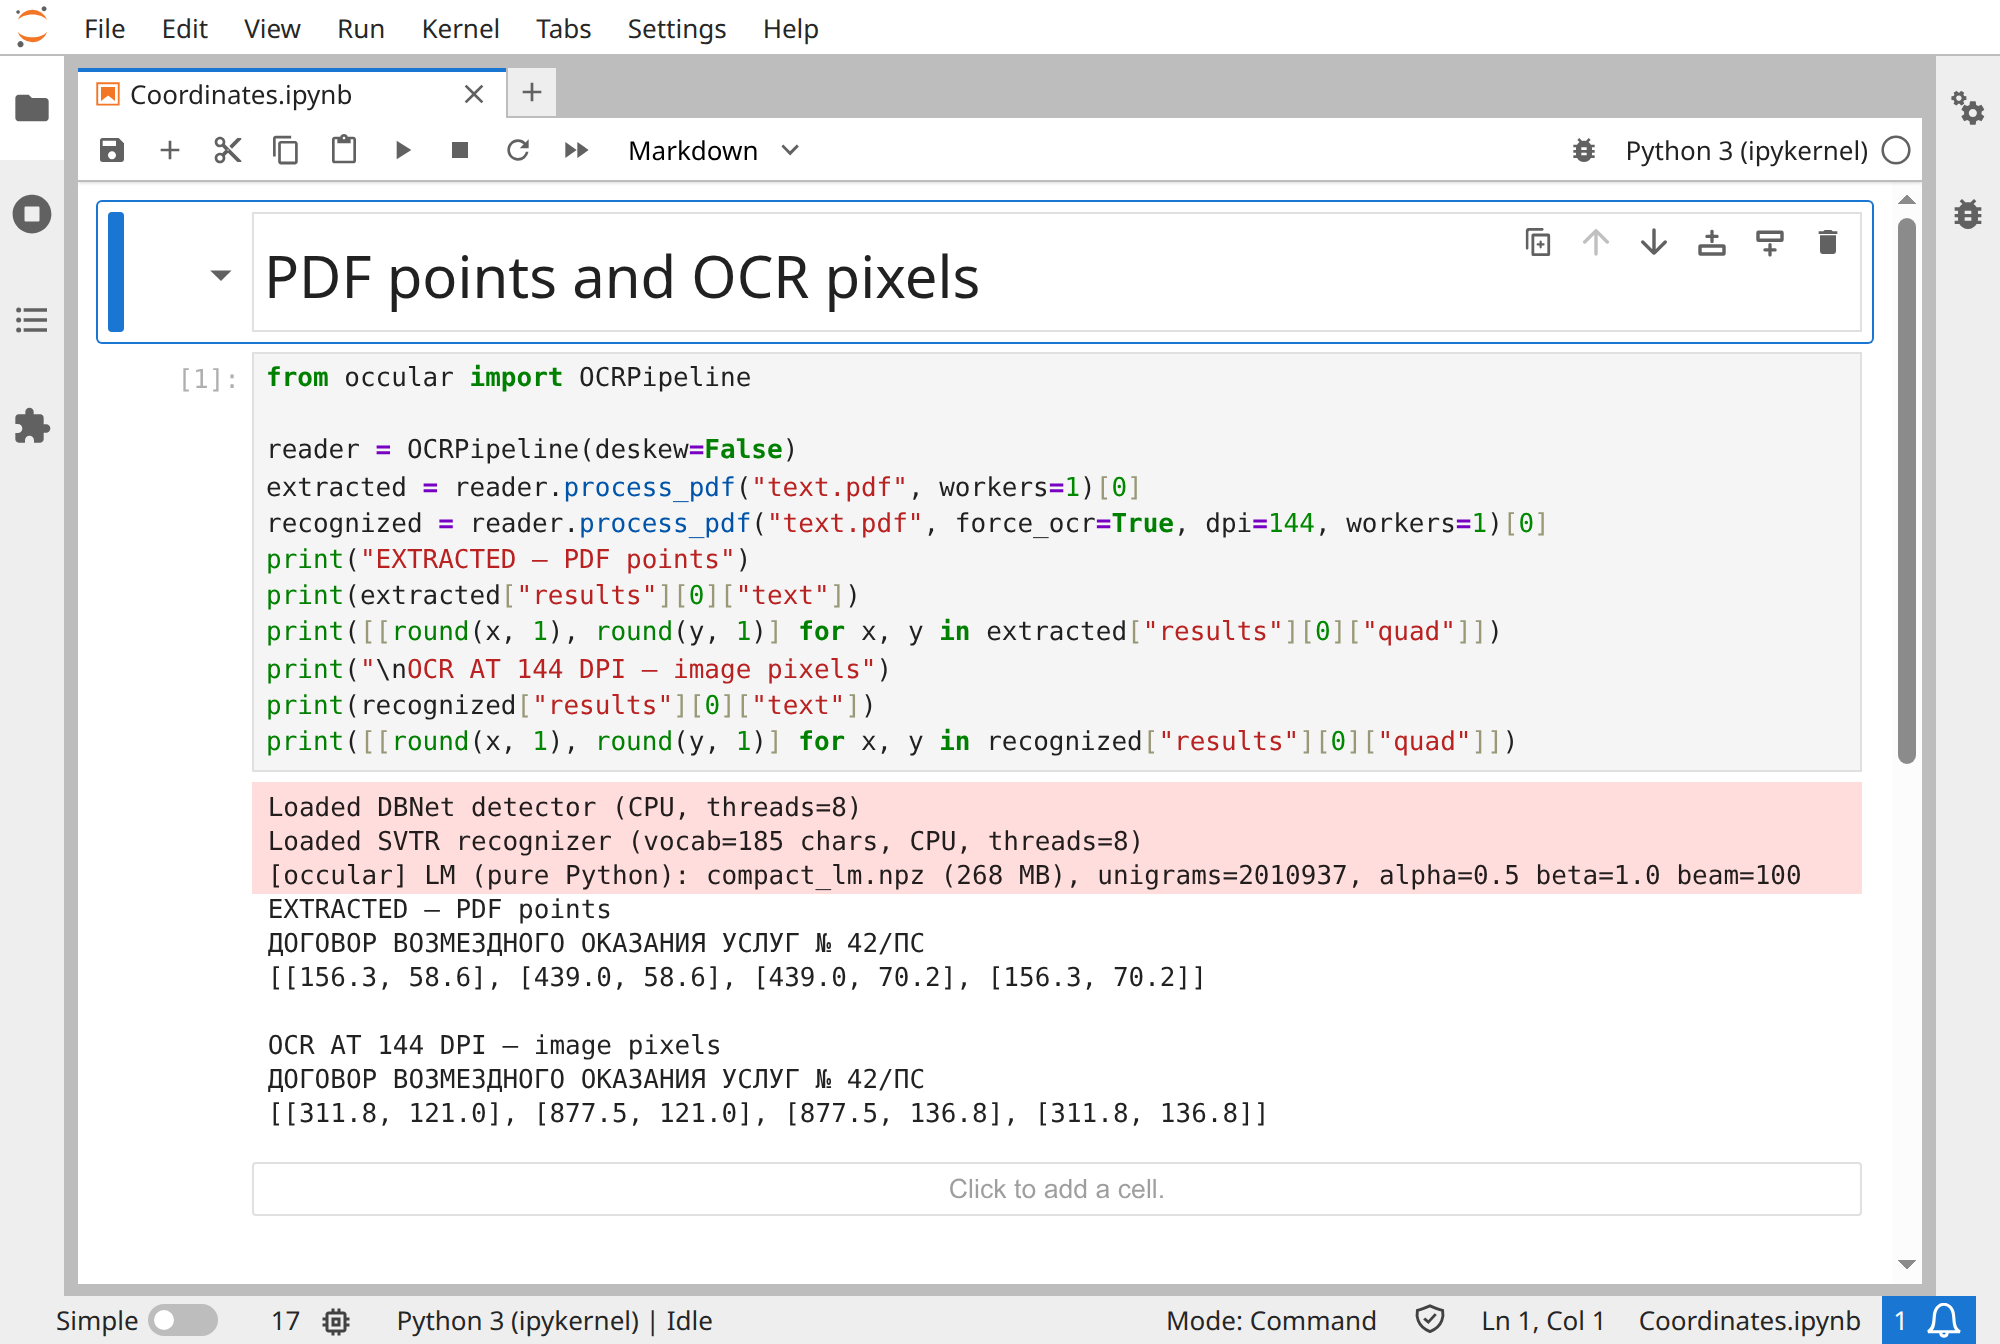
Используйте этот пример, когда рисуете рамки извлечённого текста и OCR в одном просмотрщике. Входной PDF есть в комплекте примеров. Здесь deskew отключён, чтобы сравнивать только единицы:
from occular import OCRPipeline

reader = OCRPipeline(deskew=False)
extracted = reader.process_pdf("text.pdf", workers=1)[0]
recognized = reader.process_pdf("text.pdf", force_ocr=True, dpi=144, workers=1)[0]
print("EXTRACTED — PDF points")
print(extracted["results"][0]["text"])
print([[round(x, 1), round(y, 1)] for x, y in extracted["results"][0]["quad"]])
print("\nOCR AT 144 DPI — image pixels")
print(recognized["results"][0]["text"])
print([[round(x, 1), round(y, 1)] for x, y in recognized["results"][0]["quad"]])
Фактический вывод:
EXTRACTED — PDF points
ДОГОВОР ВОЗМЕЗДНОГО ОКАЗАНИЯ УСЛУГ № 42/ПС
[[156.3, 58.6], [439.0, 58.6], [439.0, 70.2], [156.3, 70.2]]

OCR AT 144 DPI — image pixels
ДОГОВОР ВОЗМЕЗДНОГО ОКАЗАНИЯ УСЛУГ № 42/ПС
[[311.8, 121.0], [877.5, 121.0], [877.5, 136.8], [311.8, 136.8]]
При 144 DPI один пункт PDF занимает два пикселя отрисованного изображения. Координаты рамки OCR примерно вдвое больше координат извлечённой рамки; границы тоже различаются, поскольку OCR находит пиксели текста, а извлечение сообщает геометрию шрифта. Точного равенства ждать не стоит. Подробности преобразований, обрезки и ограничений поворота — ниже.
Открыть настоящий запуск в Jupyter: весь код виден
Единицы, преобразования и поведение извлечения
| Результат | Единицы и система координат |
|---|---|
| OCR изображения | Пиксели выбранного обработанного изображения |
PDF method="ocr"
|
Пиксели отрисованной страницы после deskew |
PDF method="text"
|
Пункты PDF, возвращённые при извлечении |
| Отдельный вызов детектора макета | Пиксели именно входного изображения |
| Таблицы внутри конвейера | Те же единицы и система координат, что у связанных строк |
Для отрисованного изображения без преобразований pixels = points * dpi / 72. Формула меняет только масштаб; для deskew, поворота страницы, обрезки и выравнивания изгиба нужны отдельные преобразования. API не возвращает полного обратного преобразования предобработки. Метаданные ориентации отдельных строк его не заменяют.
Любой непустой извлечённый текст может выбрать method="text". Этот путь сортирует извлечённые строки сверху вниз и обходит выбор языка OCR, языковую модель, предобработку и упорядочивание по макету. confidence=1.0 — условная оценка. При этом таблицы всё ещё могут определяться на отрисованном изображении и масштабироваться к координатам текста.
force_ocr=True возвращает данные распознавания, не меняя входной PDF. Опубликованная 0.5.1 использует PyMuPDF; локальные эксперименты с другими движками не входят в описываемую версию. В публичном API нет параметра пароля PDF.
Метки областей, оценки и привязка строк
LayoutDetector.detect() принимает путь, изображение PIL или массив NumPy в RGB. У областей есть bbox=(x1,y1,x2,y2), score, label и label_id; результат также содержит ширину и высоту изображения. to_dict() даёт данные, совместимые с JSON. Области сортируются по оценке, а не в порядке чтения.
Порог оценки по умолчанию — 0.6. Повысьте его, чтобы оставить меньше предсказаний; понизьте, чтобы искать пропущенные области ценой большего числа ложных срабатываний и дублей. Отдельный вызов detect(..., score_threshold=...) не меняет настройки конвейера.
Метки: Caption, Code, Equation, Figure, Footnote, Form, ListItem, PageFooter, PageHeader, Picture, SectionHeader, Table, TableOfContents, Text, TextInlineMath, stamp, signature, handwritten_text.
Эти классы не извлекают поля, не проверяют подписи и не выполняют специальное распознавание рукописного текста. Одна лишь метка области не исключает строки из обработки.
Порядок чтения связывает строки OCR с текстовыми областями по степени покрытия, затем упорядочивает области и непривязанные строки моделью порядка блоков. Необязательные индексы layout_region относятся к внутреннему списку найденных областей; layout_label хранит класс. Для непривязанных строк используется None. Индексы и геометрия отдельного вызова анализа макета на исходном изображении могут не совпасть с OCR после предобработки.
И download_layout(), и download_reading_order() подготавливают веса детектора и порядка блоков. layout_ready() и reading_order_ready() проверяют наличие обоих файлов. Отдельному детектору макета нужен только файл его детектора.
Формат записей и отдельная детекция таблиц
Записи таблиц внутри конвейера содержат bbox из четырёх значений, confidence детекции, n_rows, n_cols, полосы строк и колонок и cells. У ячеек есть отсчитываемые от нуля r, c, а также rowspan, colspan и text. Связанные строки получают table и cell; части разделённых строк, пересекающих границы, могут получить split=True.
Ошибки возможны на каждом этапе: поиска таблицы, восстановления сетки и распределения текста по ячейкам. Части строк, пересекающих границы, берутся из распознанного текста строки. Таблицы на нескольких страницах не объединяются автоматически. JSON сохраняет объединения ячеек; Markdown/CSV сводят их к опорным позициям.
Отдельный TableRecognizer ожидает BGR, в отличие от RGB-массивов детектора макета. Его вызов возвращает геометрию и структуру без распознавания текста ячеек. detect() даёт рамки; structure(crop) — полосы и объединённые ячейки в координатах фрагмента. Рамки отдельного детектора содержат пять значений, включая оценку. При merge=False поле cells низкоуровневой структуры остаётся пустым.
Класс Table модели макета существует отдельно от специализированного распознавателя таблиц.
Расчёт оценок и выбор декодера
Жадное CTC-декодирование схлопывает повторяющиеся предсказания и удаляет пустые символы. Его уверенность — среднее геометрическое вероятностей по кадрам, выдающим непустой символ. Декодирование с лучевым поиском и языковой моделью использует нормированную по длине акустическую оценку выбранной гипотезы с верхней границей 1. Защита буквенно-цифровых кодов и идентификаторов может затем заменить соответствующие фрагменты вариантом жадного декодирования.
Эти оценки не являются калиброванными вероятностями правильности итоговой строки. Оценки макета, детекции таблиц и условные значения извлечённого PDF-текста относятся к разным решениям; без проверки для них не следует использовать один общий порог ручной проверки.
Стандартный русский распознаватель при lm=True использует лучевой поиск и русскую языковую модель. Дополнительные кириллические языки используют настройки декодирования своего языка из пакета; для некоторых применяется жадное декодирование. В многоязычном режиме маршрут выбирается для каждой строки; Python принимает списки языков, а CLI разделяет коды по запятым. Неподдерживаемые коды вызывают ошибку. Стандартная схема строки не гарантирует метку языка.
Дополнительный Rust-декодер выбирается автоматически, если установлен совместимый пакет. OCCULAR_NATIVE_DECODER=0 отключает его. Инструкция по нативному декодеру.
Процессы, потоки и CUDA
num_threads управляет выполнением модели внутри страницы. workers распределяет параллельные задачи PDF или папки. При автоматическом выборе числа обработчиков учитываются число задач, CPU, оценка доступной памяти и предел 16; если задач OCR меньше трёх, по умолчанию они выполняются последовательно. Примерно 1 GB на обработчик — оценка, а не ограничение памяти. Явно заданное число обработчиков может превышать автоматический предел.
В скриптах, запускающих обработчики-процессы, защищайте запуск основного кода условием main:
from occular import OCRPipeline

def main():
    reader = OCRPipeline()
    pages = reader.process_pdf("scan.pdf", workers=2)
    print(len(pages))

if __name__ == "__main__":
    main()
Запущенные процессы импортируют основной скрипт. Если процессы небезопасны или недоступны, библиотека может использовать потоки с пределом 8. Пользовательские компоненты реестра могут влиять на это поведение. get_optimal_workers() — простой помощник по числу CPU, а не автоматический планировщик с учётом памяти.
CUDA использует те же веса ONNX и может перейти на CPU. Список доступных провайдеров ONNX не доказывает, что конкретная сессия запустилась на CUDA. Несколько процессов GPU создают дубли сессий и расходуют больше видеопамяти. Не смешивайте onnxruntime и onnxruntime-gpu в одном окружении.
Пути кеша, локальные замены и воспроизводимость
Большинство файлов моделей берётся из Shivin11/occular-ocr на Hugging Face. Русская языковая модель находится в Shivin11/occular-lm-ru, модели отдельных языков — в Shivin11/occular-lm-cyr, стандартная UVDoc — в Shivin11/occular-uvdoc. Подготовка одного базового распознавателя не подготавливает все дополнительные функции.
| Переменная | Назначение |
|---|---|
HF_HOME |
Корень кеша Hugging Face |
HF_HUB_OFFLINE=1 |
Использовать существующий кеш без сетевых запросов к Hub |
OCCULAR_LM_DIR |
Папка русской модели с compact_lm.npz и unigrams.txt
|
OCCULAR_CYR_LM_DIR |
Подпапки отдельных языков с этими файлами языковых моделей |
OCCULAR_WEIGHTS_REVISION |
Ревизия, передаваемая основным загрузчиком весов |
Для основных весов приоритет имеют локальные файлы пакета в occular/weights/. При копировании сохраняйте полную структуру кеша и файлы, на которые указывают символические ссылки. Запускайте OCR на типичных изображениях со всеми функциями и языками, нужными без сети; одного model_info() недостаточно для полной проверки готовности.
Основные веса по умолчанию скачиваются из незафиксированной ревизии Hub, поэтому версия пакета сама по себе не фиксирует все модели. Переменная ревизии не глобальная: русская языковая модель и UVDoc находят файлы отдельно, а загрузки кириллических языковых моделей используют её повторно. SHA коммита одного репозитория обычно не подходит другому. Для строгой воспроизводимости сохраняйте точные файлы и локальные замены.
Это руководство описывает 0.5.1, опубликованный коммит 5dbd162. Реализация: конвейер, публичный API, настройки, модели.
Лицензия исходного кода, условия для весов и лицензии зависимостей действуют отдельно.