Repository navigation
Troubleshooting RU
🌐 English · Русский
Установите 0.5.1 и скачайте примеры.
Найдите наиболее похожий симптом. Меняйте по одному параметру, чтобы видеть, что помогло.
Вероятно, в нём старый OCR-слой. Запросите новое распознавание →
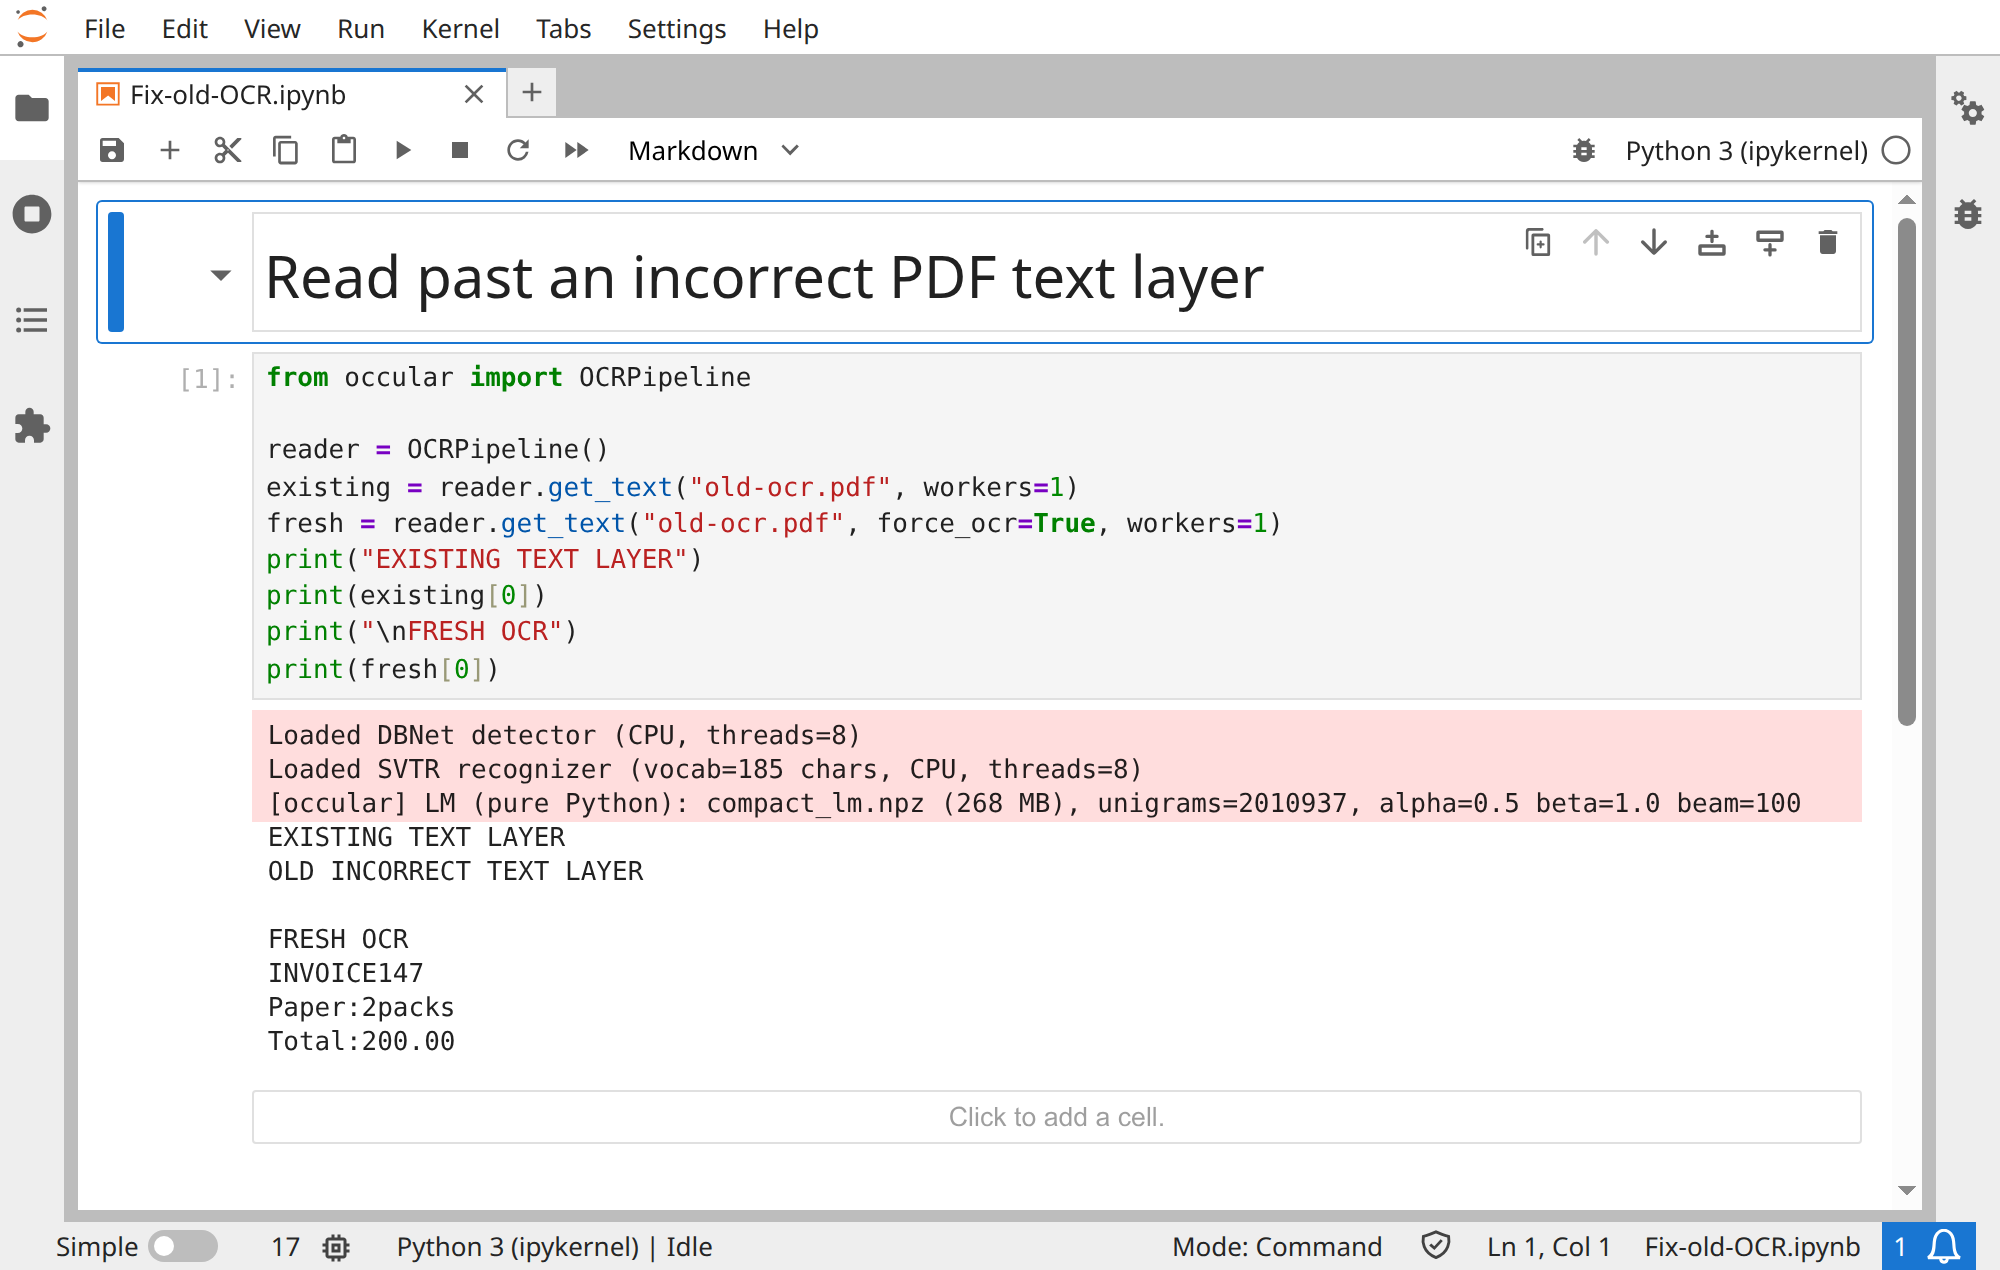
В этом синтетическом PDF специально создан неверный скрытый текстовый слой. На изображении страницы написано INVOICE 147, но извлечение возвращает посторонний старый текст:
from occular import OCRPipeline

reader = OCRPipeline()
existing = reader.get_text("old-ocr.pdf", workers=1)
fresh = reader.get_text("old-ocr.pdf", force_ocr=True, workers=1)
print("EXISTING TEXT LAYER")
print(existing[0])
print("\nFRESH OCR")
print(fresh[0])
Фактический вывод:
EXISTING TEXT LAYER
OLD INCORRECT TEXT LAYER

FRESH OCR
INVOICE147
Paper:2packs
Total:200.00
Новый OCR читает видимый счёт и сохраняет настоящие ошибки распознавания — пропущенные пробелы. Он возвращает данные, не меняя PDF.
Открыть настоящий запуск в Jupyter: весь код виден
Оставьте reading_order=True, как по умолчанию. Для PDF проверьте, не извлекается ли готовый текст вместо запуска OCR. Как работает порядок чтения →
Попробуйте orientation=True. Для наклонённого скана deskew уже включён. Три способа выровнять страницу →
Используйте tables=True. Если нужны ячейки для приложения, читайте .tables у изображения или page["tables"] у PDF. Пример таблицы →
Проверьте резкость изображения и правильность языка. На нескольких примерах сравните lm=False или более крупный recognizer="svtr_t". Сверяйте важные числа с исходным изображением.
Возможно, строка не была найдена. Проверьте исходное изображение: нет ли размытия, слишком мелкого текста или плохого контраста. Для PDF также проверьте, нет ли неполного готового текстового слоя; принудительное OCR может помочь.
Рамки, уверенность, скорость и установка
- Рамки не совпадают с текстом: предобработка может сдвинуть текст; извлечение PDF и OCR также используют разные единицы. Подробности координат.
- У всех строк уверенность 1.0: готовый текст PDF использует условную оценку. Об уверенности.
-
Медленно или не хватает памяти: попробуйте
workers=1, затем постепенно увеличивайте число обработчиков. Руководство по скорости. - Без интернета не хватает моделей: один раз запустите с нужными настройками при доступной сети и скопируйте весь необходимый кеш. Работа без интернета.
-
Параметр не принимается: проверьте страницу API; настройки PDF относятся к
process_pdf(). -
Ошибка установки или импорта: используйте чистое виртуальное окружение и выполните
python -m pip check. Не смешивайте CPU/GPU-пакеты ONNX Runtime или несколько дистрибутивов OpenCV.
Всё ещё не получается? Создайте сообщение об ошибке с небольшим воспроизводимым примером, вашей командой или кодом и сообщением об ошибке. Синтетический пример или файл с удалёнными личными данными поможет показать ожидаемый результат.