Repository navigation
PDFs and coordinates RU
🌐 English · Русский
Установите 0.5.1 и скачайте примеры.
PDF может содержать выделяемый текст, сканы или и то и другое. Occular выбирает способ обработки для каждой страницы:
- Текст уже есть? Извлечь его.
- Страница — изображение? Запустить OCR.
from occular import ocr

for text in ocr("text.pdf"):
    print(text)
Возвращается по одной строке на страницу.
Одна и та же синтетическая страница доступна как выделяемый текст и как скан. Поле method каждой страницы показывает выбранный путь:
from occular import OCRPipeline

reader = OCRPipeline()
for filename in ["text.pdf", "scan.pdf"]:
    pages = reader.process_pdf(filename, workers=1)
    for page in pages:
        print(filename, "page", page["page"], "method:", page["method"])
        print(page["results"][0]["text"])
pages = reader.process_pdf("text.pdf", force_ocr=True, workers=1)
print("Forced recognition:", pages[0]["method"])
print(pages[0]["results"][0]["text"])Выбранные строки фактического вывода; текст заголовка после каждого метода здесь опущен:
text.pdf page 1 method: text
scan.pdf page 1 method: ocr
Forced recognition: ocr
text означает извлечение, ocr — распознавание отрисованного изображения. В блокноте после каждого результата также напечатан возвращённый заголовок.
Открыть настоящий запуск в Jupyter: весь код виден
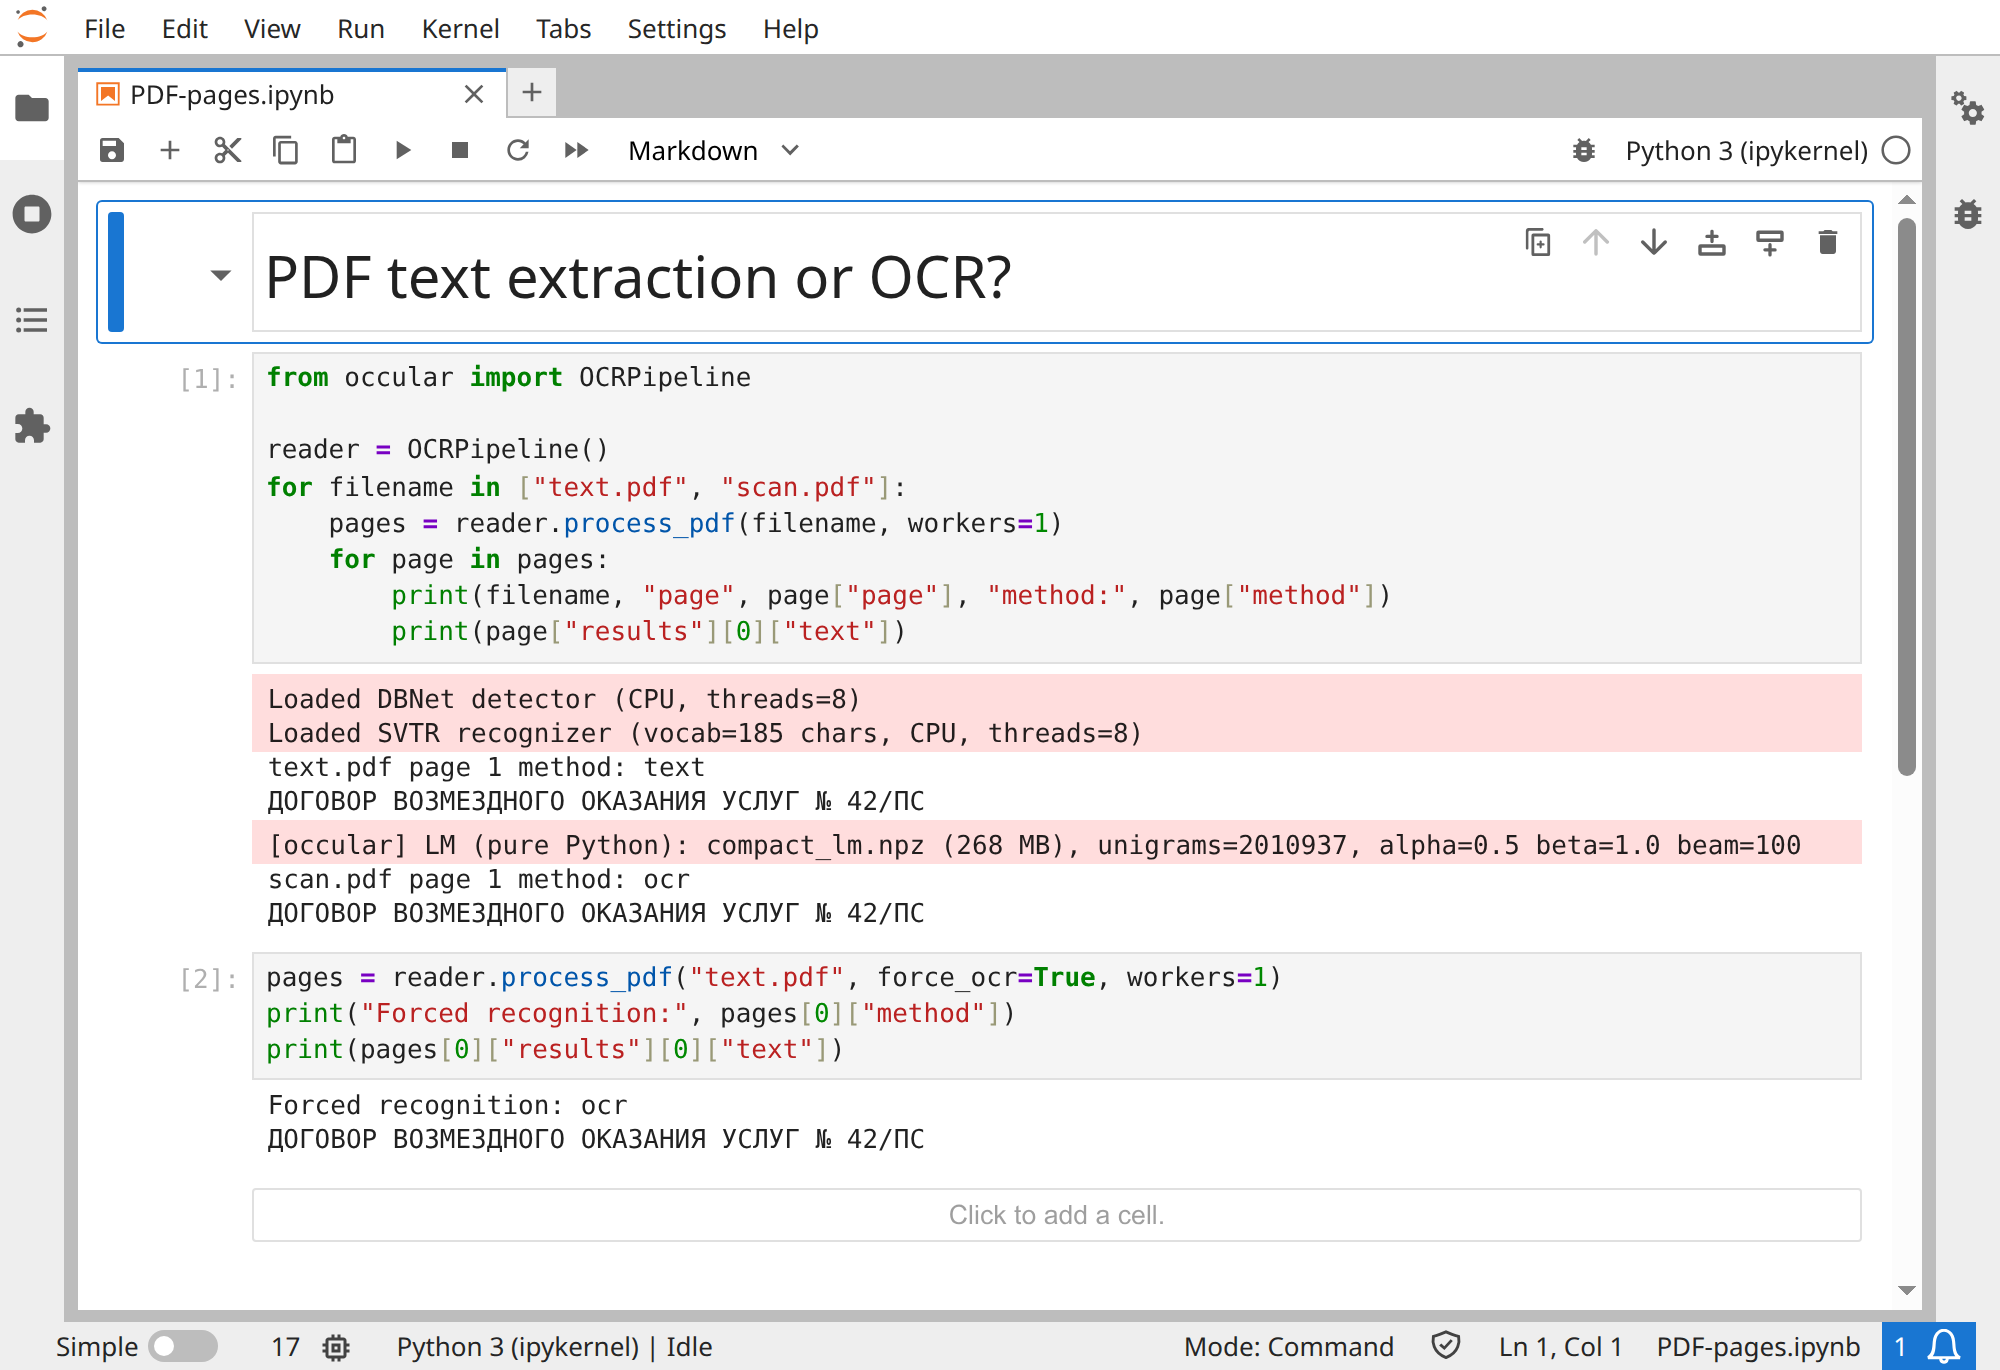
Скачать блокнот · text.pdf · scan.pdf
Старый OCR-слой может содержать ошибки. По умолчанию Occular извлекает этот текст, а не исправляет его. Чтобы заново прочитать изображение страницы:
from occular import OCRPipeline

reader = OCRPipeline()
pages = reader.process_pdf("old-ocr.pdf", force_ocr=True, workers=1)
for page in pages:
    for line in page["results"]:
        print(line["text"])
Вернутся свежие результаты OCR. Новый PDF с текстовым поиском при этом не сохраняется.
process_pdf() также принимает workers и dpi. Начните с 300 DPI и одного обработчика; настройте скорость здесь.
Рамки и страницы, частично состоящие из скана
Проверьте page["method"]: "text" означает извлечение, "ocr" — распознавание отрисованного изображения.
Любой непустой извлечённый текст может включить путь извлечения, даже если остальная страница — скан. Для таких смешанных страниц тоже полезен force_ocr=True.
Единицы координат различаются: для извлечённого текста используются пункты PDF, для OCR — пиксели обработанного изображения. Руководство по координатам →
В 0.5.1 путь OCR для PDF не применяет коррекцию ориентации страницы и выравнивание изгиба. При необходимости используйте рецепт с изображениями страниц →