Repository navigation
Recipes RU
🌐 English · Русский
Сохраняйте строки OCR изображения и таблицы в JSON или превращайте таблицу в CSV для электронной таблицы. JSON сохраняет сведения об объединении ячеек; CSV хранит прямоугольную сетку.
Установите 0.5.1 и скачайте примеры.
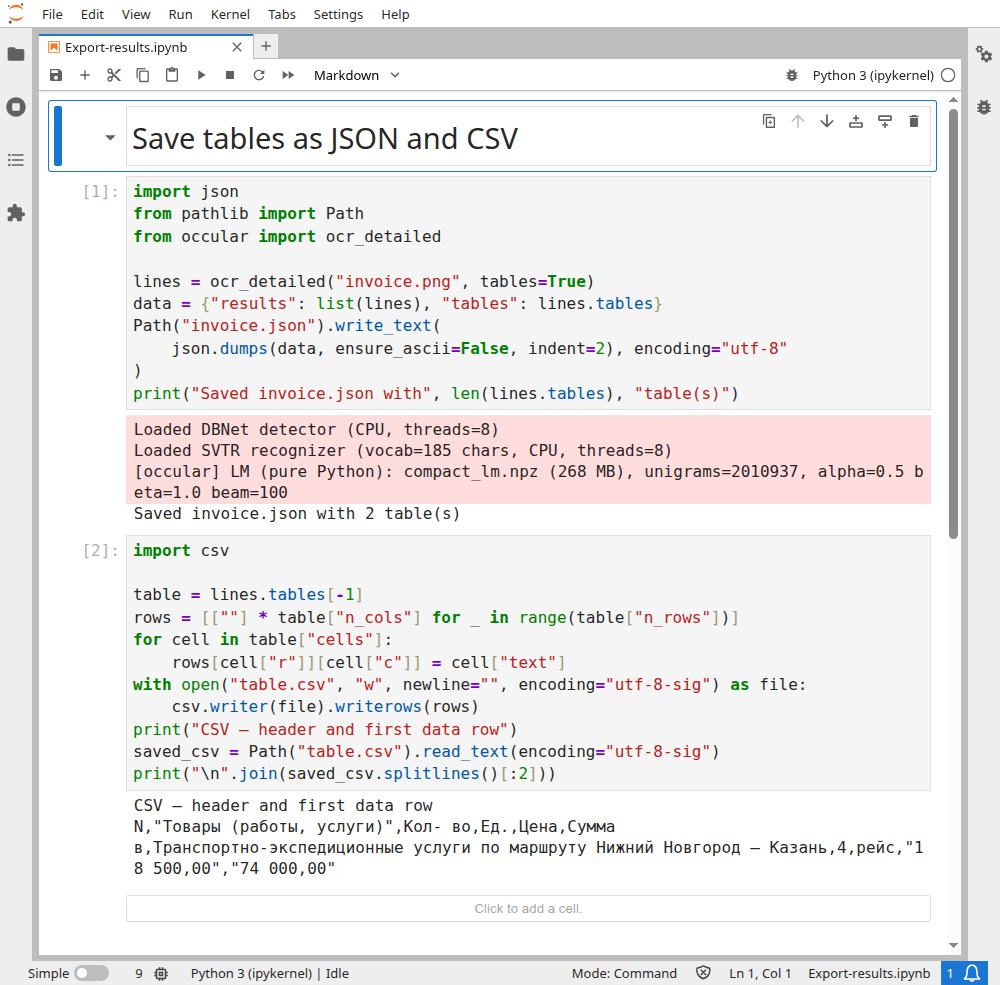
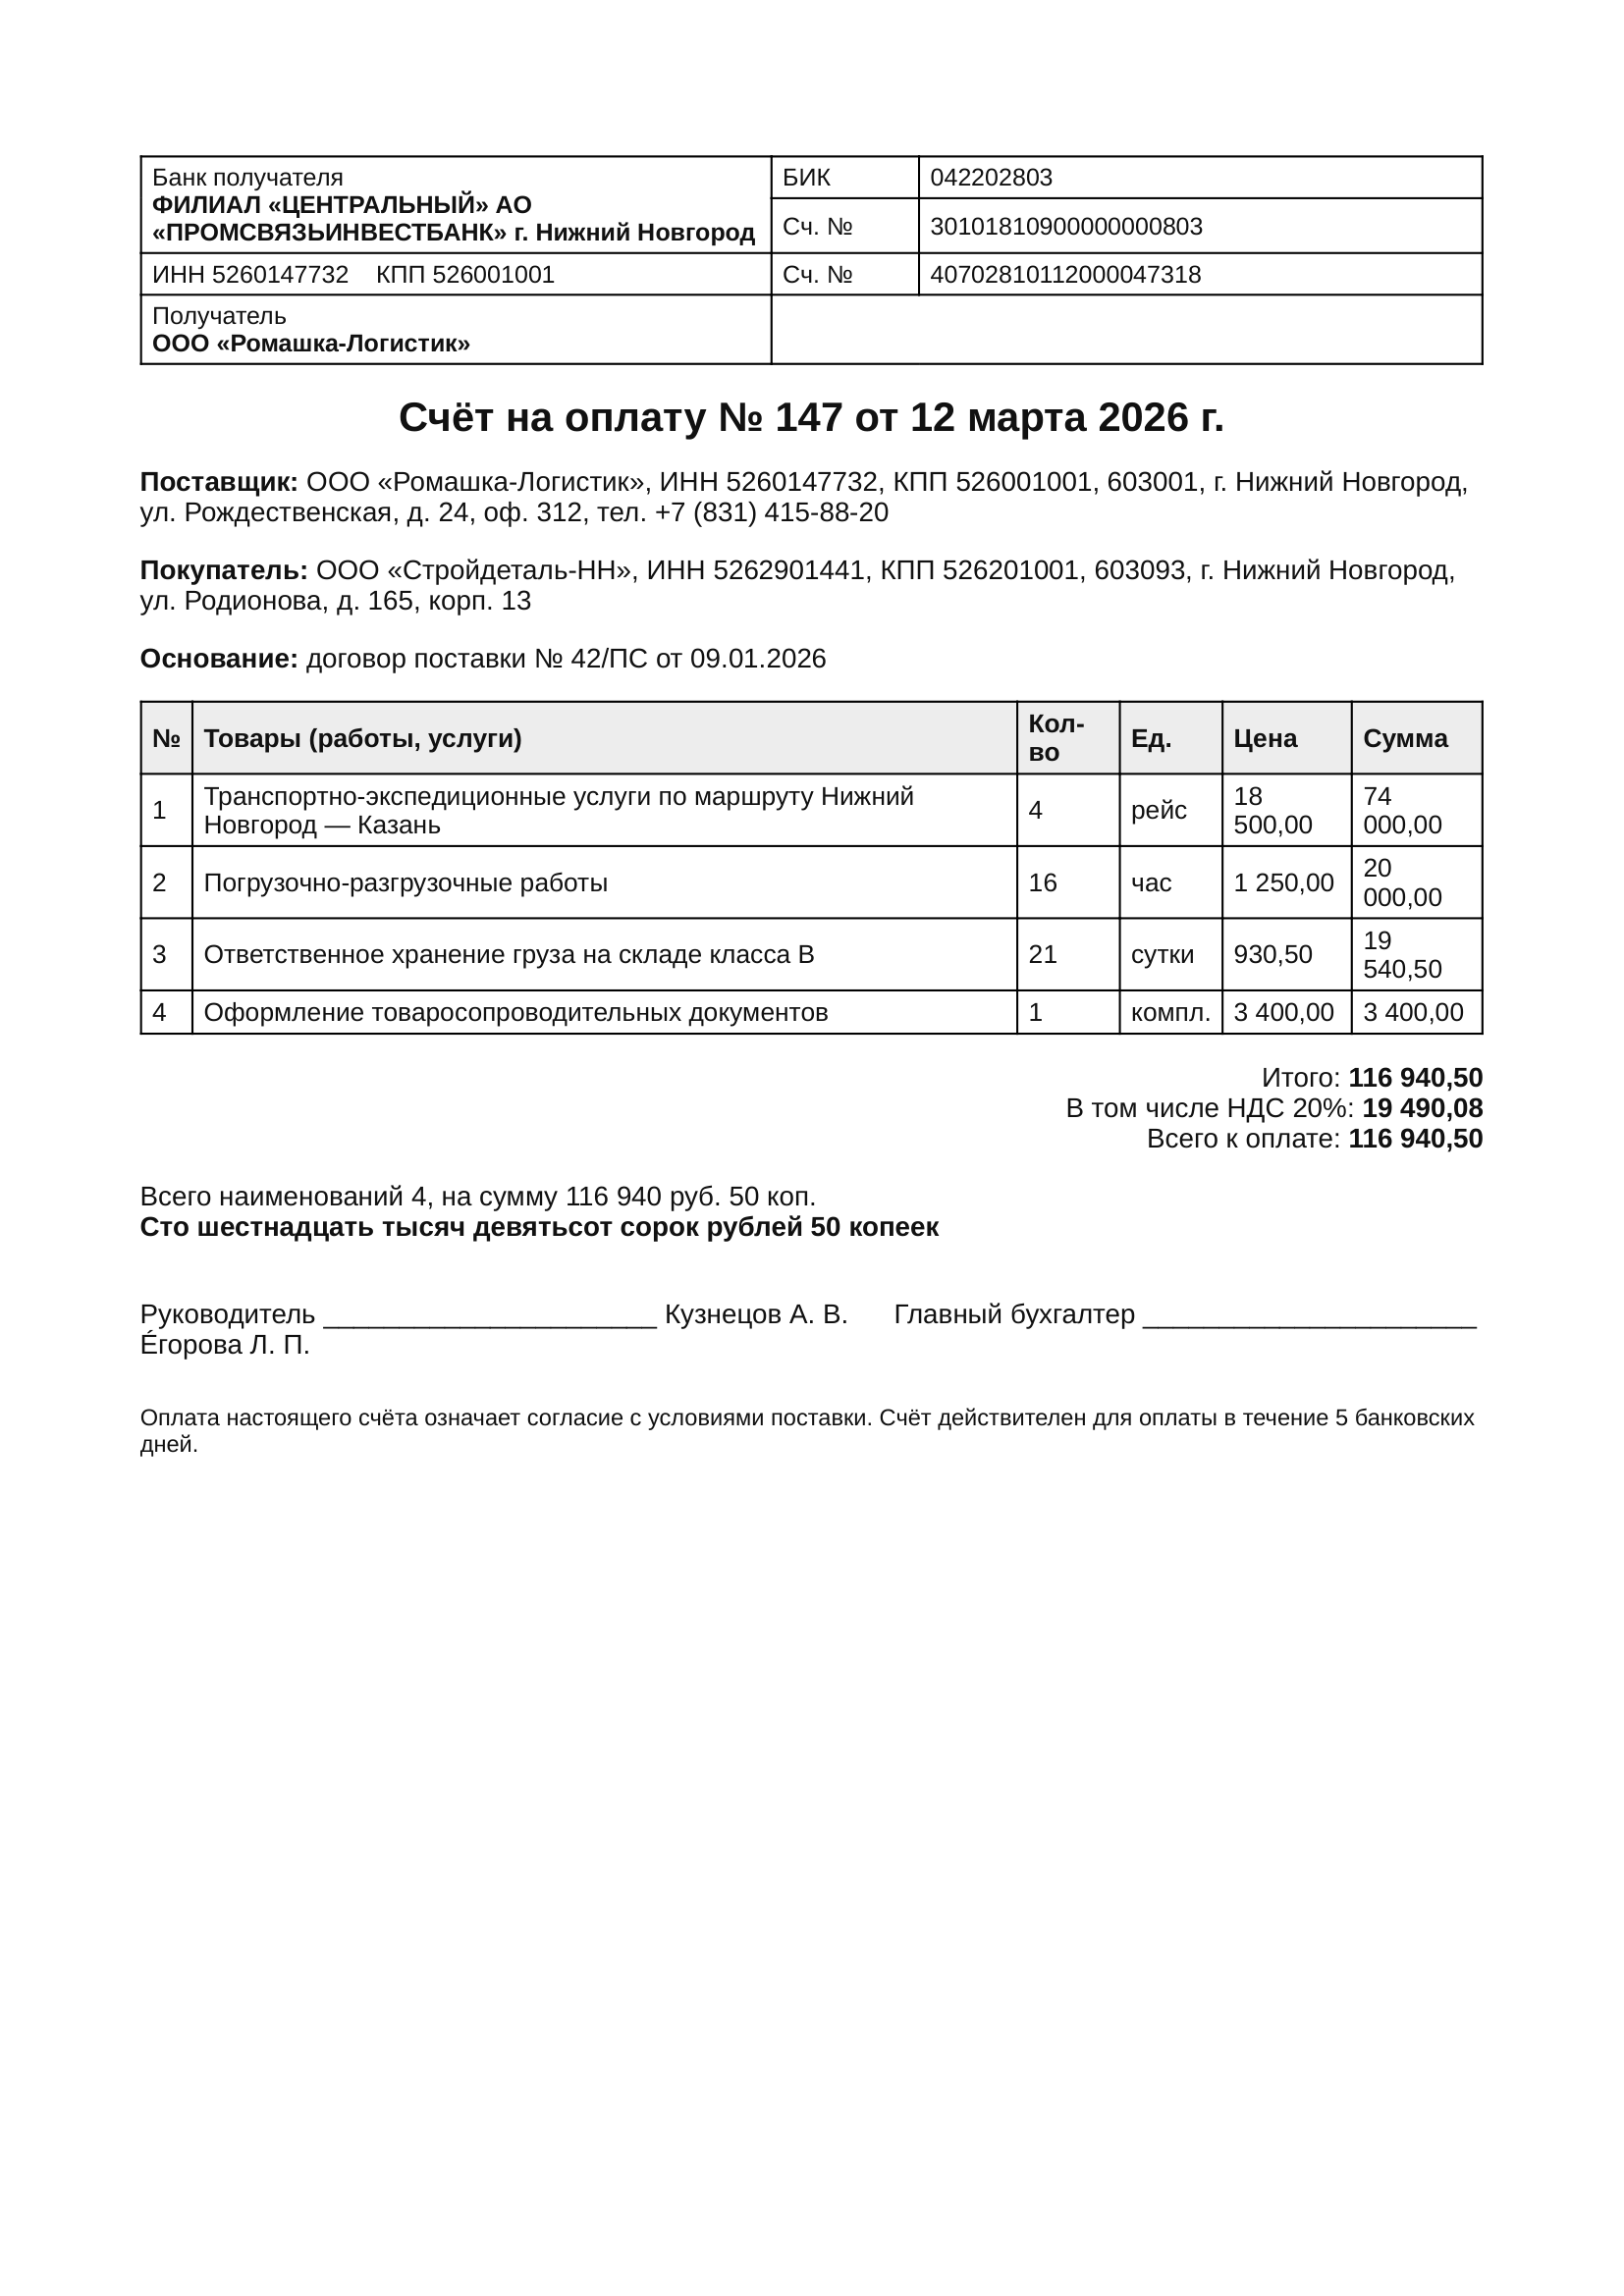
Блокнот объединяет два рецепта ниже и выводит CSV последней таблицы счёта. Выбранные строки фактического вывода — заголовок и первая строка данных:
N,"Товары (работы, услуги)",Кол- во,Ед.,Цена,Сумма
в,Транспортно-экспедиционные услуги по маршруту Нижний Новгород — Казань,4,рейс,"18 500,00","74 000,00"
Номер строки прочитан как в вместо 1; ошибка сохранена. В этом экспорте deskew работает по умолчанию; в примере с рамками таблицы он отключён, поэтому текст может отличаться. Запятые внутри кавычек — экранирование CSV. Сверяйте текст и числа со счётом до импорта в бухгалтерскую программу или другое приложение.
Открыть настоящий запуск в Jupyter: весь код виден
Скачать готовые к запуску примеры.
import json
from pathlib import Path
from occular import ocr_detailed

lines = ocr_detailed("invoice.png", tables=True)
data = {"results": list(lines), "tables": lines.tables}
Path("invoice.json").write_text(
    json.dumps(data, ensure_ascii=False, indent=2), encoding="utf-8"
)
Добавляйте tables явно: сериализация одного lines потеряет структуру таблиц в результате для изображения.
import csv
from occular import ocr_detailed

lines = ocr_detailed("invoice.png", tables=True)
for number, table in enumerate(lines.tables, start=1):
    rows = [[""] * table["n_cols"] for _ in range(table["n_rows"])]
    for cell in table["cells"]:
        rows[cell["r"]][cell["c"]] = cell["text"]
    with open(f"table-{number}.csv", "w", newline="", encoding="utf-8-sig") as f:
        csv.writer(f).writerows(rows)
Получится по одному CSV на каждую найденную таблицу. Текст объединённой ячейки записывается в её верхнюю левую позицию. Если нужны сведения об объединении, сохраните и JSON.
В 0.5.1 ориентация и выравнивание изгиба применяются через обработку изображений. Сначала отрисуйте каждую страницу, затем обработайте её как изображение:
Показать пример преобразования PDF в изображения
import tempfile
from pathlib import Path
try:
    import pymupdf
except ImportError:
    import fitz as pymupdf
from occular import OCRPipeline, Settings

reader = OCRPipeline(Settings(orientation=True, unwarp=True))
with pymupdf.open("photos.pdf") as doc:
    with tempfile.TemporaryDirectory() as folder:
        for number, page in enumerate(doc, start=1):
            image = Path(folder) / f"page-{number}.png"
            page.get_pixmap(dpi=300, colorspace=pymupdf.csRGB, alpha=False).save(str(image))
            print(reader.get_text(str(image)))
Этот код печатает текст. Он не создаёт новый PDF с текстовым поиском, а все возвращённые рамки относятся к обработанным изображениям.