Repository navigation
Python API RU
🌐 English · Русский
Обычный текст подходит для поиска и экспорта, подробные записи строк — для проверки или наложения рамок, а переиспользуемый конвейер — для повторной обработки и настройки PDF.
Установите 0.5.1 и скачайте примеры.
Этот полный пример выводит три записи строк. Округление меняет только отображение:
from occular import ocr_detailed

lines = ocr_detailed("receipt.jpg")
for line in lines[:3]:
    print(line["text"])
    print("Confidence:", round(line["confidence"], 3))
    corners = [[round(x, 1), round(y, 1)] for x, y in line["quad"]]
    print("Corners:", corners)
    print()
Первая запись из фактического вывода:
СУПЕРМАРКЕТ «ВОЛГА-МАРКЕТ»
Confidence: 0.996
Corners: [[248.6, 309.4], [674.5, 309.4], [674.5, 330.3], [248.6, 330.3]]
quad задаёт положение строки; confidence помогает выбрать, что проверить раньше, но не является вероятностью правильности текста. Ограничения уверенности.
Открыть настоящий запуск в Jupyter: весь код виден
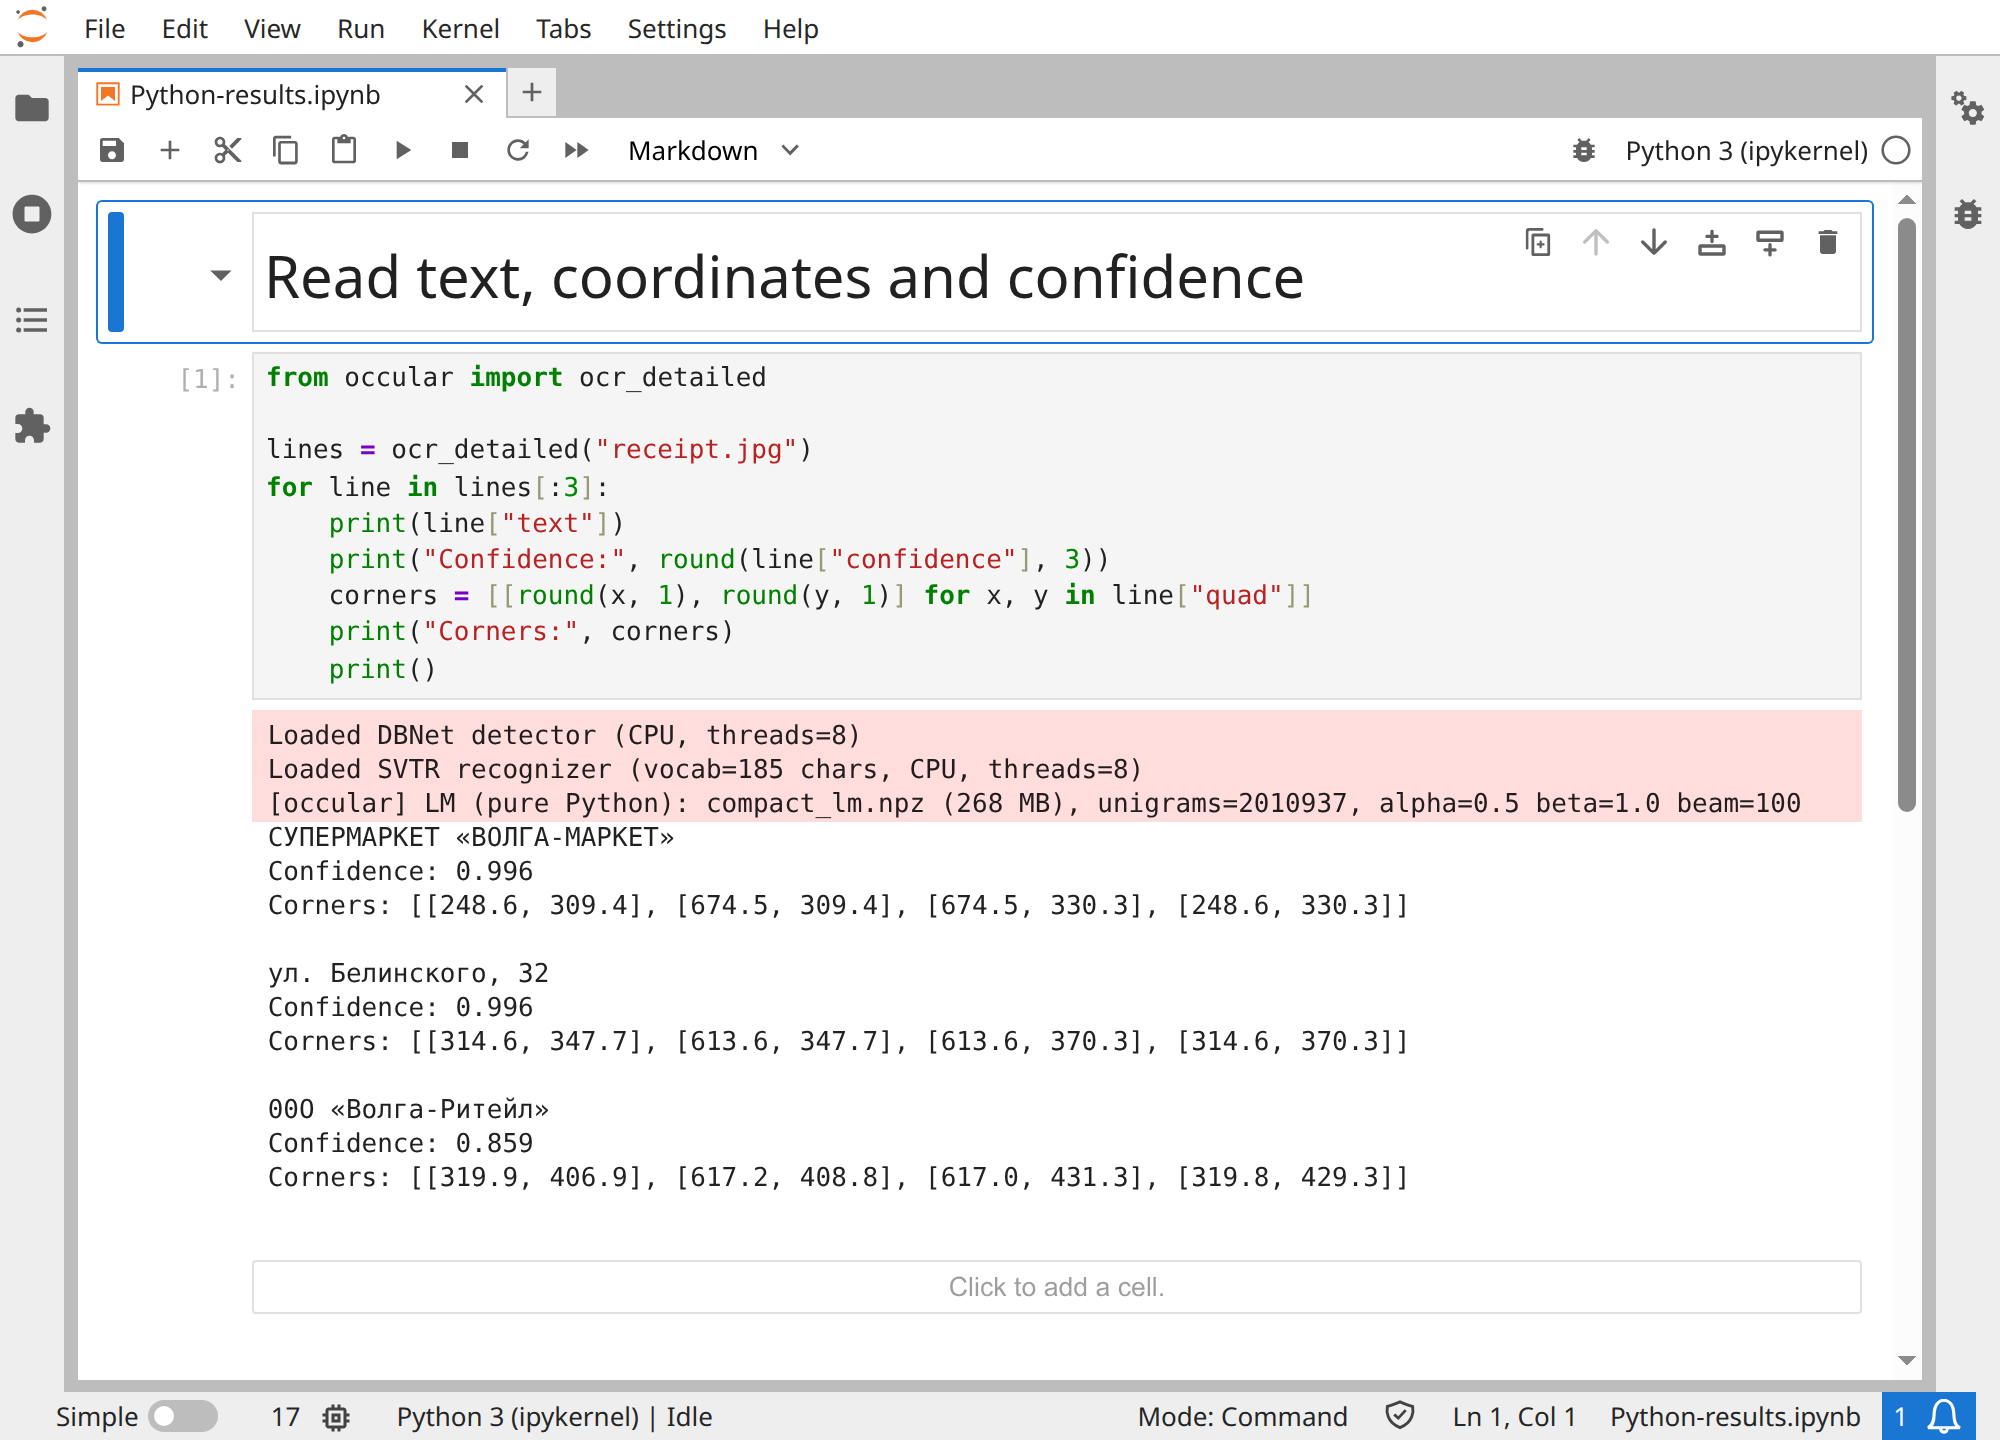
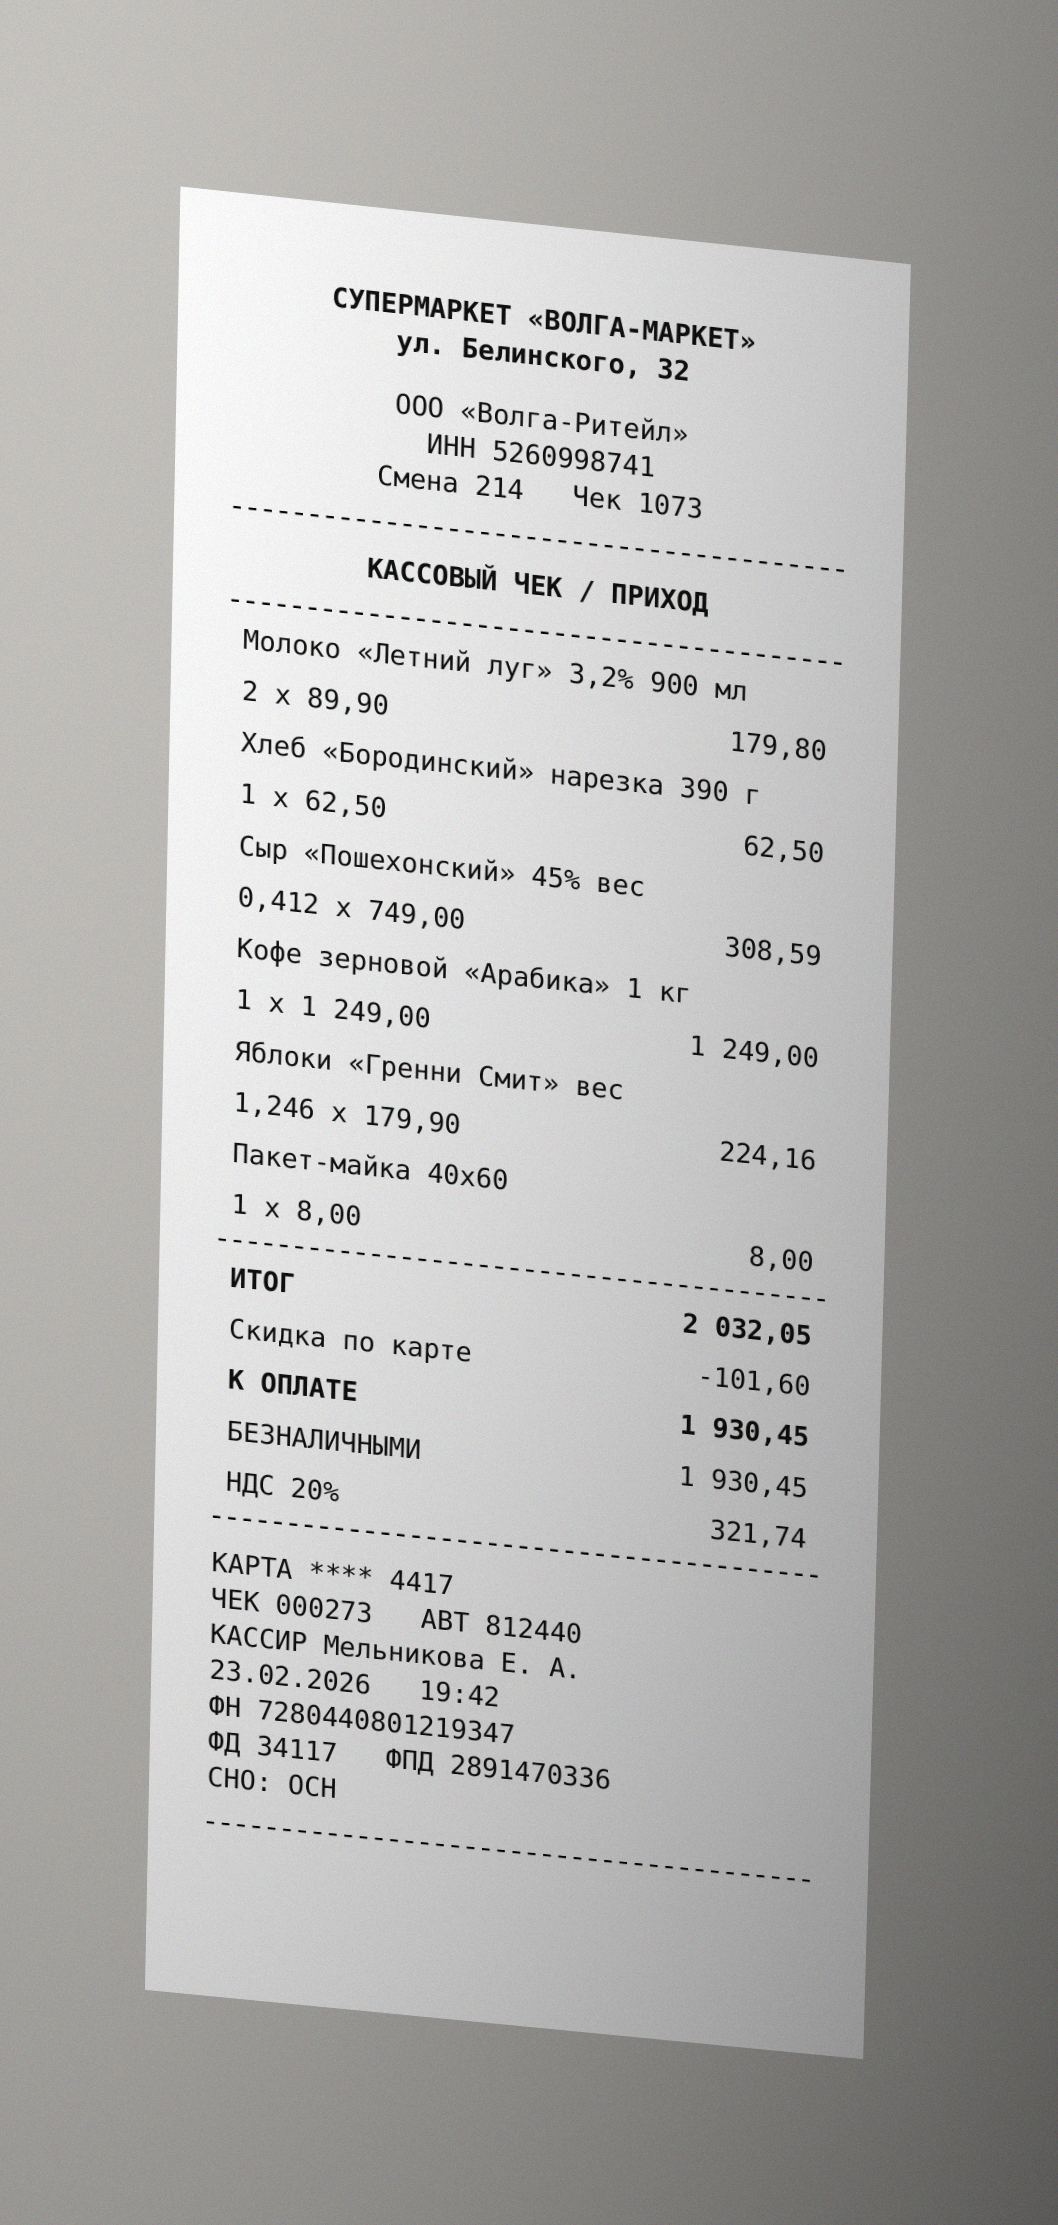
from occular import ocr

text = ocr("receipt.jpg")
Для изображения возвращается одна строка. Для PDF — список строк, по одной на страницу.
from occular import ocr_detailed

for line in ocr_detailed("receipt.jpg"):
    print(line["text"])
    print(line["quad"])        # four corners of the text line
    print(line["confidence"])  # recognition score
quad — четыре точки [x, y]. Координаты изображения относятся к нему после предобработки. Подробнее о координатах →
from occular import OCRPipeline, Settings

reader = OCRPipeline(Settings(tables=True))
lines = reader.process_image("invoice.png")
При обработке многих файлов создайте конвейер один раз. Используйте его и для настройки обработки PDF:
from occular import OCRPipeline

reader = OCRPipeline()
pages = reader.process_pdf("scan.pdf", dpi=300, force_ocr=True, workers=1)
Каждая страница содержит page, method и results; при включённых таблицах — ещё и tables.
Все настройки и значения по умолчанию
| Настройка | По умолчанию | Пояснение |
|---|---|---|
deskew |
True |
Коррекция небольшого наклона и отдельных строк |
orientation |
False |
Поворот страницы-изображения в правильную ориентацию |
unwarp |
False |
Выравнивание изогнутой страницы-изображения |
reading_order |
True |
Порядок колонок и блоков |
tables |
False |
Восстановление ячеек таблиц |
languages |
None |
Русский/английский по умолчанию или другой язык |
lm |
True |
Использование языкового контекста |
gpu |
False |
Запрос CUDA |
num_threads |
None |
Автоматически, до 8 доступных логических процессоров |
recognizer |
None |
По умолчанию svtr_lcnet; альтернатива — svtr_t
|
detector |
None |
Стандартный зарегистрированный детектор |
ocr() и ocr_detailed() принимают перечисленные параметры, кроме unwarp и detector. Для них используйте Settings вместе с OCRPipeline.
dpi, force_ocr и workers относятся к process_pdf(), а не к Settings или ocr().
Вспомогательные API и необязательные поля результата
Среди публичных вспомогательных API есть LayoutDetector, LayoutRegion, LayoutResult, LAYOUT_LABELS, TableRecognizer, model_info, WEIGHTS_DIR, download_layout, layout_ready, download_reading_order, reading_order_ready, get_optimal_workers и Registry.
Необязательные поля строки: orientation_deg, layout, layout_region, layout_label, table, cell и split. Читайте их через .get(): не каждый путь обработки добавляет все поля.
reader.get_text(path) возвращает текст с использованием настроенного конвейера. Параметры PDF можно передавать ему как именованные аргументы.