Repository navigation
Tables RU
🌐 English · Русский
Установите 0.5.1 и скачайте примеры.
Используйте tables=True, чтобы получить строки, колонки и текст ячеек счёта. Распознавание таблиц по умолчанию выключено. Включайте его, когда важна структура ячеек; если нужен только окружающий текст, достаточно обычного ocr().
ocr(..., tables=True) оформляет найденные таблицы в возвращаемом тексте как Markdown — текстовую таблицу с разделителями |:
from occular import ocr

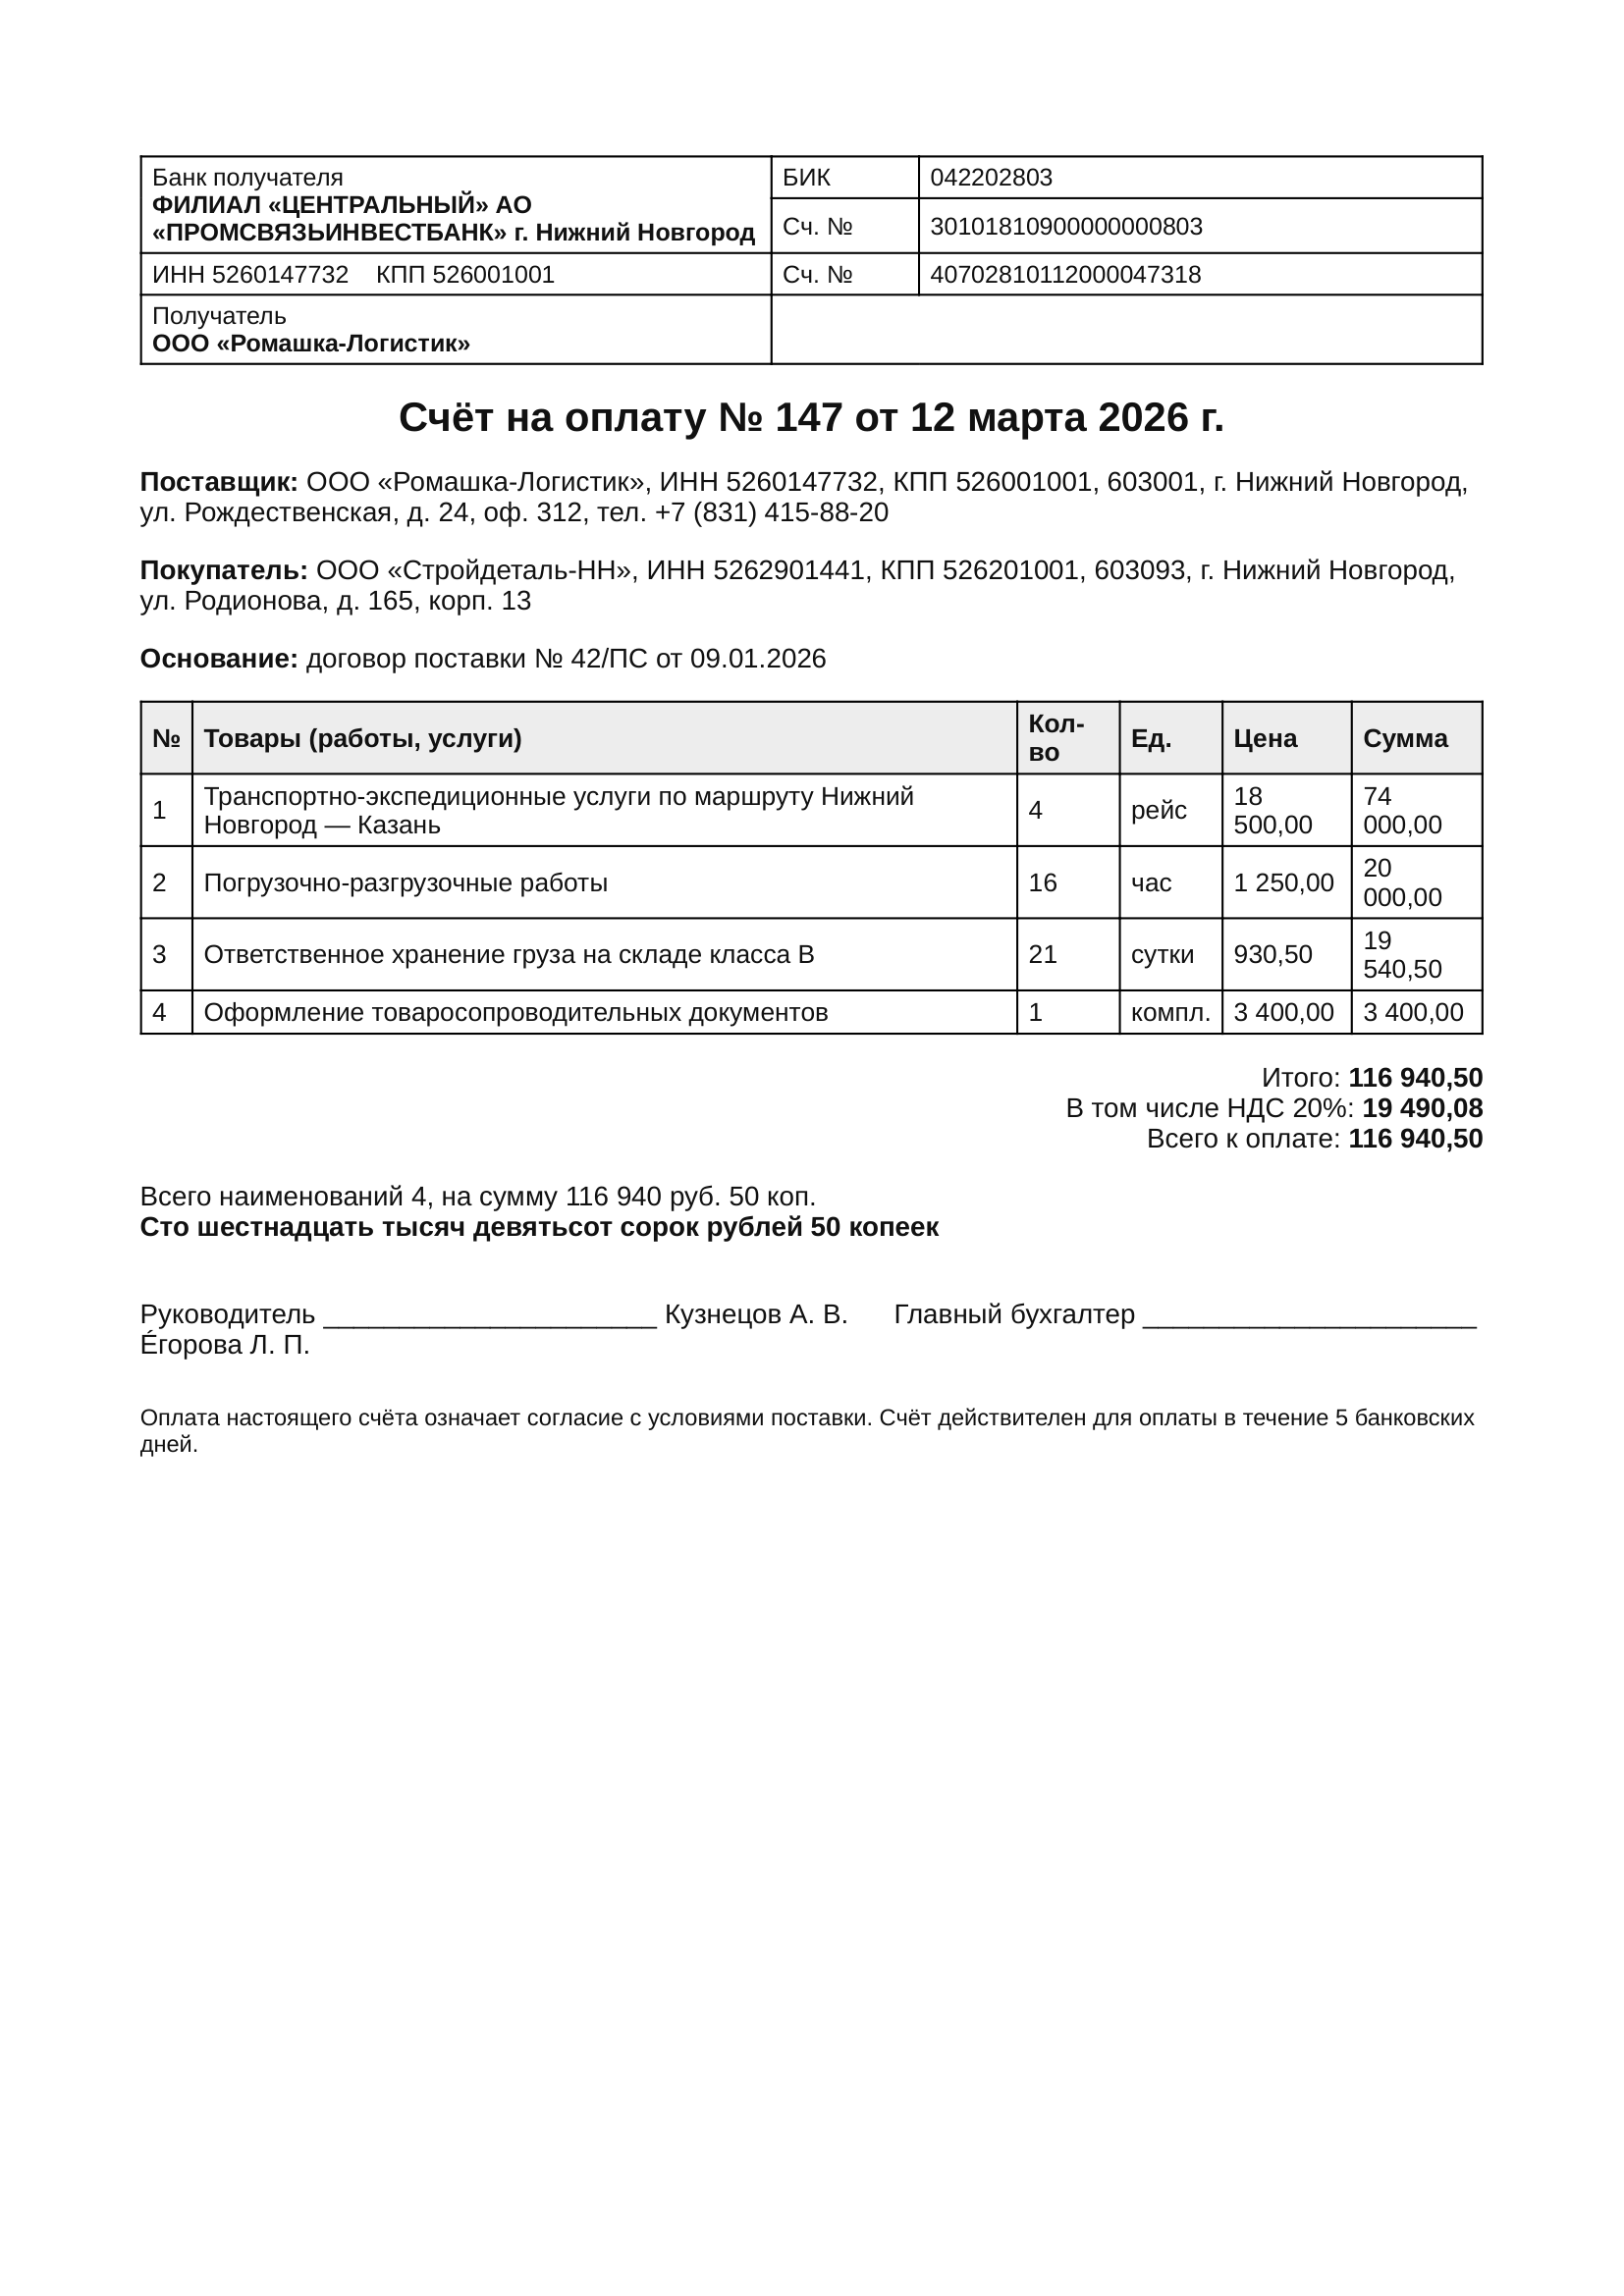
print(ocr("invoice.png", tables=True))На входе таблица банковских реквизитов и таблица позиций. Здесь выбирается последняя возвращённая таблица — в этом примере это таблица позиций:
from occular import ocr_detailed

lines = ocr_detailed("invoice.png", tables=True, deskew=False)
print("Tables found:", len(lines.tables))
table = lines.tables[-1]  # the item table, after the bank-details table
print("Rows:", table["n_rows"], "Columns:", table["n_cols"])
for cell in table["cells"][:12]:
    print(cell["r"], cell["c"], cell["text"])
Фактический вывод: заголовок и первая строка данных:
Tables found: 2
Rows: 5 Columns: 6
0 0 №
0 1 Товары (работы, услуги)
0 2 Кол- во
0 3 Ед.
0 4 Цена
0 5 Сумма
1 0 1
1 1 Транспортно-экспедиционные услуги по маршруту Нижний Новгород — Казань
1 2 4
1 3 рейс
1 4 18 500,00
1 5 74 000,00
В строке 1, колонке 2 находится количество 4; в колонке 4 — цена за единицу 18 500,00; в колонке 5 — сумма 74 000,00. Индексы строк и колонок сохраняют связь между этими значениями. Сравните их с увеличенным фрагментом исходного изображения: заголовком и первой строкой данных, от количества до суммы.
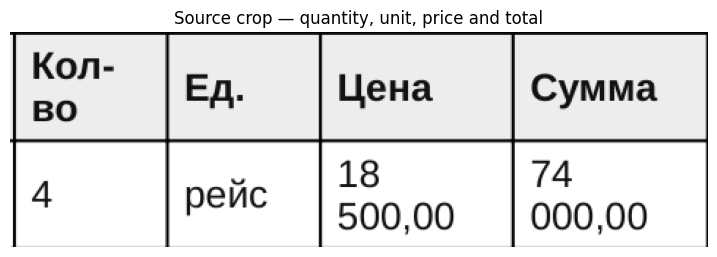
Это структура из 5 строк × 6 колонок. Deskew отключён, чтобы координаты фрагмента совпадали с исходным изображением. На другом документе проверяйте возвращённые рамки, а не рассчитывайте, что таблица позиций окажется последней.
Текстовый API оформляет эту структуру в Markdown. Следующий код выбирает тот же заголовок и строку данных из настоящего результата ocr():
from occular import ocr

text = ocr("invoice.png", tables=True, deskew=False)
print("MARKDOWN — item header and first body row")
for row in text.splitlines():
    if row.startswith("|") and ("Товары" in row or "Транспортно" in row):
        print(row)
MARKDOWN — item header and first body row
| № | Товары (работы, услуги) | Кол- во | Ед. | Цена | Сумма |
| 1 | Транспортно-экспедиционные услуги по маршруту Нижний Новгород — Казань | 4 | рейс | 18 500,00 | 74 000,00 |
Markdown сохраняет позиции строк и колонок, но не сохраняет объединения ячеек. Если приложению нужны сведения об объединении, используйте структуру .tables.
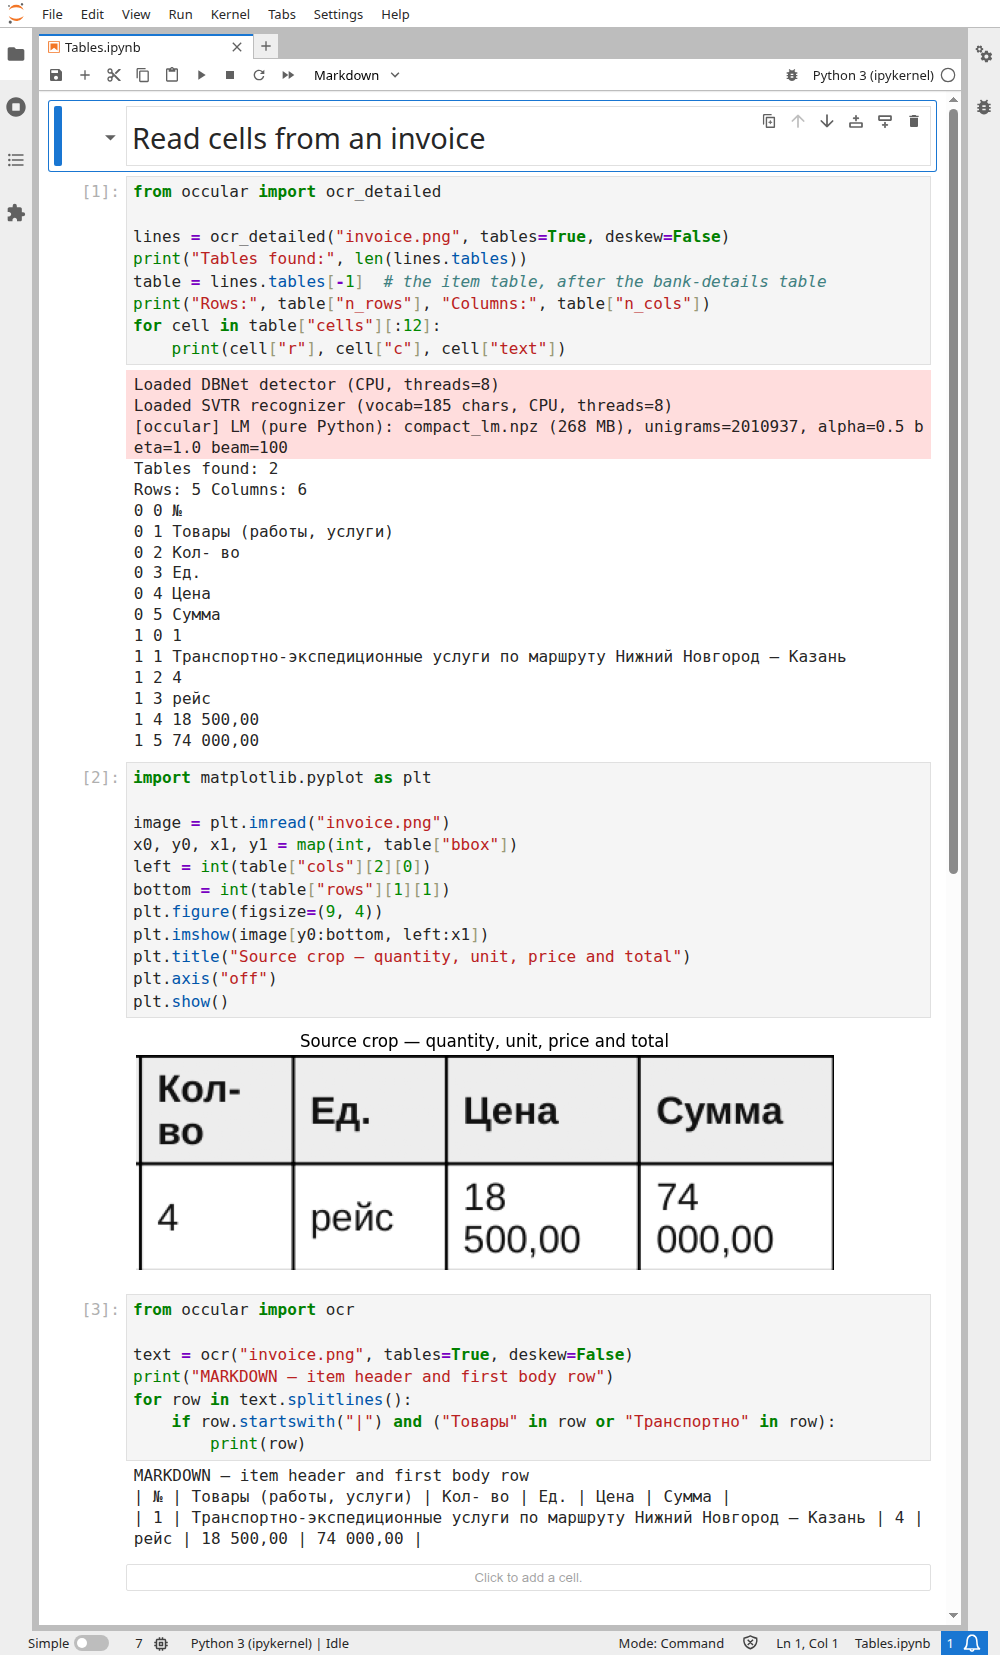
Открыть настоящий запуск в Jupyter: весь код виден
from occular import ocr_detailed

lines = ocr_detailed("invoice.png", tables=True)
for table in lines.tables:
    for cell in table["cells"]:
        print(cell["r"], cell["c"], cell["text"])
r — номер строки, c — номер колонки. Оба отсчитываются от 0. У ячейки, занимающей несколько строк или колонок, также есть rowspan и colspan.
Проверяйте объединённые заголовки и итоги. Даже у найденной таблицы может быть неверная сетка или текст, попавший не в ту ячейку.
Сохранить таблицы в JSON или CSV →
PDF, объединённые ячейки и экспорт в JSON
Для изображений таблицы хранятся в lines.tables. У PDF на каждой странице свой список page["tables"].
Markdown и CSV не сохраняют структуру объединённых ячеек. Если она важна, сохраняйте JSON. Кроме того, json.dumps(lines) теряет атрибут .tables результата для изображения: используйте этот рецепт JSON.