Repository navigation
Preprocessing RU
🌐 English · Русский
Установите 0.5.1 и скачайте примеры.
Для небольшого наклона используйте deskew, для поворота на четверть оборота — orientation, для изогнутых строк — выравнивание изгиба. Эти функции меняют пиксели перед распознаванием, а не исправляют написание слов после него.
| Что на входе | Что выбрать | По умолчанию |
|---|---|---|
| Скан наклонён на несколько градусов | deskew=True |
Включено |
| Всё изображение повёрнуто на 90°, 180° или 270° | orientation=True |
Выключено |
| Текст изгибается у корешка книги | Settings(unwarp=True) |
Выключено |
Начните с коррекции видимой проблемы; для ровных сканов в правильной ориентации обычно достаточно настроек по умолчанию.
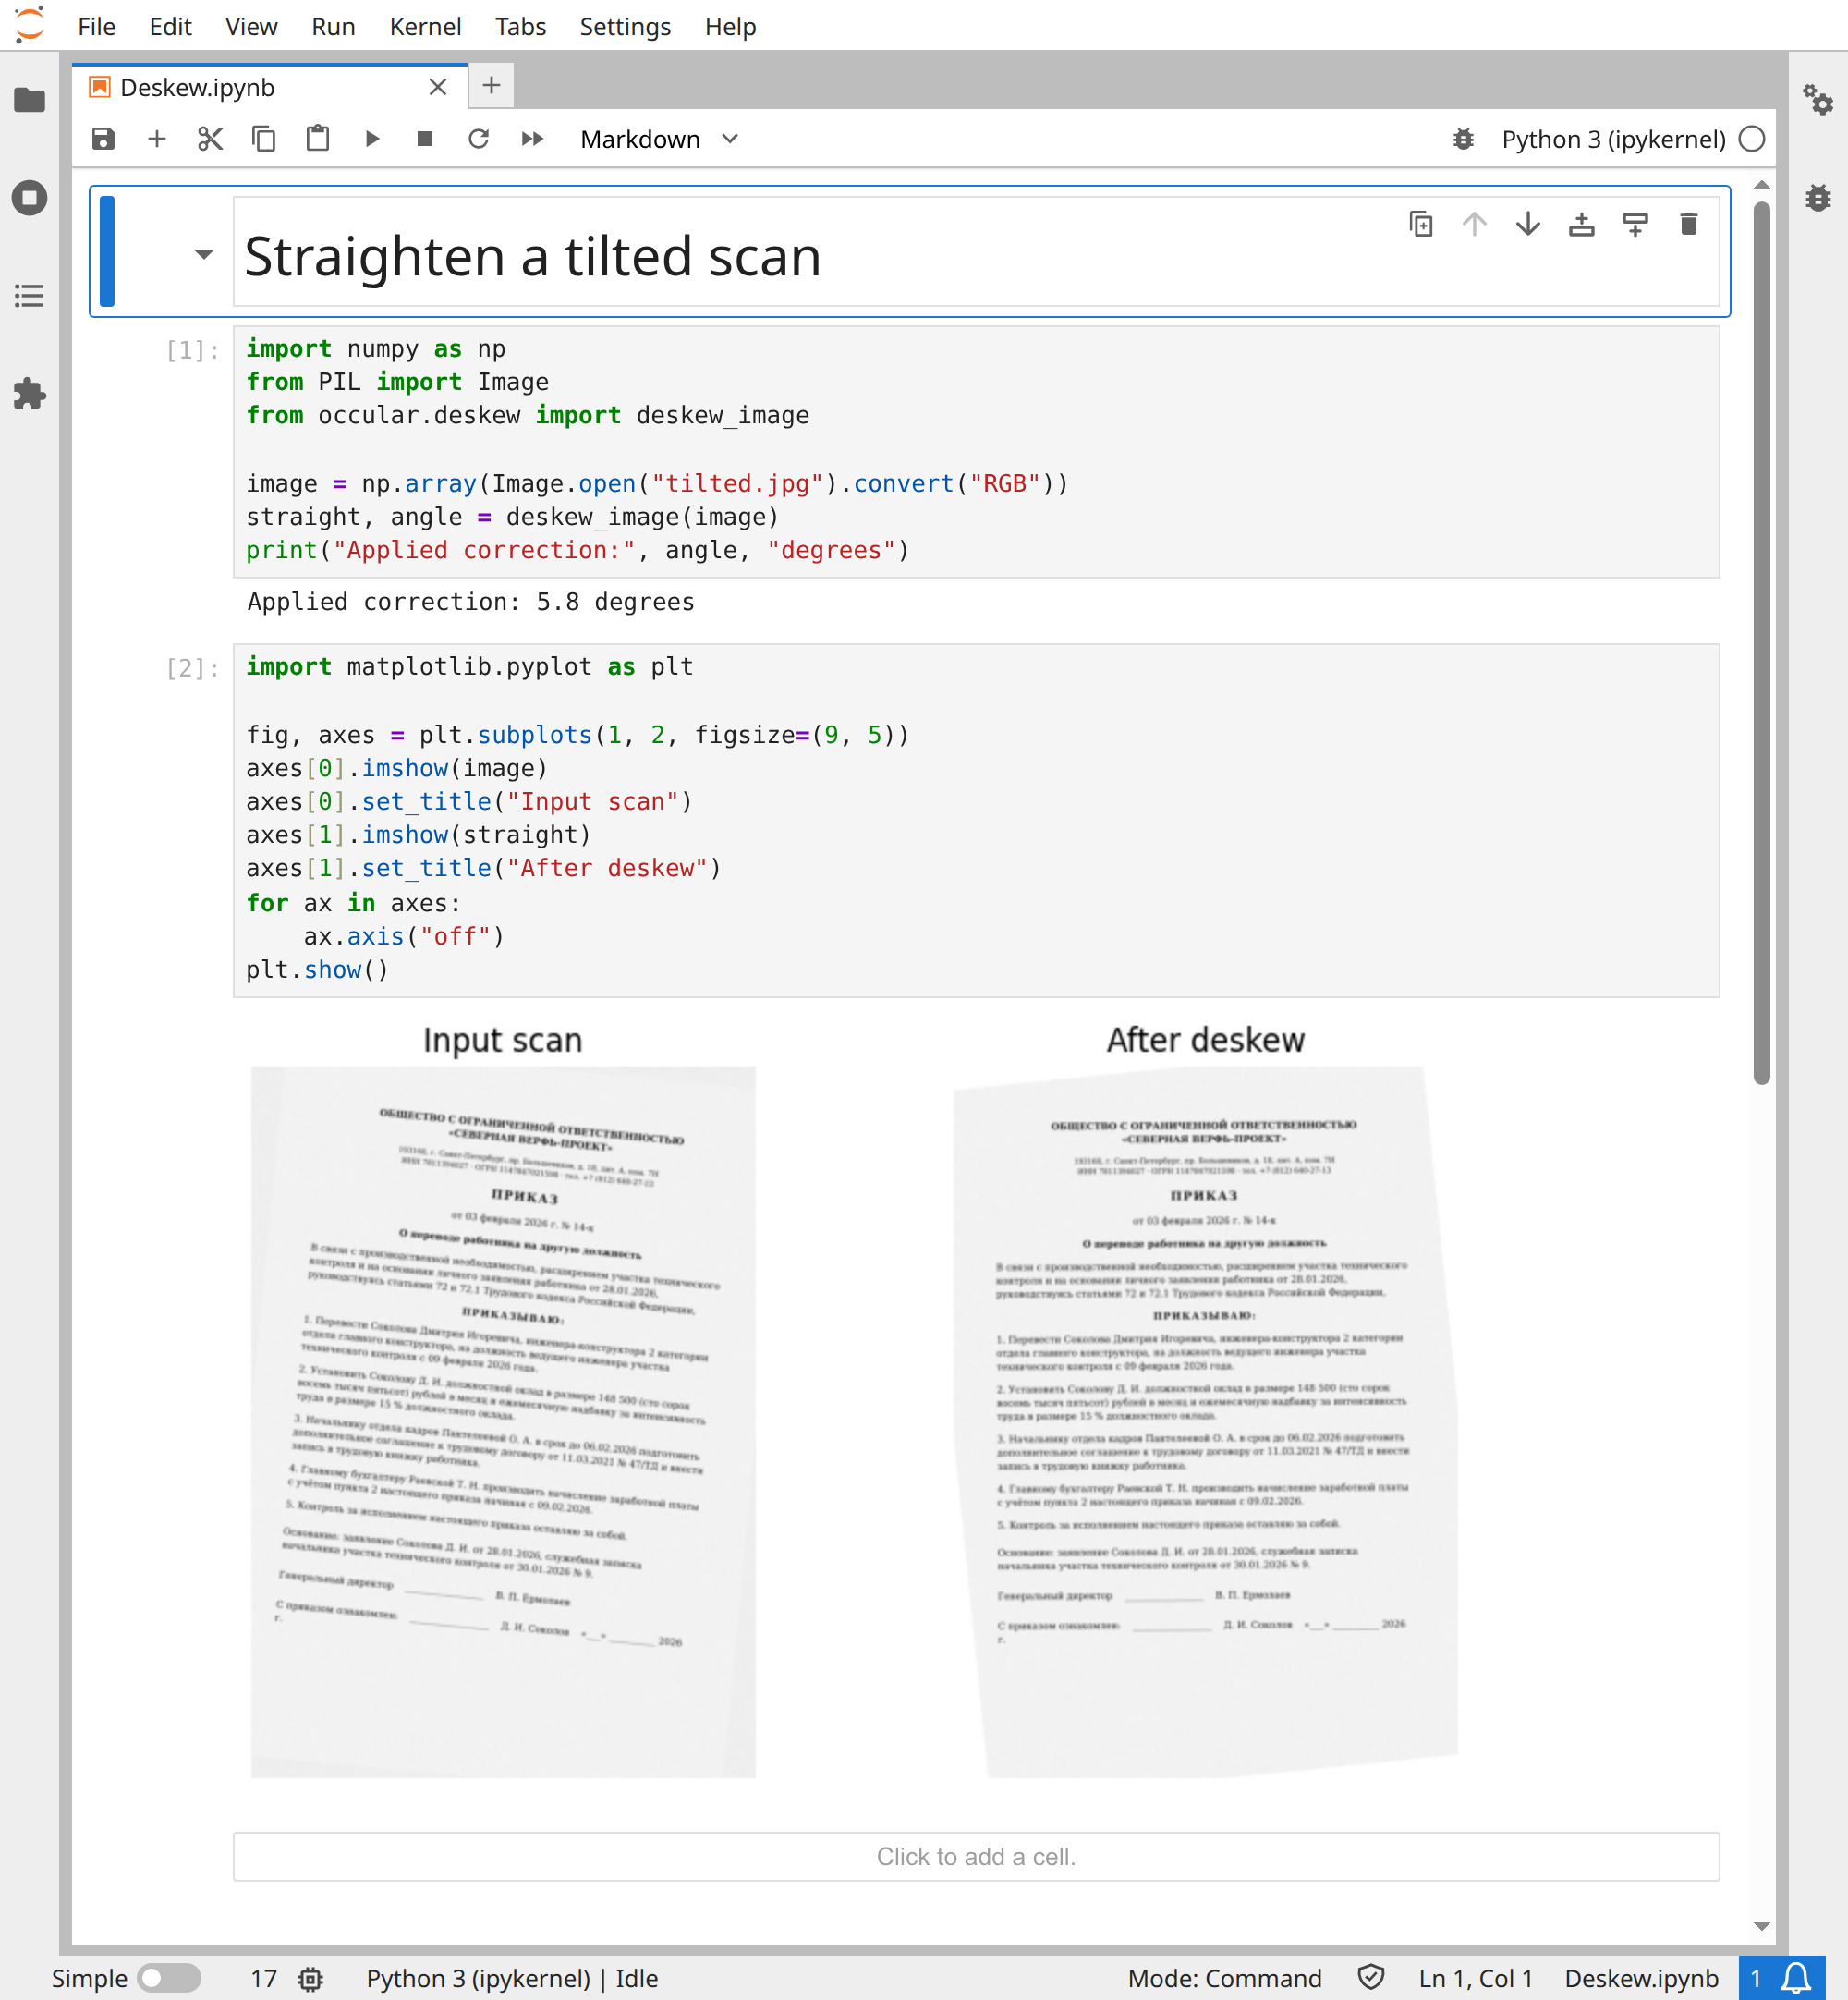
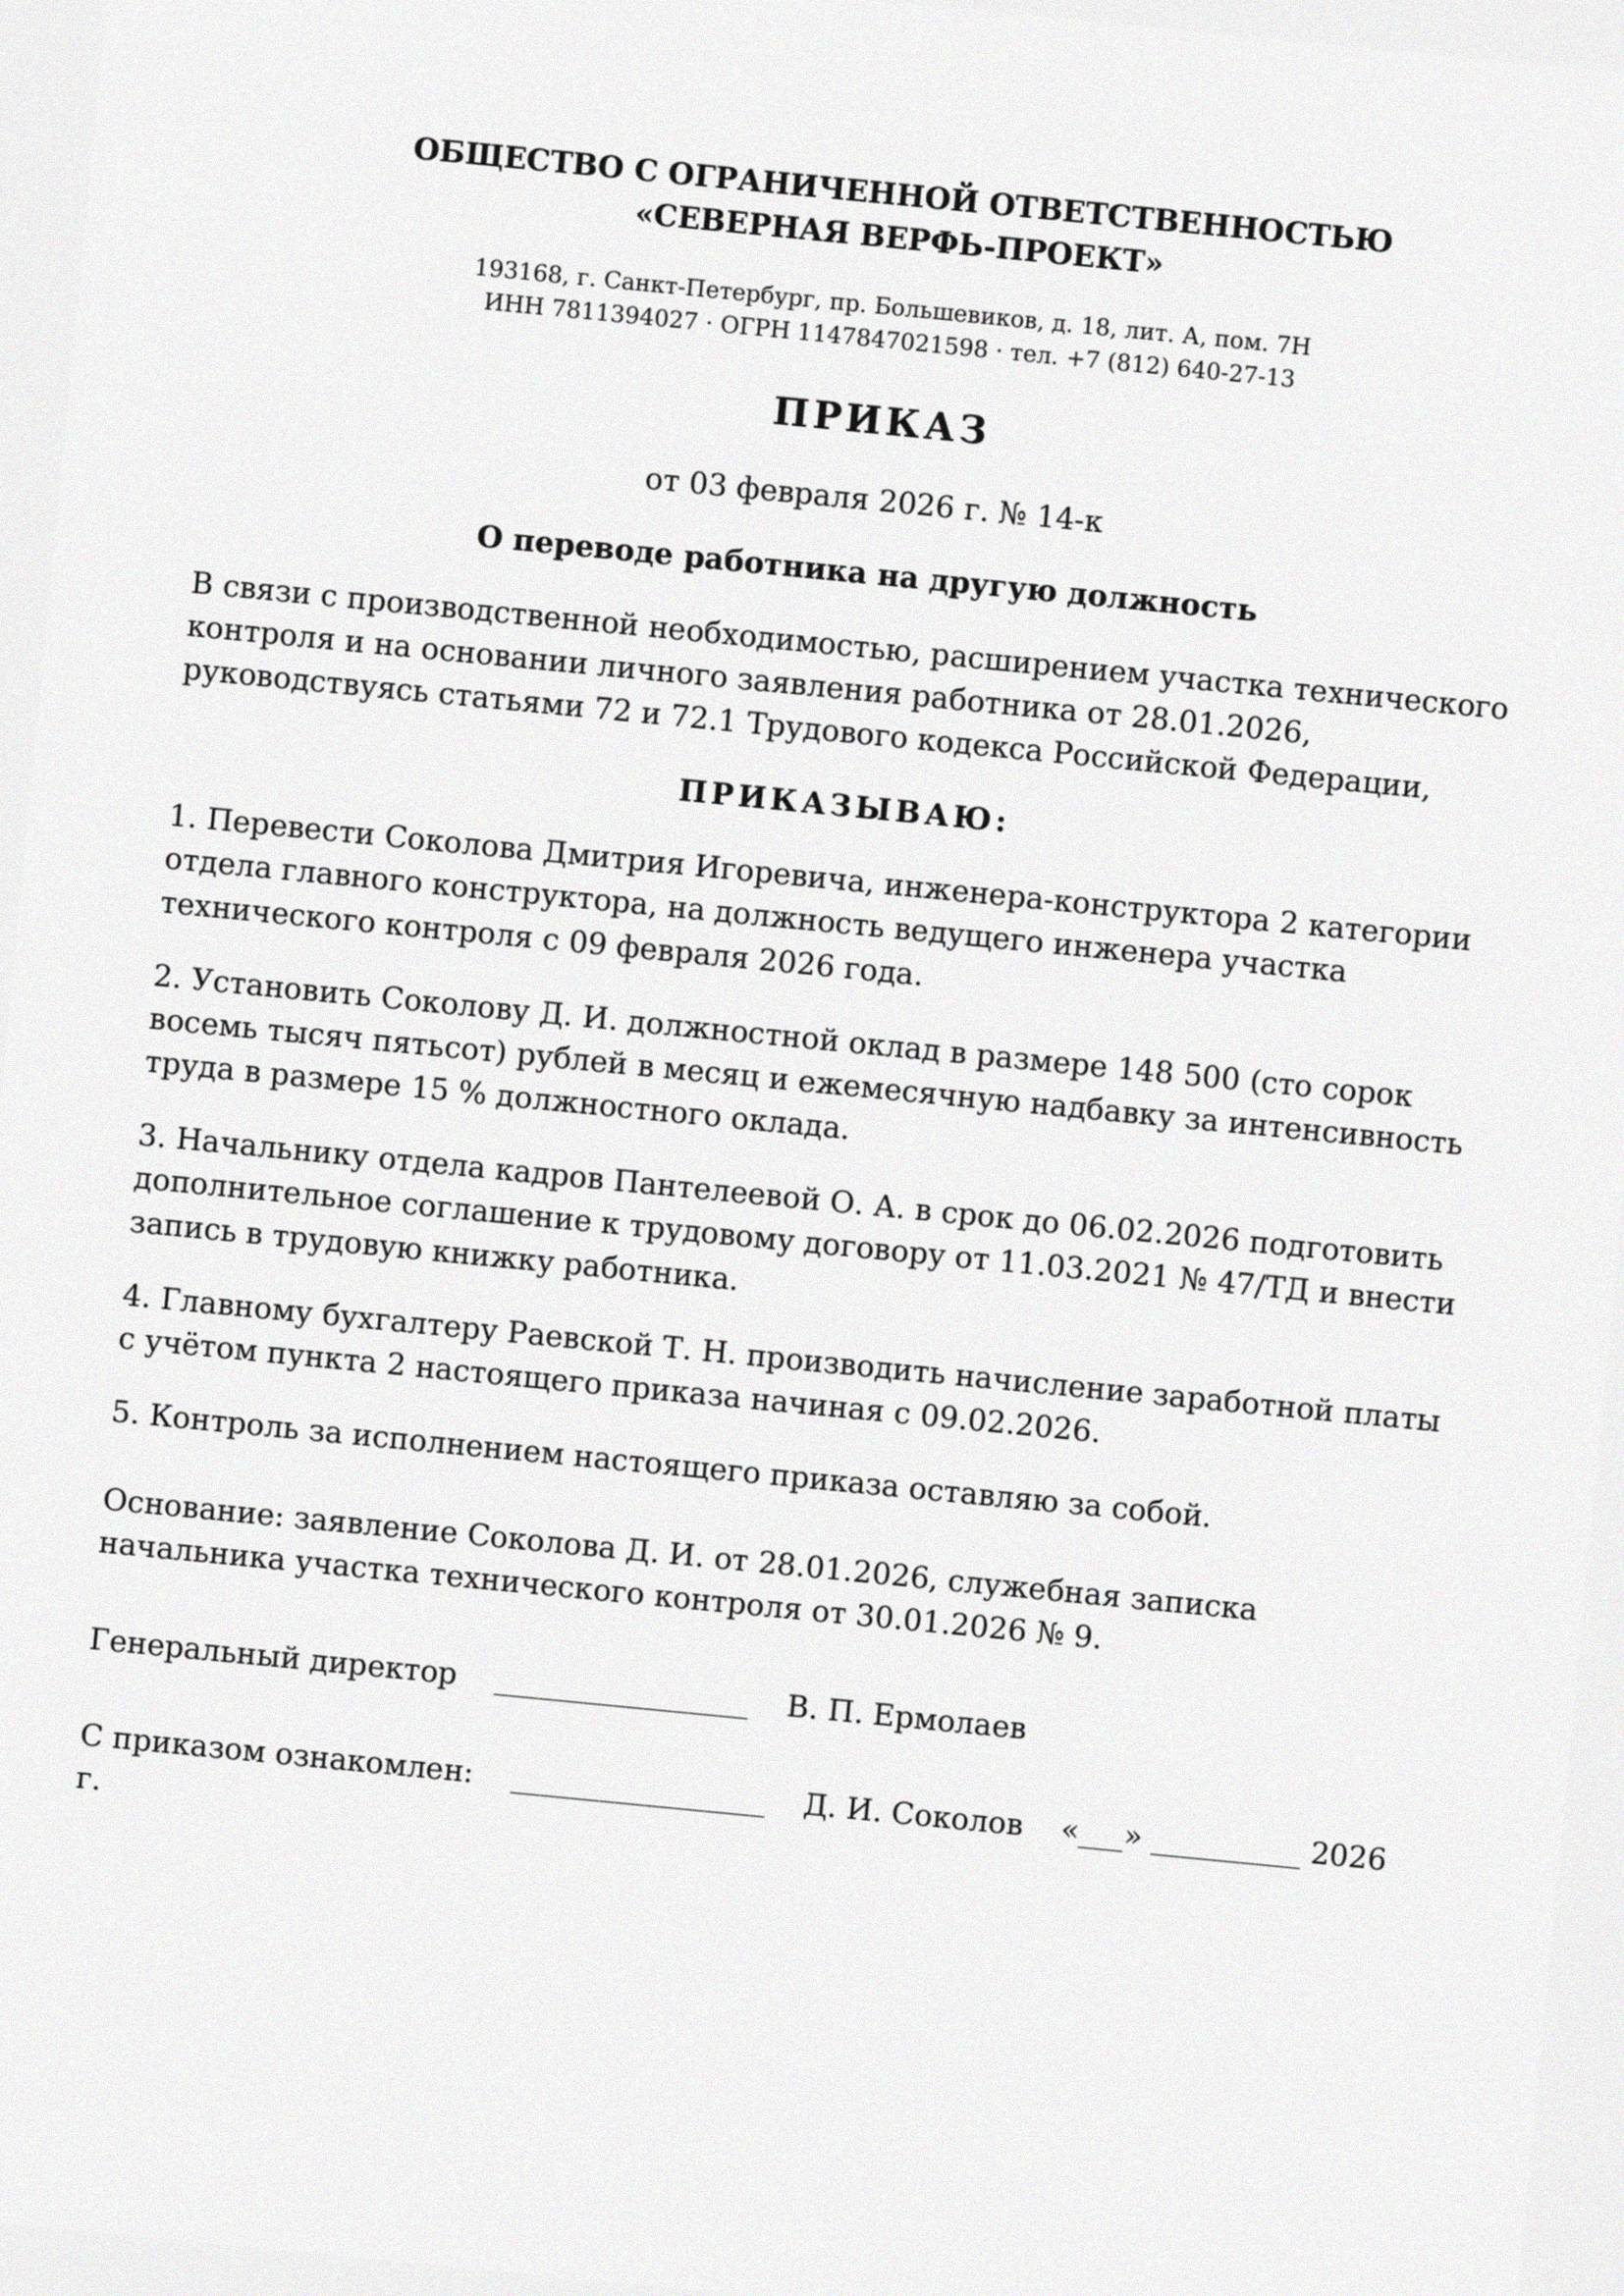
Файл tilted.jpg из примера наклонён на несколько градусов. Блокнот напрямую вызывает ту же функцию deskew и показывает оба изображения:
import numpy as np
from PIL import Image
from occular.deskew import deskew_image

image = np.array(Image.open("tilted.jpg").convert("RGB"))
straight, angle = deskew_image(image)
print("Applied correction:", angle, "degrees")
Фактический вывод:
Applied correction: 5.8 degrees
Обычный OCR уже применяет эту коррекцию; прямой вызов позволяет увидеть её действие на пиксели. Откройте запуск, чтобы сравнить изображение до и после.
Открыть настоящий запуск в Jupyter: весь код виден
Обычно ничего делать не нужно. Коррекция небольшого угла, или deskew, уже включена.
from occular import ocr

text = ocr("tilted-scan.png")Включите определение ориентации страницы:
from occular import ocr

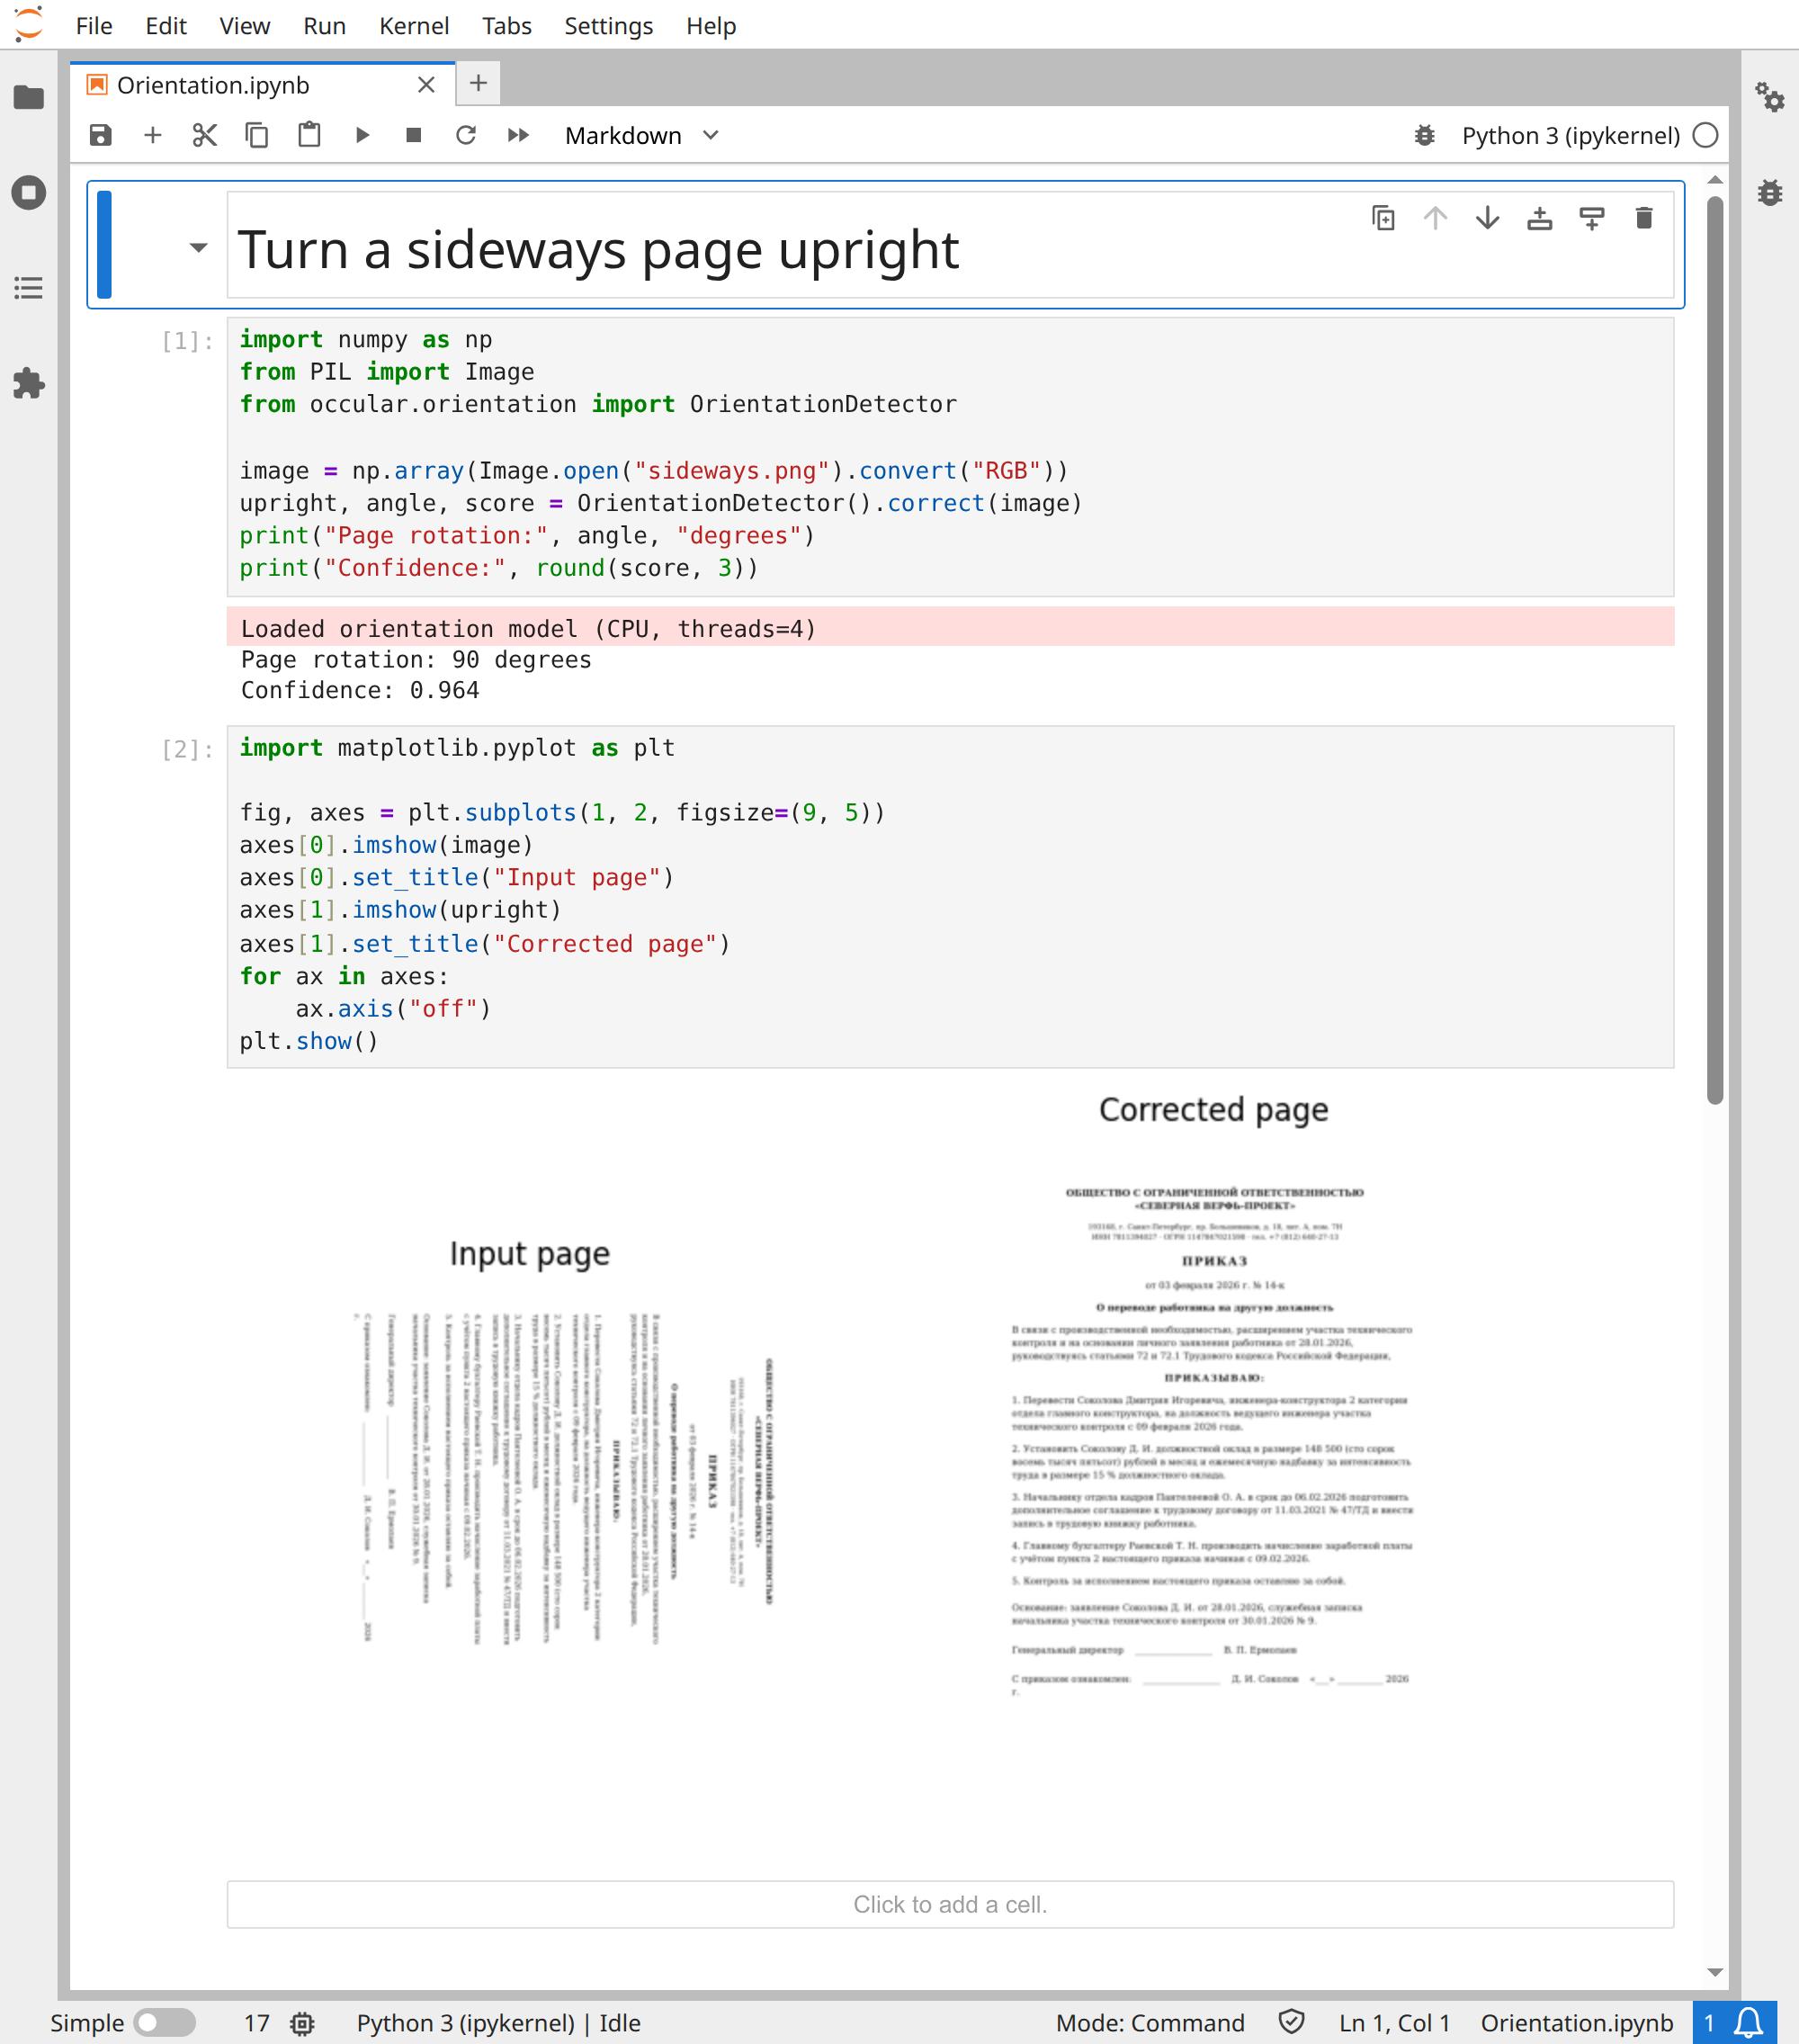
text = ocr("sideways-photo.jpg", orientation=True)Для sideways.png блокнот вызывает модель ориентации и показывает результат коррекции:
import numpy as np
from PIL import Image
from occular.orientation import OrientationDetector

image = np.array(Image.open("sideways.png").convert("RGB"))
upright, angle, score = OrientationDetector().correct(image)
print("Page rotation:", angle, "degrees")
print("Confidence:", round(score, 3))
Фактический вывод:
Page rotation: 90 degrees
Confidence: 0.964
Поворот страницы на 90° — другая задача, чем коррекция наклона на 5.8° выше. Откройте запуск, чтобы увидеть страницу в правильной ориентации.
Открыть настоящий запуск в Jupyter: весь код виден
Скачать блокнот · sideways.png
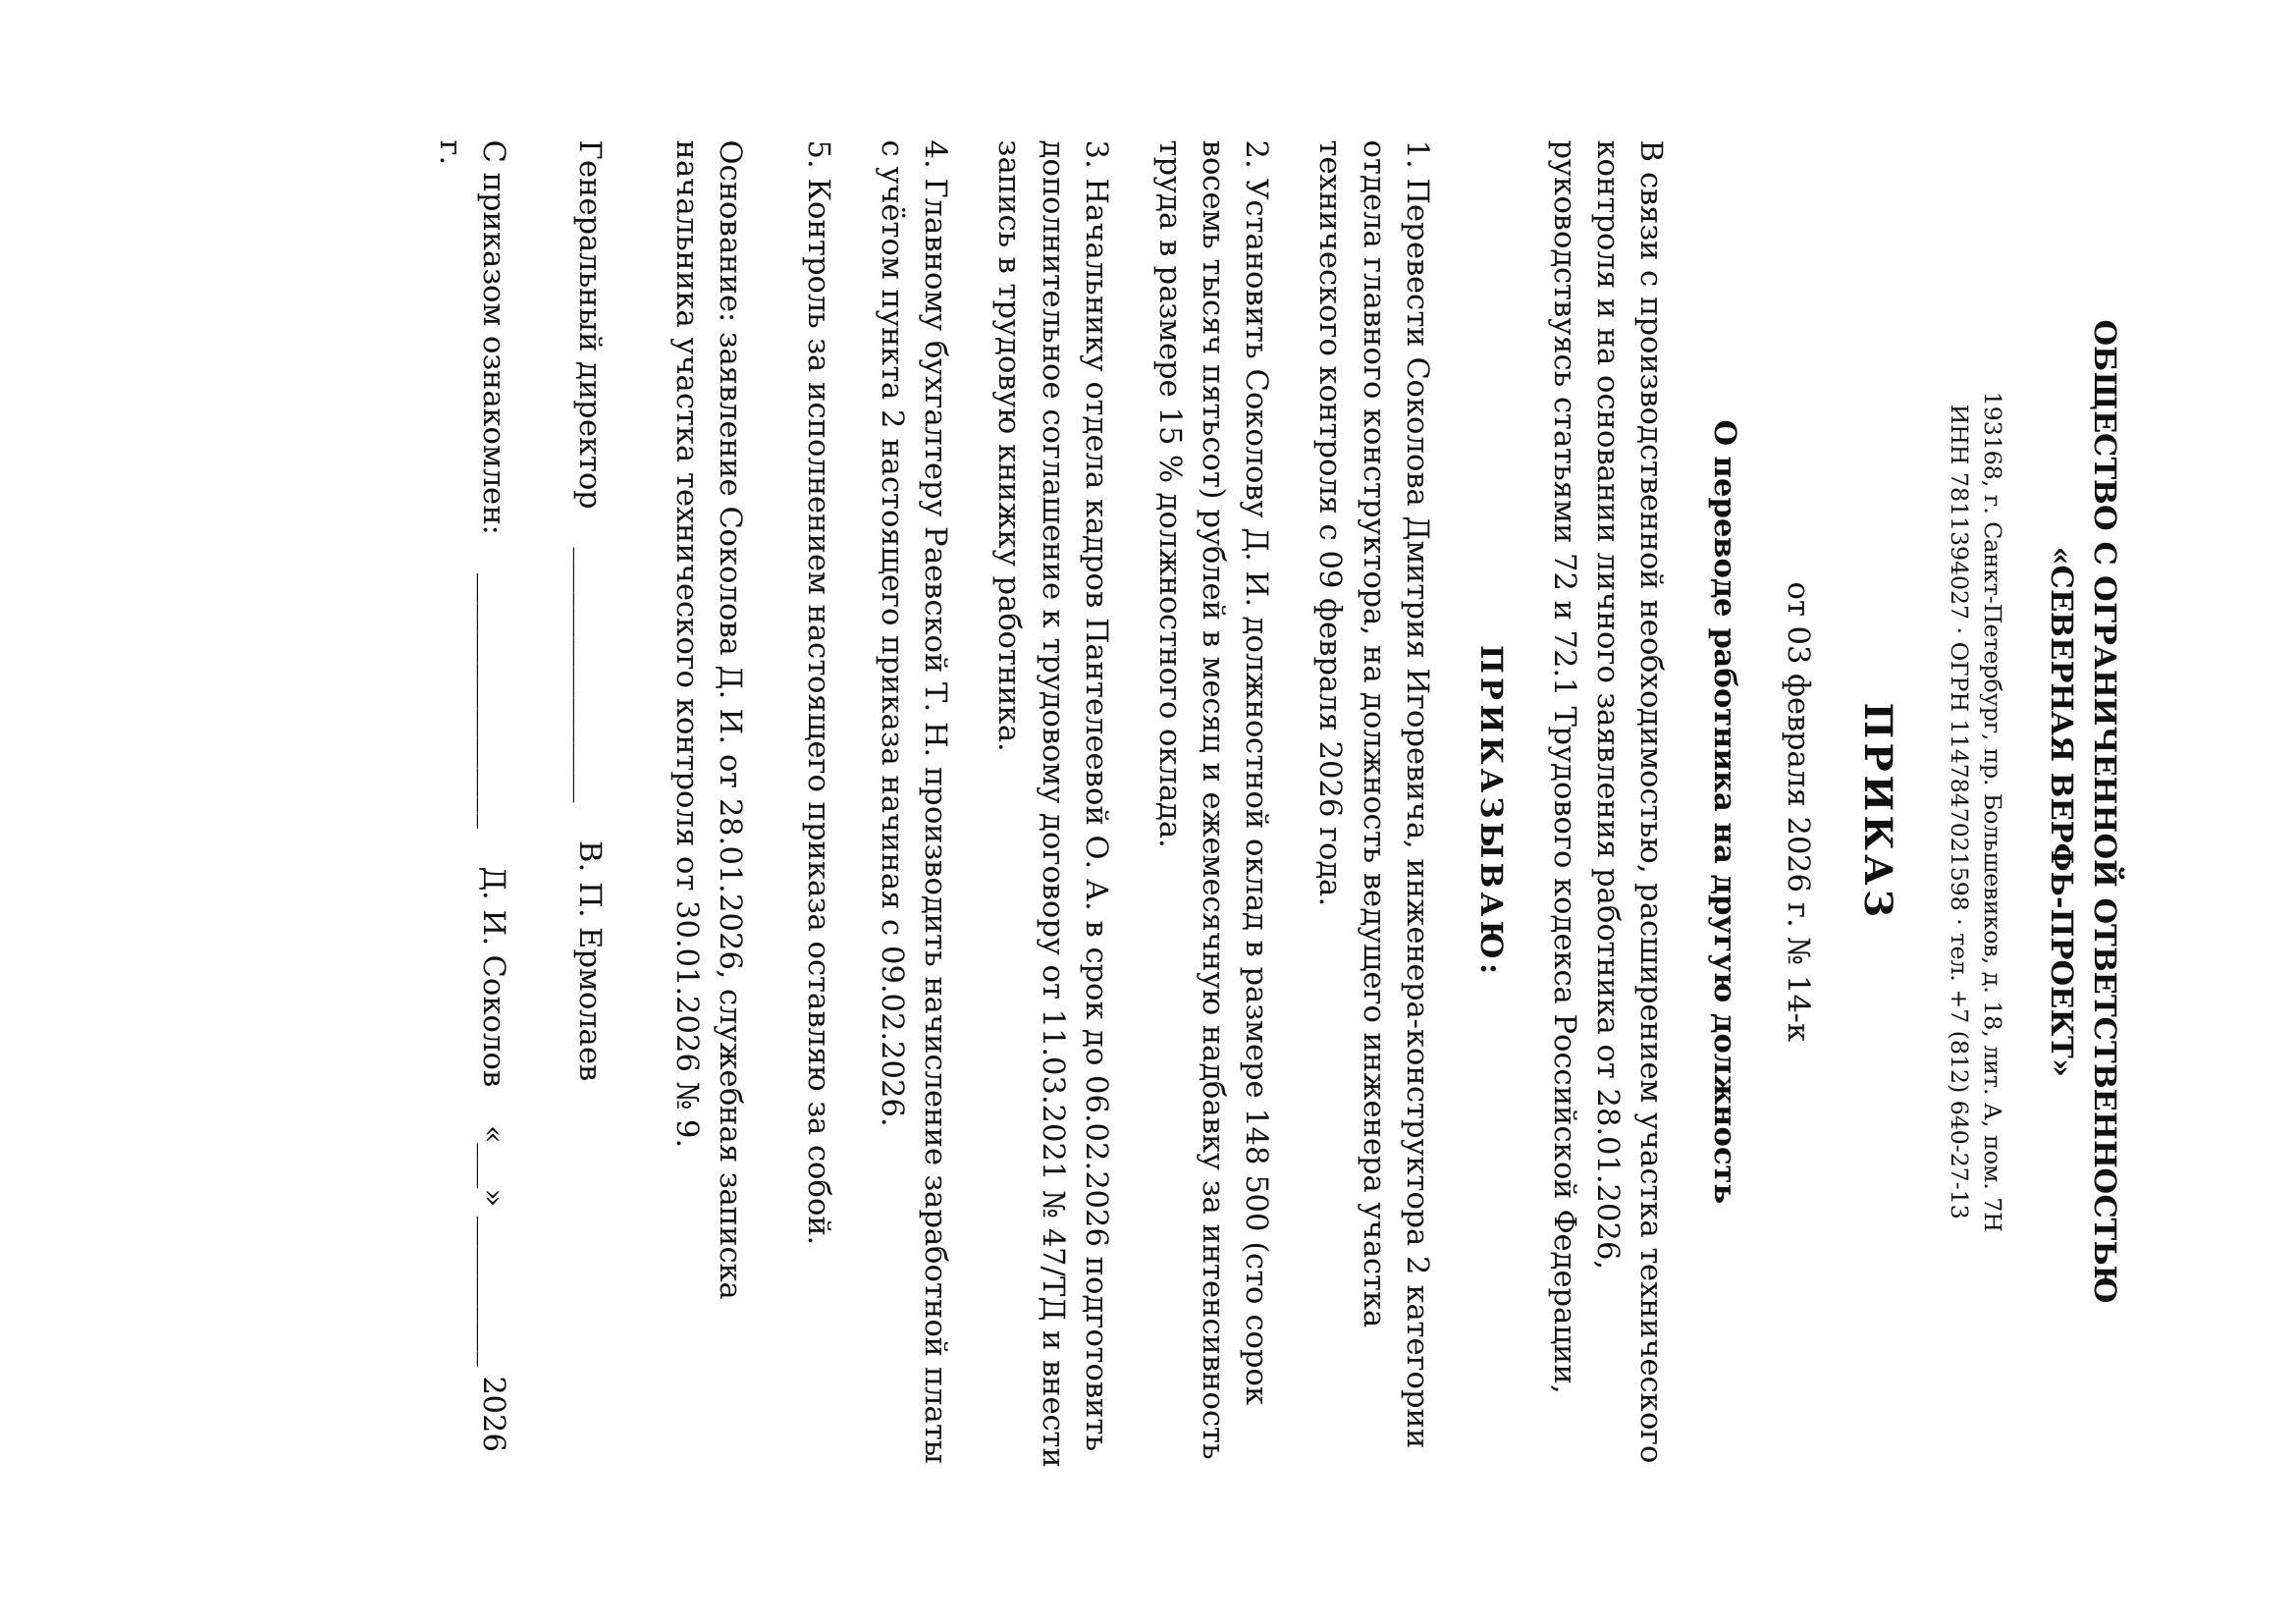
Occular пытается повернуть страницу в правильную ориентацию перед чтением. Если уверенности в направлении недостаточно, страница остаётся как есть.
Попробуйте выравнивание изгиба. Оно пытается распрямить страницу перед чтением:
from occular import OCRPipeline, Settings

reader = OCRPipeline(Settings(unwarp=True))
text = reader.get_text("book-photo.jpg")
print(text)
При этом распознаются исходный и распрямлённый варианты, а затем сравнивается эвристическая оценка по длине текста и уверенности. Распрямлённый вариант выбирается, только если его оценка достаточно выше. Это не измерение точности чтения: обработка занимает больше времени и всё равно может выбрать неудачный вариант. Проверяйте на своих изогнутых страницах.
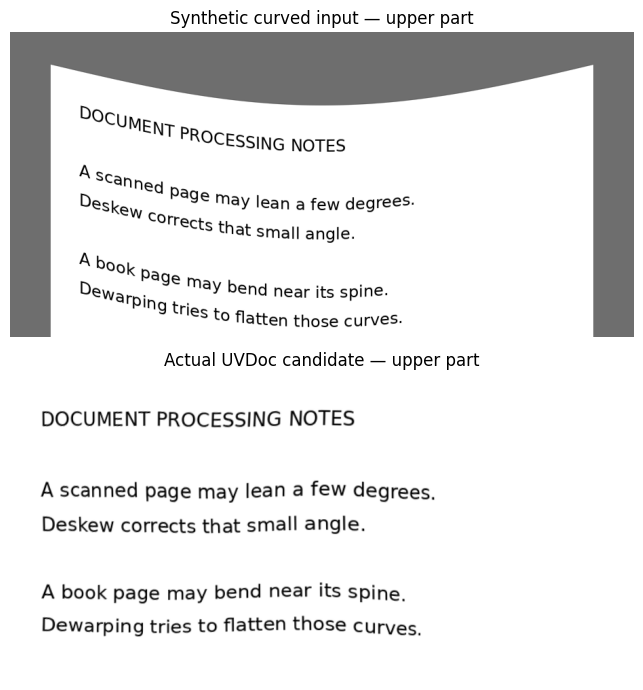
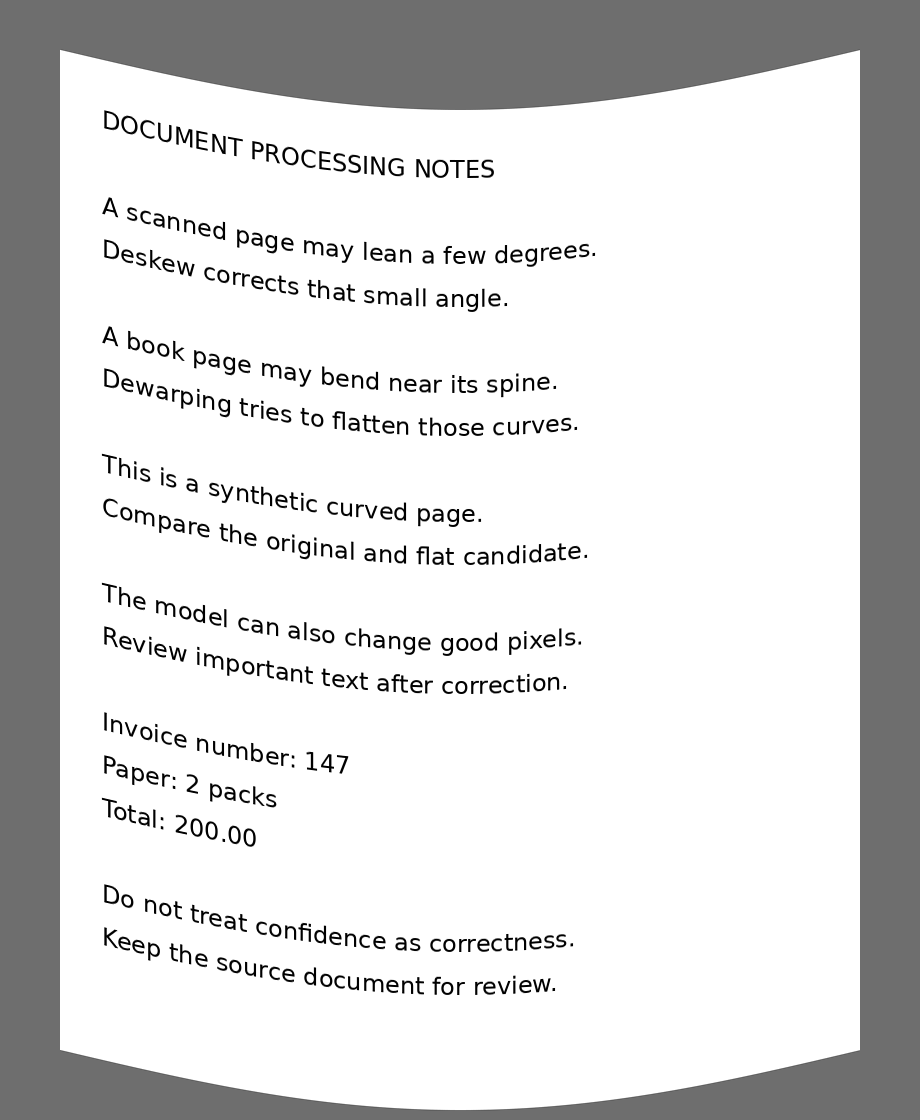
Этот входной пример синтетический: прямой текст изогнут по плавной кривой. Следующий прямой вызов показывает настоящий распрямлённый вариант от той же стандартной модели UVDoc, которую использует unwarp=True:
import cv2
from occular.unwarp_uvdoc import UVDocUnwarper

image = cv2.imread("curved.png")
flat = UVDocUnwarper(model_id="Shivin11/occular-uvdoc").unwarp(image)
print("Input and candidate dimensions:", image.shape, flat.shape)
Блокнот показывает верхнюю часть каждого изображения обычным Matplotlib. Заголовок и строки текста становятся почти горизонтальными; выходные пиксели не ретушировались вручную:
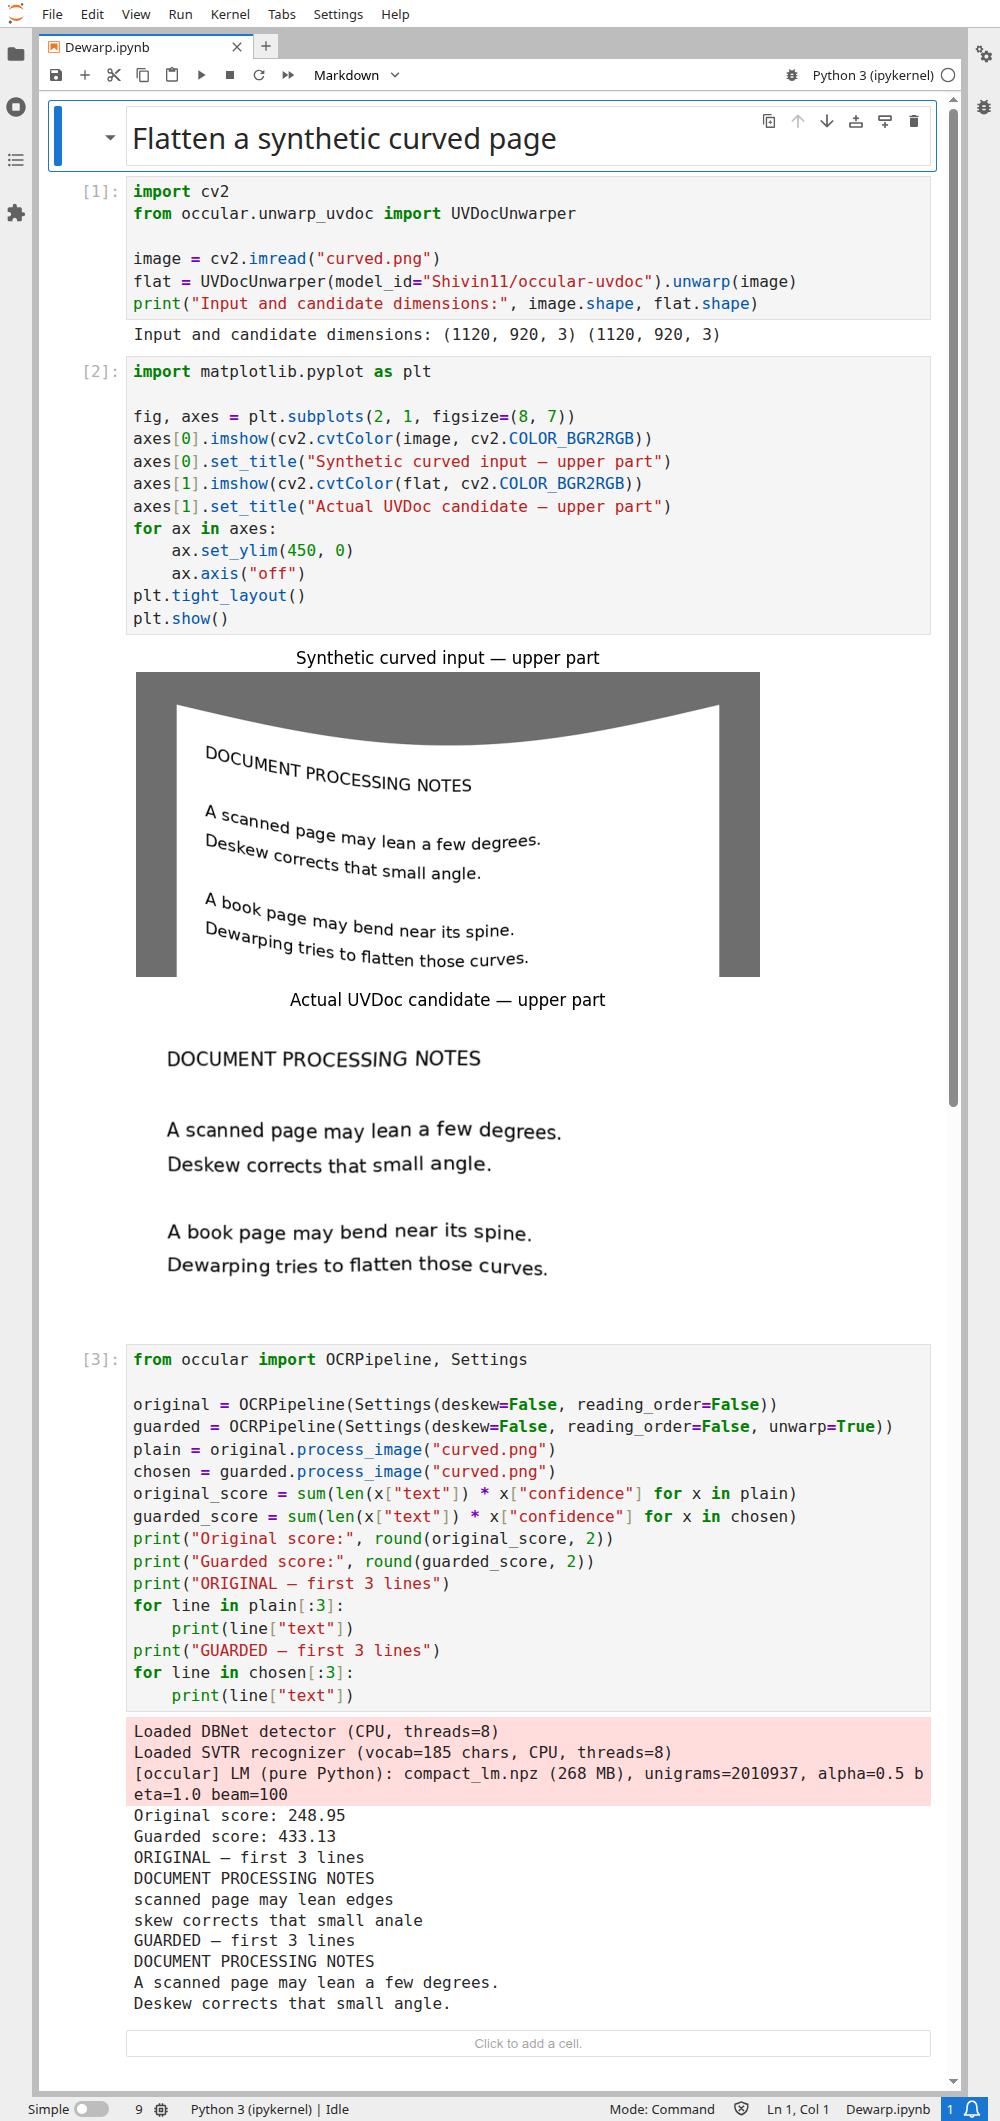
Видимое выравнивание ещё не доказывает правильность текста. Запустите и обычный конвейер с проверкой двух вариантов; deskew=False позволяет отдельно оценить выравнивание изгиба:
from occular import OCRPipeline, Settings

original = OCRPipeline(Settings(deskew=False, reading_order=False))
guarded = OCRPipeline(Settings(deskew=False, reading_order=False, unwarp=True))
plain = original.process_image("curved.png")
chosen = guarded.process_image("curved.png")
original_score = sum(len(x["text"]) * x["confidence"] for x in plain)
guarded_score = sum(len(x["text"]) * x["confidence"] for x in chosen)
print("Original score:", round(original_score, 2))
print("Guarded score:", round(guarded_score, 2))
print("ORIGINAL — first 3 lines")
for line in plain[:3]:
    print(line["text"])
print("GUARDED — first 3 lines")
for line in chosen[:3]:
    print(line["text"])
Фактический вывод:
Original score: 248.95
Guarded score: 433.13
ORIGINAL — first 3 lines
DOCUMENT PROCESSING NOTES
scanned page may lean edges
skew corrects that small anale
GUARDED — first 3 lines
DOCUMENT PROCESSING NOTES
A scanned page may lean a few degrees.
Deskew corrects that small angle.
Оценка в режиме с проверкой выросла с 248.95 до 433.13, поэтому стандартное сравнение выбрало распрямлённый вариант. Его первые строки также прочитаны точнее, если сверить их с исходным изображением. Эти числа отражают эвристику версии, а не точность или калиброванную уверенность; синтетический пример не показывает качество на настоящих фотографиях книг.
Открыть настоящий запуск в Jupyter: весь код виден
Блокнот · curved.png · Запустить эти примеры
Для PDF: в версии 0.5.1 ориентация и выравнивание изгиба работают через обработку изображений. Сначала отрисуйте страницы PDF в изображения →
Больше настроек: отключить deskew или всегда выравнивать изгиб
Вызов ocr("scan.png", deskew=False) отключает стандартную коррекцию наклона. Вместе с ней отключается обработка ориентации отдельных строк.
OCRPipeline(Settings(unwarp="always")) пропускает сравнение исходного и распрямлённого вариантов. Используйте его, только проверив пользу на своих изображениях: на ровных сканах результат может ухудшиться.