Repository navigation
Getting started RU
🌐 English · Русский
Превратите изображение документа в текст, который можно скопировать, найти поиском или сохранить. Для изображения возвращается строка, для PDF — по одной строке на страницу.
Выполните эту команду в Python-окружении проекта. Matplotlib нужен для показа изображения из примера:
python -m pip install "occular-ocr==0.5.1" matplotlibПервый вызов OCR скачивает файлы моделей, поэтому ему нужен интернет. Следующие вызовы используют их повторно. Эти страницы описывают версию 0.5.1; файлы моделей могут меняться независимо от пакета. Для развёртывания с фиксированными версиями см. воспроизводимость без интернета.
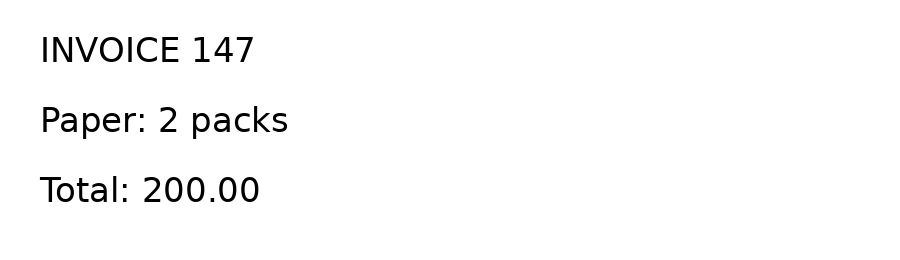
Скачайте sample.png в текущую рабочую папку. В Python или Jupyter:
import matplotlib.pyplot as plt

plt.figure(figsize=(8, 3))
plt.imshow(plt.imread("sample.png"))
plt.axis("off")
plt.show()
from occular import ocr
text = ocr("sample.png")
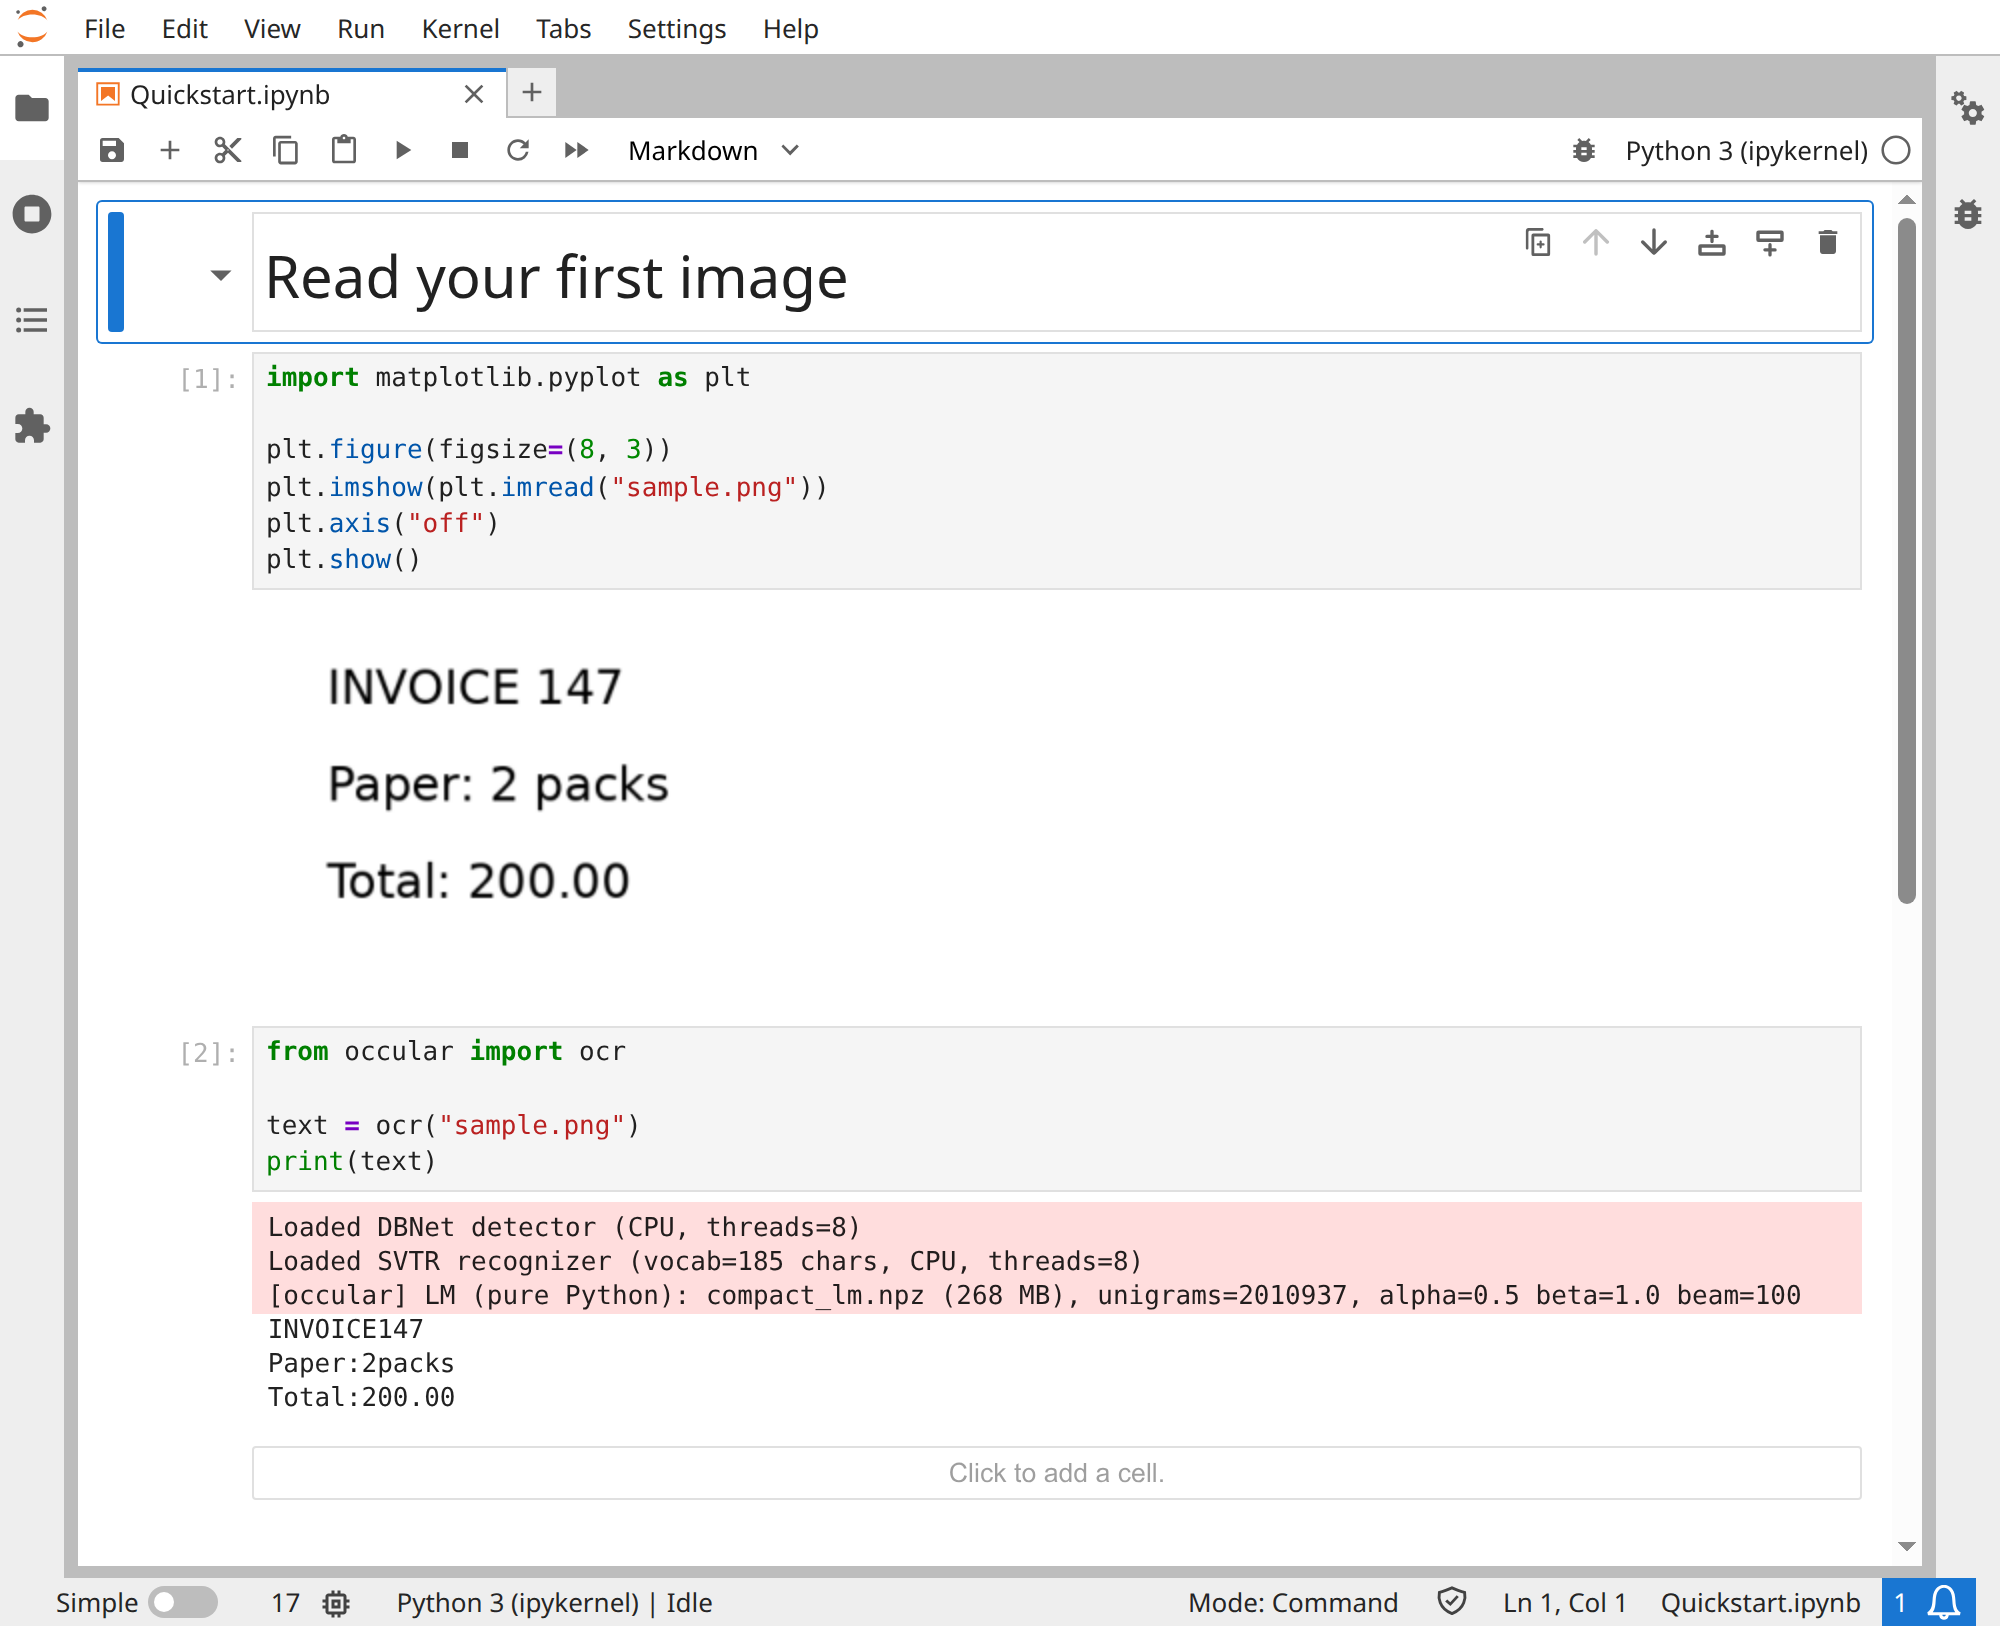
print(text)Фактически возвращённый текст без сообщений о загрузке моделей:
INVOICE147
Paper:2packs
Total:200.00
Пропущенные пробелы в INVOICE147 и Paper:2packs — настоящие ошибки OCR. Сверяйте важные значения с изображением. Русский и английский поддерживаются по умолчанию.
Открыть настоящий запуск в Jupyter: весь код виден
from pathlib import Path
from occular import ocr

Path("result.txt").write_text(ocr("sample.png"), encoding="utf-8")
В текущей папке появится result.txt. Для PDF перейдите к примеру с PDF: вместо распознавания изображения страницы может извлекаться уже имеющийся текст.
На каждой странице о функции есть ссылки на её блокнот и входной файл. Чтобы получить весь комплект:
- Скачайте ZIP с примерами и распакуйте в папку.
- В этой папке установите зависимости блокнотов и запустите Jupyter:
python -m pip install "occular-ocr==0.5.1" jupyterlab matplotlib
python -m jupyterlab- Откройте блокнот и выполняйте ячейки по порядку. Держите входные файлы рядом с блокнотом и не меняйте имена, указанные в коде. В ZIP есть README и все входные файлы;
Simple-OCR.ipynbиспользуетreceipt.jpg.
Пакет устанавливает NumPy, Pillow и PyMuPDF, которые нужны в примерах. Для блокнота с GPU дополнительно нужна настройка GPU. Обычным Python-скриптам достаточно Occular; Matplotlib и Jupyter нужны для примеров с иллюстрациями. Все ячейки с кодом видны; используются обычные Matplotlib и print().
Если установка не удалась, попробуйте чистое окружение Python 3.11 или 3.12 с совместимыми готовыми пакетами ONNX Runtime. Ошибки импорта и загрузки моделей разобраны в решении проблем.