Repository navigation
Languages RU
🌐 English · Русский
Для документа на поддерживаемом языке с кириллицей можно выбрать соответствующий распознаватель и настройки декодирования, вместо того чтобы считать все строки русскими или английскими.
Установите 0.5.1 и скачайте примеры.
Русский и английский работают по умолчанию. Для другого поддерживаемого языка укажите Occular, какой язык ожидать:
from occular import ocr

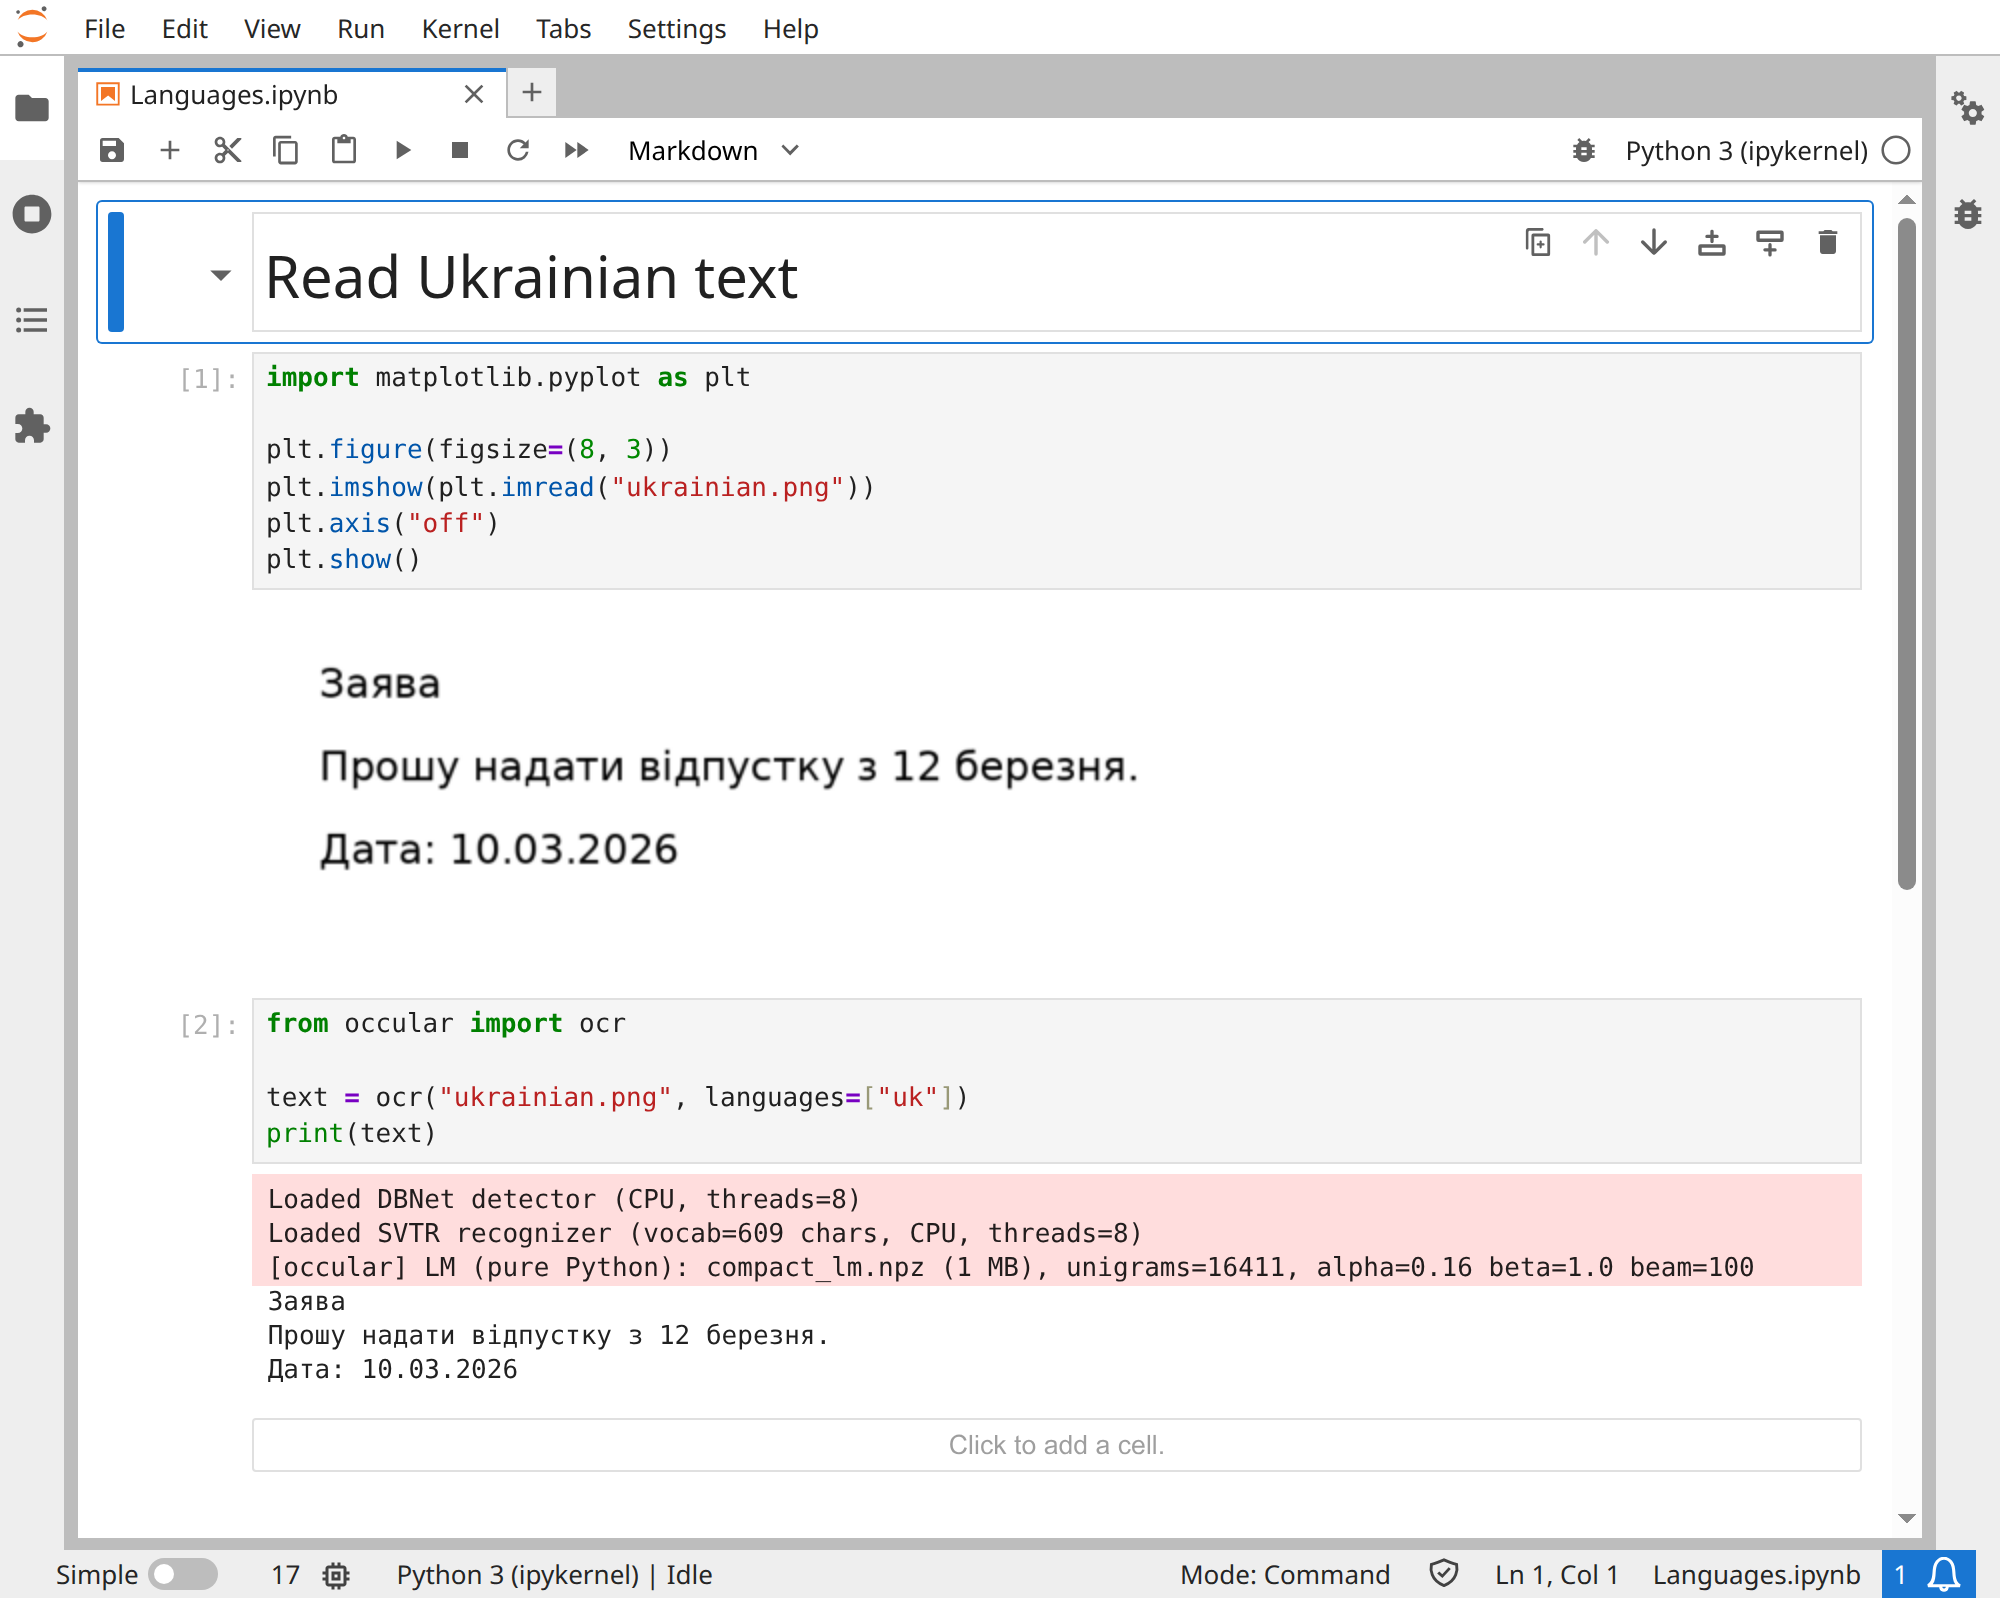
text = ocr("ukrainian.png", languages=["uk"])
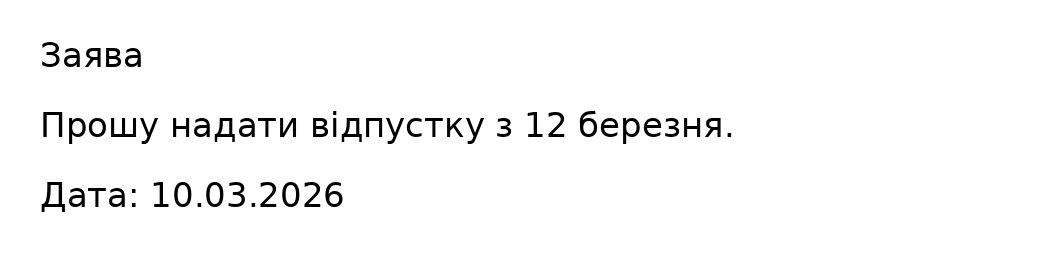
print(text)По ссылке доступно синтетическое заявление на украинском. С languages=["uk"] код выше возвращает:
Заява
Прошу надати відпустку з 12 березня.
Дата: 10.03.2026
Сравните написание с исходным изображением в настоящем запуске ниже. Код языка выбирает путь распознавания, а не переводит текст.
Открыть настоящий запуск в Jupyter: весь код виден
Скачать блокнот · ukrainian.png
from occular import ocr

text = ocr("mixed.png", languages=["ru", "kk"])
Occular пытается выбрать язык для каждой строки. Если языки заранее неизвестны, используйте languages="auto".
Если язык известен, укажите его. Короткие строки и близкие языки сложнее различать автоматически.
| Язык | Код | Язык | Код |
|---|---|---|---|
| Русский | ru |
Английский | en |
| Башкирский | ba |
Белорусский | be |
| Болгарский | bg |
Чувашский | cv |
| Казахский | kk |
Киргизский | ky |
| Македонский | mk |
Монгольский | mn |
| Сербский | sr |
Таджикский | tg |
| Татарский | tt |
Украинский | uk |
Модель дополнительных языков читает кириллицу. Код языка не добавляет поддержку всех письменностей, которыми этот язык может пользоваться.
Из терминала: ocr document.png --lang uk. Несколько кодов в CLI разделяются запятыми: --lang ru,kk. В Python используйте список, как в примере выше.